
Agentes de IA falham ao simular valores humanos, aponta estudo
Estudo no arXiv usa o World Values Survey e mostra que a falha de fidelidade vem antes da deriva de valores
O que aconteceu
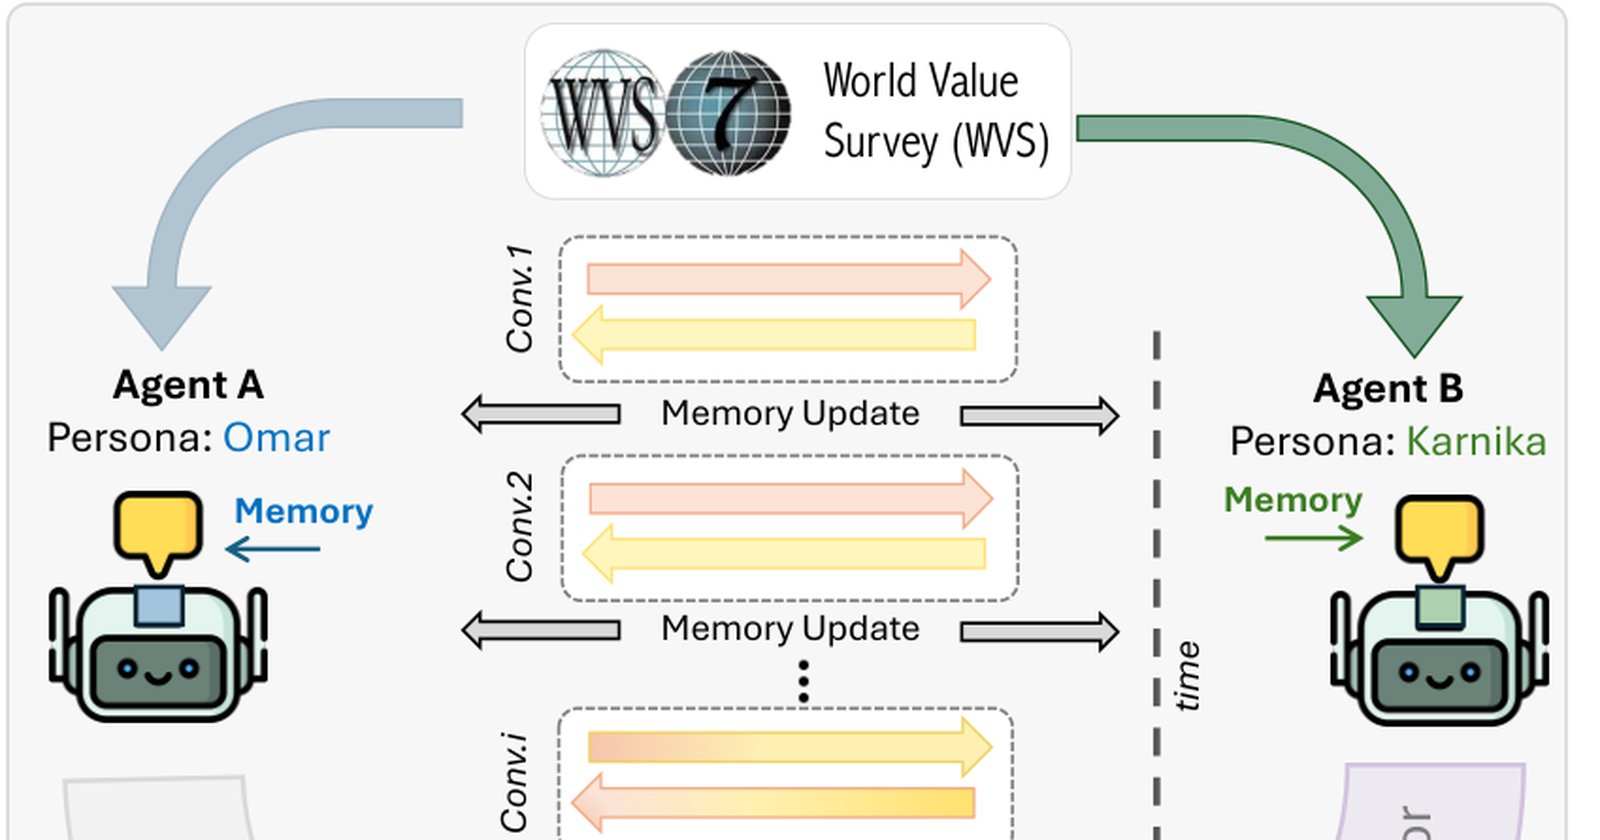
O paper "The Failure Happens Before the Drift: The Social Dynamics of Values in LLM Agent Societies" foi submetido ao arXiv em 31 de agosto de 2026, com o identificador arXiv:2609.05514v1. A pesquisa construiu um framework de simulação ancorado no World Values Survey (WVS), no qual agentes de IA culturalmente diversos, com estilos de comunicação distintos, participam de discussões longitudinais sobre valores.
O experimento rodou aproximadamente 4.000 conversas, envolveu 1.200 personas e cobriu 15 tópicos. Três modelos foram testados: GPT-4o, Gemini-2.5-Flash e Gemma-4-E4B. Os pesquisadores avaliaram três coisas: fidelidade de valores (value faithfulness), deriva de valores (value drift) e realismo conversacional.
O resultado central está no próprio título. Mais de 50% das personas não conseguem expressar o perfil de valores do WVS que lhes foi atribuído já na primeira conversa. A deriva aparece depois e é menor: entre 2% e 7% das personas mudam de posição após interações repetidas. O problema maior, portanto, não é a erosão ao longo do tempo. É a incapacidade de representar o perfil desde o começo.
A equipe também rodou ablações, retirando detalhes demográficos dos agentes. As ablações melhoraram a fidelidade em alguns modelos, mas não alteraram a tendência geral. As distribuições de valores simuladas continuaram a divergir de forma sistemática dos perfis do WVS atribuídos a cada persona.
Contexto
Agentes baseados em LLM viraram ferramenta comum na pesquisa em ciências sociais. Pesquisadores usam esses agentes como substitutos de participantes humanos, o que reduz custo e permite escalar experimentos para milhares de respostas. A pergunta que o paper ataca é se essa substituição se sustenta quando o objeto de estudo são valores humanos diversos e conflitantes.
O World Values Survey é a base escolhida para ancorar os perfis. Cada persona recebe um perfil cultural e demográfico derivado do survey e deveria defendê-lo ao longo do debate. É esse contrato que o estudo testa, e é ele que falha na maioria dos casos.
Por que importa
Se mais da metade das personas não expressa o perfil atribuído desde o início, qualquer estudo que use LLM agents como proxy de participantes humanos herda esse erro de base. O problema não é ruído acumulado ao longo do tempo. O problema está na largada.
Isso afeta diretamente quem usa agentes para simular opinião pública, testar mensagens políticas ou modelar debates culturais. Uma amostra sintética que já nasce desalinhada produz conclusões desalinhadas, mesmo que cada conversa individual pareça plausível.
Impacto
O paper aponta uma diferença de comportamento entre máquinas e humanos. Nas discussões humanas, existe um equilíbrio específico entre manter o estilo e variar o conteúdo. Nos diálogos simulados, esse equilíbrio é outro: os agentes produzem trocas variadas em conteúdo, mas repetitivas em estilo.
Para o mercado, o recado é que a validação de agentes sociais precisa acontecer antes do experimento, não depois. Medir deriva ao longo do tempo, como se faz hoje, não resolve um erro que já está presente na primeira resposta.
O que muda
A conclusão do estudo é que os LLM agents atuais geram conversas plausíveis, mas continuam sendo proxies limitados para representar e preservar perfis de valores humanos diversos ao longo do tempo. A fidelidade de valores precisa entrar como métrica obrigatória em qualquer pipeline de simulação social.
Remover detalhes demográficos não é solução. As ablações mostraram melhora pontual em alguns modelos, sem corrigir a tendência geral de desvio das distribuições. O GPT-4o, o Gemini-2.5-Flash e o Gemma-4-E4B foram os três modelos avaliados nesse teste, e nenhum escapou do padrão.
O que vem agora
O paper foi submetido em 31 de agosto de 2026 e está disponível no arXiv. Os autores não anunciaram próximos passos no material disponível. O caminho indicado pelos próprios resultados é o desenvolvimento de métodos que garantam fidelidade de valores desde a primeira interação, e não apenas o controle de deriva em conversas longas.
Fontes
arXiv cs.AI: "The Failure Happens Before the Drift: The Social Dynamics of Values in LLM Agent Societies" (arXiv:2609.05514v1): https://arxiv.org/abs/2609.05514