
Air Traffic Control Using Large Language Models: Prompt Engineering, Architecture, and Evaluation
Pesquisa com voo em São Francisco mostra que restrições rígidas a LLMs pioram performance, não a melhoram.
O que aconteceu
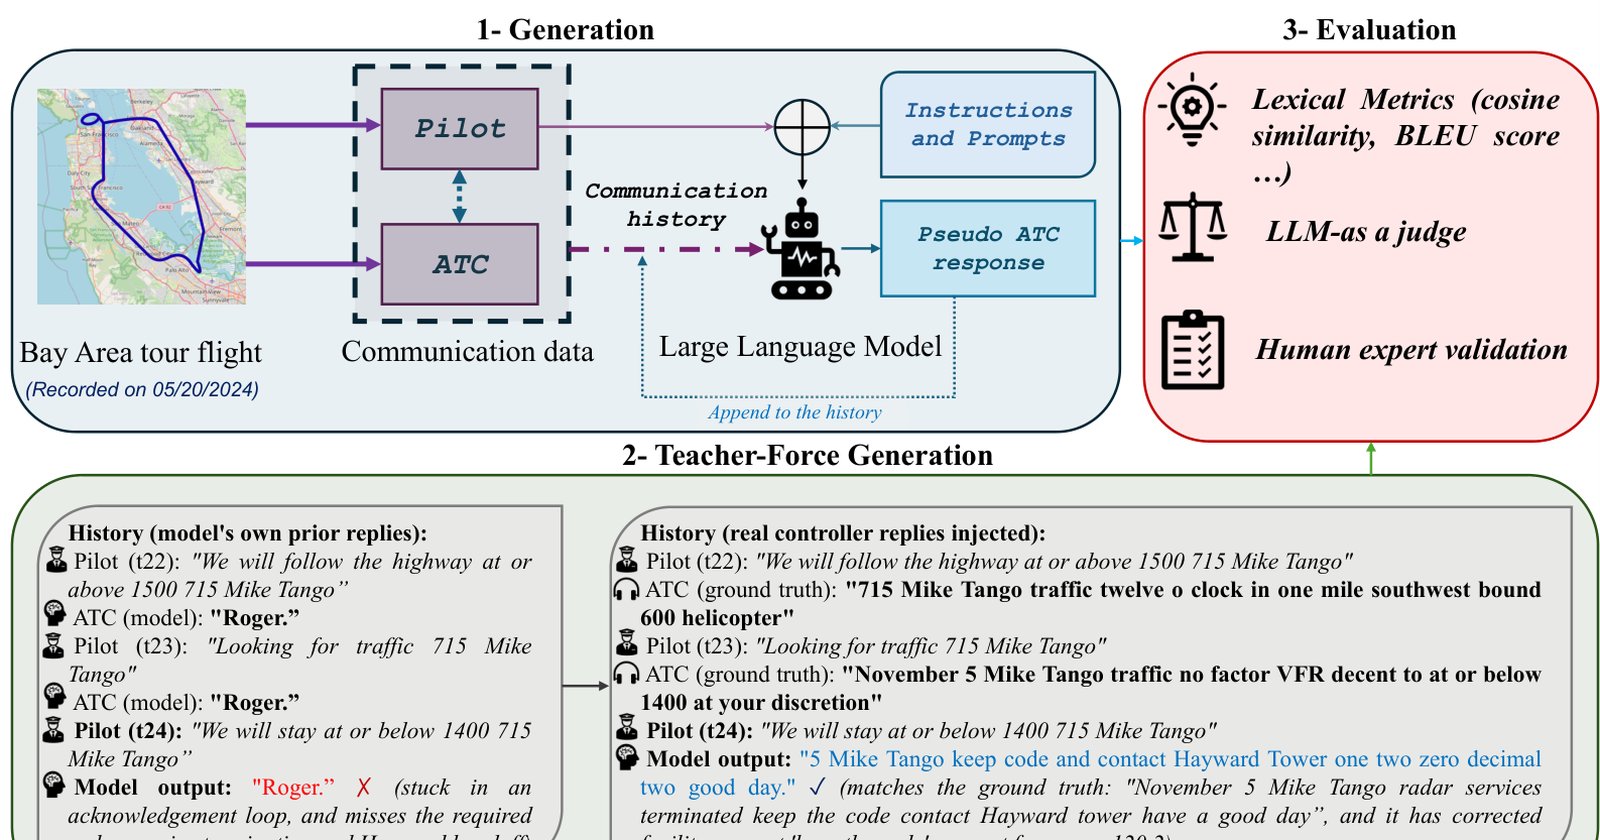
Pesquisadores publicaram um estudo experimental avaliando a capacidade de LLMs em gerar comunicações de tráfego aéreo (ATC) operacionalmente realistas (arXiv, 19/08/2026). O experimento utilizou como "verdade terrestre" (P0) a transcrição manual de um voo real de aviação geral sobre a rota "Bay Tour" de São Francisco.
O time projetou cinco estruturas de prompts (P1 a P5) com graus crescentes de restrição. Esses prompts foram integrados em um pipeline multi-turno com estado, onde o modelo atuava como controlador respondendo a um transcript fixo do piloto, com base no histórico acumulado do diálogo. Foram testados nove LLMs, tanto de código aberto quanto fechados, variando o prompt, a inclusão de um exemplo de transcrição e se o modelo se baseava em suas próprias respostas anteriores ou em um histórico correto inserido.
As respostas foram avaliadas por métricas léxicas, estruturais e semânticas, além de um "juiz LLM" (GPT-5.5) validado contra anotações de especialistas humanos. A principal descoberta: fornecer um exemplo de transcrição melhora a similaridade, mas apertar o prompt não. Os prompts mais leves tiveram melhor desempenho, enquanto o mais restritivo falhou, pois seus próprios erros se acumularam ao longo do diálogo. Injetar o histórico correto reparou essa falha.
Contexto
O controle de tráfego aéreo é um dos diálogos mais críticos e de alta segurança da atividade humana. Enquanto outras partes da gestão do espaço aéreo já foram semi-automatizadas, a comunicação entre torre e pilotos permanece majoritariamente humana. A aplicação de IA nesse domínio enfrenta barreiras enormes de confiabilidade e regulatórias. Este estudo insere-se na pesquisa emergente sobre o uso de LLMs em operações críticas, testando caminhos concretos de implementação e seus limites atuais.
Por que importa
O estudo tem implicações diretas para a aviação e para a segurança de sistemas críticos de IA. Ele demonstra que a abordagem mais intuitiva — criar regras rígidas e scripts detalhados para guiar a IA — pode ser contraproducente em interações longas e complexas. Para empresas de aviação, fornecedores de software e reguladores, o resultado sugere que a "simplicidade" nas instruções e o foco em exemplos de qualidade são caminhos mais promissores do que a engenharia de prompts excessivamente prescritiva.
Impacto
No curto prazo, o estudo desacelera expectativas de uma automação imediata ou ampla na comunicação ATC, reforçando a necessidade humana no circuito. No médio prazo, pode redirecionar esforços de pesquisa e desenvolvimento para arquiteturas que mantenham o histórico correto do diálogo como salvaguarda, em vez de depender exclusivamente da memória do modelo. Para a indústria de IA, serve como um caso de estudo claro sobre como o acúmulo de erros pode colapsar um sistema em operação contínua.
O que muda
A pesquisa muda a compreensia de como engenheiros devem abordar a criação de agentes de IA para diálogos sensíveis. A descoberta de que prompts leves funcionam melhor indica que modelos de linguagem, quando submetidos a muitas restrições, podem perder flexibilidade e precisão em cenários variáveis. Isso influencia o design de futuros sistemas assistidos por IA em qualquer domínio onde o histórico da conversa é crucial e os erros se propagam.
O que vem agora
Os autores delimitam um "caminho concreto e seus limites atuais" para a IA auxiliar no ATC. Os próximos passos óbvios incluem expandir os testes para mais rotas, cenários de tráfego mais densos e diferentes condições de voo. Outro foco será aperfeiçoar os métodos de injeção de histórico correto para prevenir a acumulação de erros em tempo real. A validação com controladores humanos em simulações mais amplas é uma etapa necessária antes de qualquer consideração operacional.