
Aprendizado incremental com proveniência corta retreino de IA
Framework reprocessa apenas 14,7% dos dados e mantém 94,6% dos registros afetados
O que aconteceu
O estudo "Provenance Guided Incremental Learning Under Evolving Concept Definitions" foi disponibilizado em 24 de agosto de 2026 no repositório arXiv, na categoria cs.AI, pelo pesquisador Ismail Lamaakal. O trabalho define um problema chamado rule-induced concept shift, em que a definição de um conceito que gera os alvos de previsão é alterada diretamente. Isso faz com que instâncias antigas mudem de rótulo sem que seus dados observados tenham mudado.
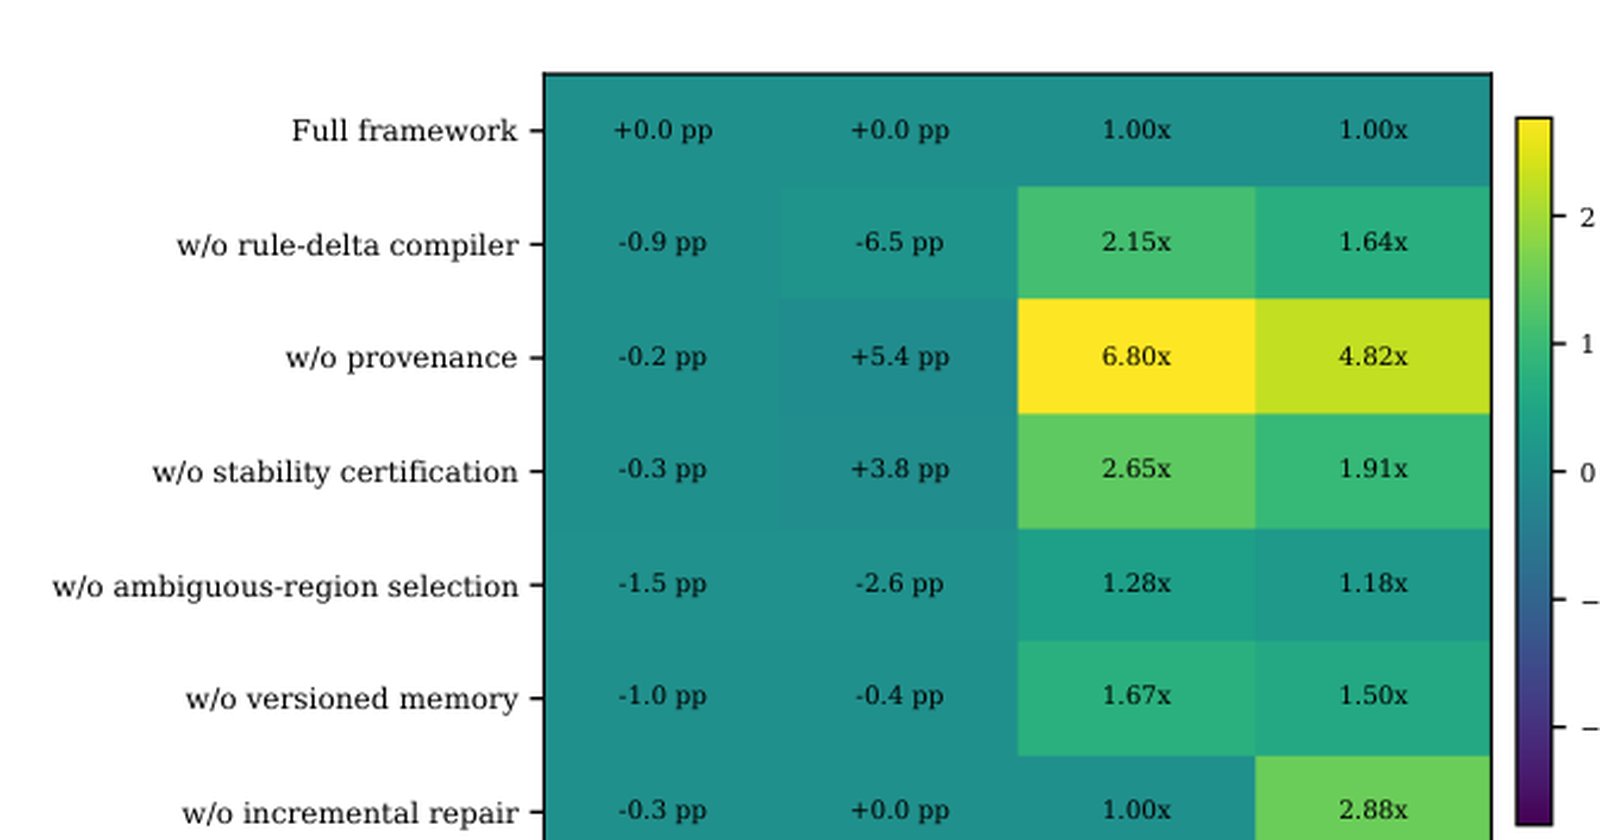
O framework proposto compila definições consecutivas de conceitos em um "rule delta" estruturado, rastreia os componentes alterados por meio de proveniência histórica, certifica registros cujos rótulos continuam válidos e limita a reavaliação a uma região candidata. Revisões executáveis são reclassificadas automaticamente, casos ambíguos são tratados com supervisão seletiva, e as mudanças são usadas para reparo incremental do preditor. Uma memória versionada de conceitos suporta definições recorrentes.
Para validar, os autores criaram o RuleShift-Bench, um benchmark que cobre dados financeiros, demográficos, de cibersegurança e de grafos. O benchmark inclui revisões de conceitos por limiar, predicado, lógica, relacionamento, recorrência e mistas. Nos testes, o reparo guiado por proveniência alcançou 92,3% de acurácia e 90,2% de Macro-F1, reprocessando apenas 14,7% do acervo histórico. A latência média de atualização foi de 179 segundos, contra 993 segundos para reclassificação completa e retreinamento.
Contexto
Sistemas de aprendizado de máquina operando por longos períodos precisam se adaptar a mudanças estatísticas nos dados de entrada, mas também a revisões das definições que geram seus alvos de previsão. Métodos convencionais de concept drift normalmente inferem essas mudanças a partir de observações ou erros de previsão, mesmo quando a política, regra ou consulta subjacente foi explicitamente modificada. O estudo argumenta que, quando essa revisão é explícita, ela pode ser usada como um sinal de manutenção de dados.
A abordagem tradicional de recalcular tudo, reclassificar o histórico e retreinar o modelo, é cara. O framework mostra que é possível localizar o impacto da mudança e preservar o conhecimento que permanece válido. A memória versionada de conceitos, por exemplo, evita reprocessar dados quando uma definição que já apareceu antes volta a ser usada.
Por que importa
Na prática, o método reduz drasticamente o custo de manutenção de modelos em produção. Para se ter uma ideia, a atualização completa leva 993 segundos no conjunto de testes do RuleShift-Bench, enquanto o reparo guiado pela nova técnica leva 179 segundos. Isso representa uma redução de cerca de 82% no tempo de atualização.
Além disso, apenas 14,7% do histórico precisa ser reprocessado. Menos dados reprocessados significa menos processamento computacional e menos tempo de especialistas humanos, já que a supervisão seletiva é limitada a casos ambíguos. O método também manteve 94,6% dos registros afetados, mostrando que a maioria dos rótulos alterados pela nova definição foi corretamente capturada.
Impacto
O impacto imediato é sobre sistemas de IA que dependem de regras de negócio em setores como finanças, demografia e cibersegurança. Uma mudança na regra de concessão de crédito, em uma política de elegibilidade ou em uma consulta de detecção de fraude pode invalidar rótulos históricos. Com o framework, essa invalidação é tratada de forma cirúrgica, sem reclassificar toda a base.
Os números do benchmark indicam que é possível obter 92,3% de acurácia e 90,2% de Macro-F1 mesmo com uma fração pequena do histórico sendo reprocessada. Isso sugere que o uso de proveniência ajuda a distinguir o que realmente mudou. O framework também lida com revisões que envolvem lógica e relacionamentos, não só limiares.
O que muda
Esse trabalho propõe uma inversão de perspectiva. Em vez de inferir mudanças de conceito por sinais indiretos, como erros de previsão, ele parte da revisão explícita da própria definição. O "rule delta" estrutural e o rastreamento de proveniência histórica viram um mecanismo de manutenção de dados.
Com isso, o sistema atualiza apenas o estado de supervisão e a parte do preditor que dependem da mudança. O conhecimento que permanece válido é preservado. Isso é diferente dos métodos convencionais, que normalmente reagem a mudanças estatísticas depois que elas já causaram perda de performance.
O que vem agora
O estudo foi publicado como preprint na versão 1, em 24 de agosto de 2026, e ainda não passou por revisão formal da comunidade. A disponibilização no arXiv permite que outros pesquisadores reproduzam os resultados do RuleShift-Bench ou estendam o benchmark para outros domínios. O código do artigo é arXiv:2608.23893.
No momento, não há informações públicas sobre datas de publicação em conferência ou disponibilização de código. O texto indica que o framework e o benchmark foram projetados para suportar revisões variadas, mas a aplicação em sistemas reais dependerá de novas validações.