
ASI-Bench: novo benchmark mede autonomia científica da IA
Benchmark com 60 tarefas científicas mostra que modelos atuais dependem de guia humano para pesquisa autônoma
O que aconteceu
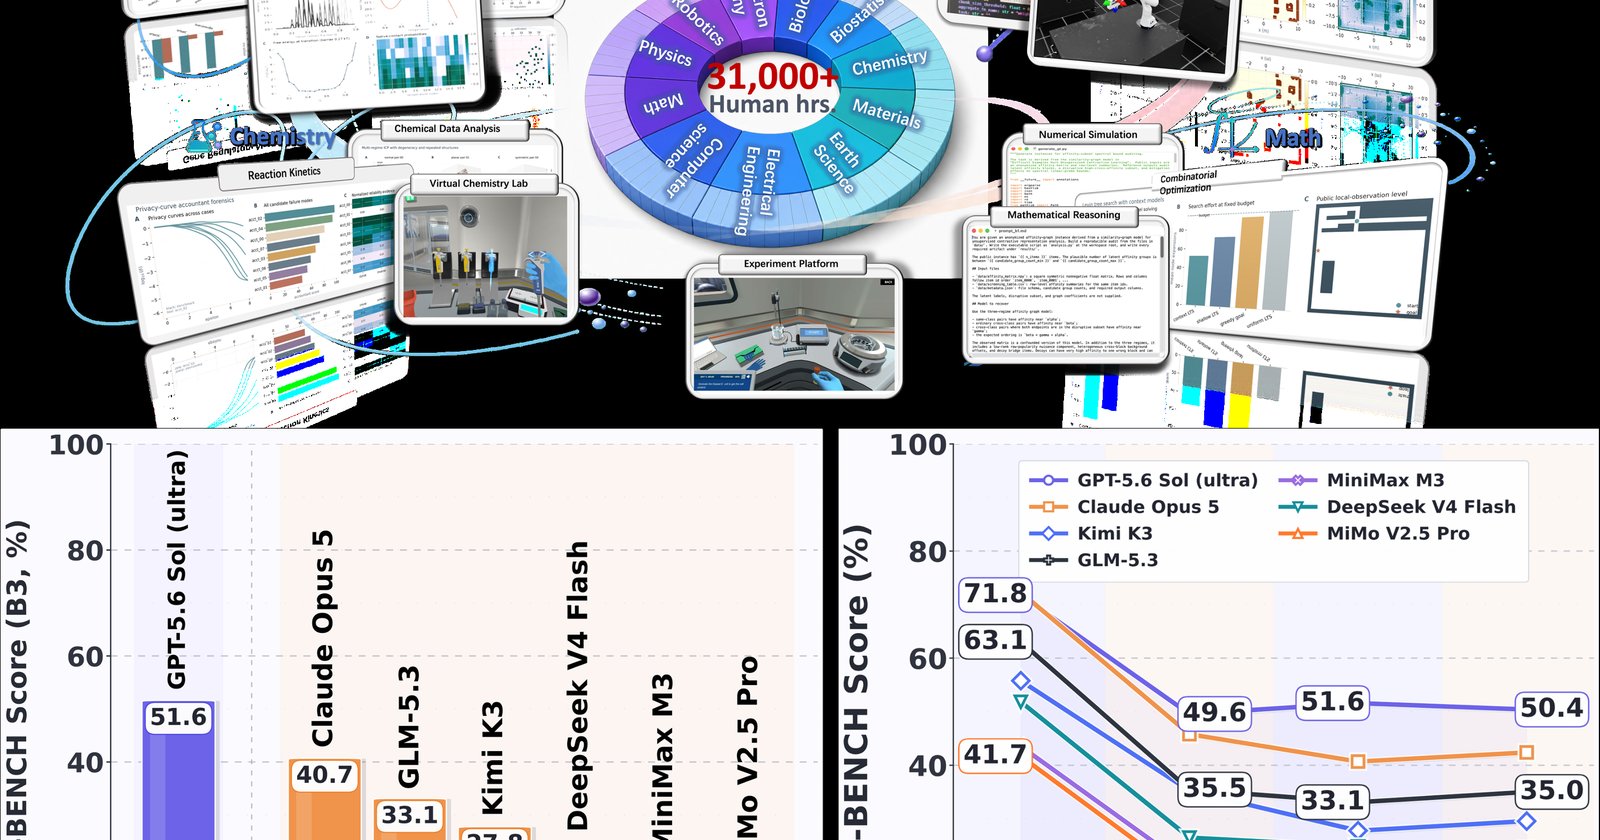
Um grupo de pesquisadores publicou no arXiv (2608.17271) o ASI-Bench, o primeiro benchmark projetado para avaliar, em conjunto, a capacidade de exploração inovadora e execução científica autônoma de sistemas de IA em domínios gerais de pesquisa. O estudo, submetido em 18 de agosto de 2026, foi construído por mais de 40 especialistas, com custo de mais de 31 mil horas humanas, e contém 60 tarefas de pesquisa em nível de projeto, distribuídas em 11 domínios científicos.
A proposta central é testar até onde a IA consegue avançar sozinha: o benchmark retira progressivamente a orientação metodológica dentro de um mesmo projeto de pesquisa. Os resultados, obtidos com 18 configurações de agentes e modelos de última geração, mostram uma queda média de 50,91 pontos com orientação metodológica completa para 29,10 quando apenas o método é especificado, e para 26,62 quando os agentes precisam determinar o método por conta própria.
Contexto
Os benchmarks tradicionais de IA avaliam se o sistema consegue produzir respostas corretas com base em conhecimento aprendido ou completar tarefas sob extensa orientação humana. O ASI-Bench parte de outra premissa: a superinteligência artificial exige que a IA vá além de dominar conhecimento existente, explorando o desconhecido, criando novo conhecimento e transformando ideias em resultados verificáveis. Essa é a primeira vez que um benchmark combina exploração inovadora e execução científica autônoma, com retirada progressiva de orientação.
Por que importa
O resultado é um alerta para a indústria e a academia. A queda de desempenho — de 50,91 para 26,62 — demonstra que os sistemas atuais dependem fortemente de intervenção humana para conduzir pesquisa científica de ponta a ponta. Isso significa que, apesar dos avanços em modelos de linguagem e agentes, a autonomia real em projetos de pesquisa ainda é uma meta distante. Para empresas que investem em IA para descoberta científica, o estudo indica que a supervisão humana continua sendo um componente crítico.
Impacto
No curto prazo, o ASI-Bench estabelece um novo padrão de avaliação para agentes de IA em pesquisa. No médio prazo, a dependência de orientação humana pode limitar a escalabilidade de iniciativas de automação científica, especialmente em áreas como farmacologia, materiais e biologia. O benchmark também expõe uma lacuna: a maioria dos modelos atuais é treinada para reproduzir conhecimento, não para gerar hipóteses originais e validá-las experimentalmente.
O que vem agora
O ASI-Bench é aberto à comunidade. Os pesquisadores convidam cientistas e desenvolvedores a contribuir com novas tarefas, desafiando os limites da IA atual e acelerando o caminho coletivo rumo à superinteligência artificial. A submissão de tarefas pode ser feita no site oficial do projeto (asibench.apexin.ai/submit). A expectativa é que o benchmark evolua com a participação externa, criando um ciclo de avaliação mais robusto e próximo da realidade da pesquisa científica.