
Avaliação de robustez de LLMs em verificação matemática
Pesquisa com GPT-OSS, Qwen3 e Phi-4 mostra que modelos acertam na resposta final, mas erram ao avaliar passos alternativos equivalentes.
O que aconteceu
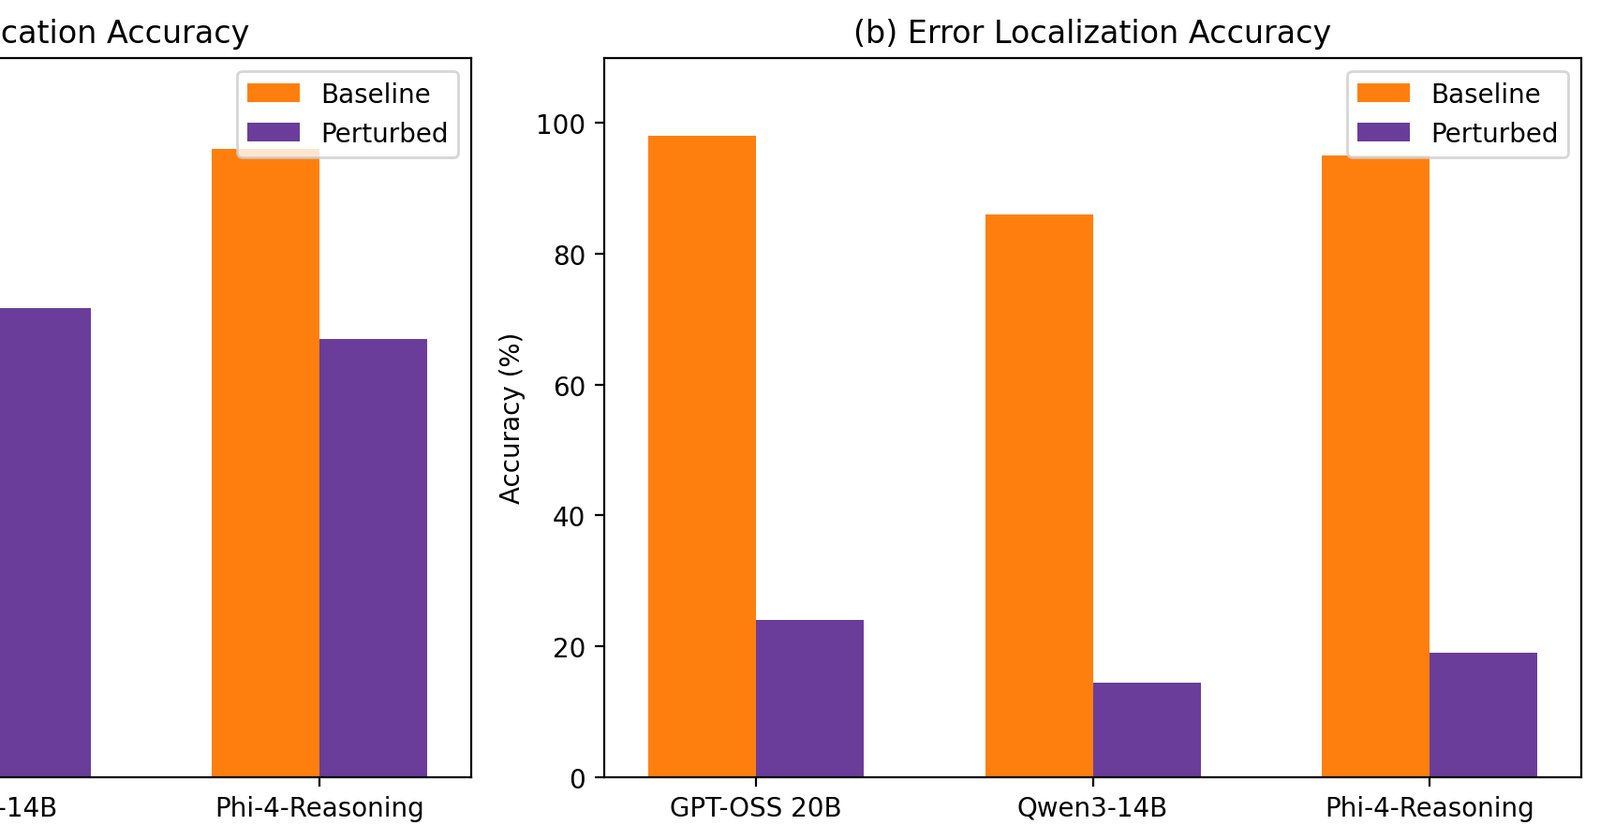
O estudo "Beyond the Answer Key: Robustness Evaluation of Large Language Models for Step-Level Mathematical Verification", disponível no arXiv sob o código 2608.28725, foi submetido em 28 de agosto de 2026 pela pesquisadora Fateme Mazdarani. A pesquisa cria um benchmark controlado com equações lineares para avaliar LLMs no papel de avaliadores, ou seja, modelos que precisam julgar se uma solução apresentada é correta, se cada passo é válido e identificar o primeiro passo incorreto. O teste vai além do "gabarito" tradicional, que apenas compara a resposta final.
Foram testados três modelos abertos: GPT-OSS 20B, Qwen3-14B e Phi-4-Reasoning. Em soluções canônicas (o formato usual de resolução), os modelos apresentam bom desempenho. Porém, quando as mesmas soluções são apresentadas de forma perturbada, mas logicamente equivalente, a performance em verificação de passos cai drasticamente. Nas soluções válidas perturbadas, a taxa de falsa rejeição dos modelos base (sem ajuste fino) ficou entre 75,6% e 85,3%. Isso significa que os modelos rejeitam como incorretas a esmagadora maioria das resoluções que estão certas, apenas por não seguirem o padrão que aprenderam.
O paper ainda testa estratégias de mitigação, como fine-tuning supervisionado, destilação e aumento de compute no momento do teste. Em alguns cenários, essas técnicas melhoram a robustez, mas os ganhos são dependentes do modelo e podem reduzir o desempenho em soluções canônicas.
Contexto
O uso de LLMs como avaliadores, verificadores e auditores de processo cresceu nos últimos anos, impulsionado por aplicações em educação, código e ciência. No campo da matemática, a maioria das avaliações tradicionais se concentra na acurácia da resposta final, ignorando se o modelo consegue entender o raciocínio passo a passo. O estudo aponta que essa ênfase no "answer key" (gabarito) pode mascarar a incapacidade dos modelos de verificar trilhas de solução válidas que não seguem a forma canônica.
O problema é relevante porque, na prática, alunos e usuários frequentemente resolvem equações de maneiras não padronizadas. Se um sistema de IA é usado para corrigir provas ou dar feedback, rejeitar soluções corretas por causa do formato gera resultados injustos e inúteis. Além disso, em sistemas de auditoria de processos, como verificação de código ou provas formais, um falso negativo pode passar despercebido.
Por que importa
O resultado mostra que a confiança cega na capacidade avaliativa dos LLMs é perigosa. Os números de 75,6% a 85,3% indicam que os modelos base falham na maioria dos casos quando o formato muda, mesmo com conteúdo matematicamente idêntico. Isso tem implicações diretas para plataformas educacionais que usam IA para corrigir exercícios, para ferramentas de verificação de provas matemáticas e para qualquer sistema que dependa de validação passo a passo.
A pesquisa também sugere que a robustez como avaliador deve ser medida separadamente da capacidade de resolver problemas. Um modelo pode acertar 90% das respostas finais e mesmo assim ser péssimo para julgar trabalhos alheios. Essa distinção é crucial para o desenvolvimento de benchmarks e para a escolha de modelos em aplicações reais.
Além disso, as técnicas de melhoria testadas, como fine-tuning e destilação, não eliminam o problema de forma consistente. Em alguns casos, melhoram a robustez em soluções perturbadas, mas pioram o desempenho nas canônicas, criando um trade-off.
Impacto
No curto prazo, o estudo deve pressionar equipes de desenvolvimento de LLMs a incluir avaliações específicas para o papel de avaliador, com foco em variações válidas de solução. No médio prazo, é possível que vejamos novos benchmarks e métricas que considerem a robustez a perturbações lógicas, além da simples acurácia final.
Para o contexto brasileiro, a pesquisa tem relevância direta no uso crescente de IA em plataformas de educação e correção automática de provas. Se sistemas como esses são adotados sem considerar a robustez, milhares de alunos podem receber notas erradas por resolverem equações de forma alternativa, mas correta.
O estudo também abre espaço para questionar a validade de avaliações automatizadas em áreas onde o processo importa mais que o resultado, como em matemática, programação e lógica formal.
O que vem agora
Os autores defendem que a avaliação de robustez deve ser incorporada aos testes de modelos, separadamente da capacidade de resolver problemas. Eles apontam que mesmo em um domínio algébrico simples, com verdade absoluta conhecida, a verificação confiável do processo continua sendo um desafio.
Não há, no resumo, indicação de próximos passos concretos ou expansão do benchmark para outros tópicos, mas o trabalho sugere que a comunidade precisa desenvolver métodos específicos para medir e melhorar a robustez de avaliadores. A publicação no arXiv em 28 de agosto de 2026 coloca o tema em discussão acadêmica.