
C3-UniMM: framework causal para unificar modelos multimodais
Framework introduce grafo causal estruturado para alinhar compreensão e geração em múltiplas modalidades
O que aconteceu
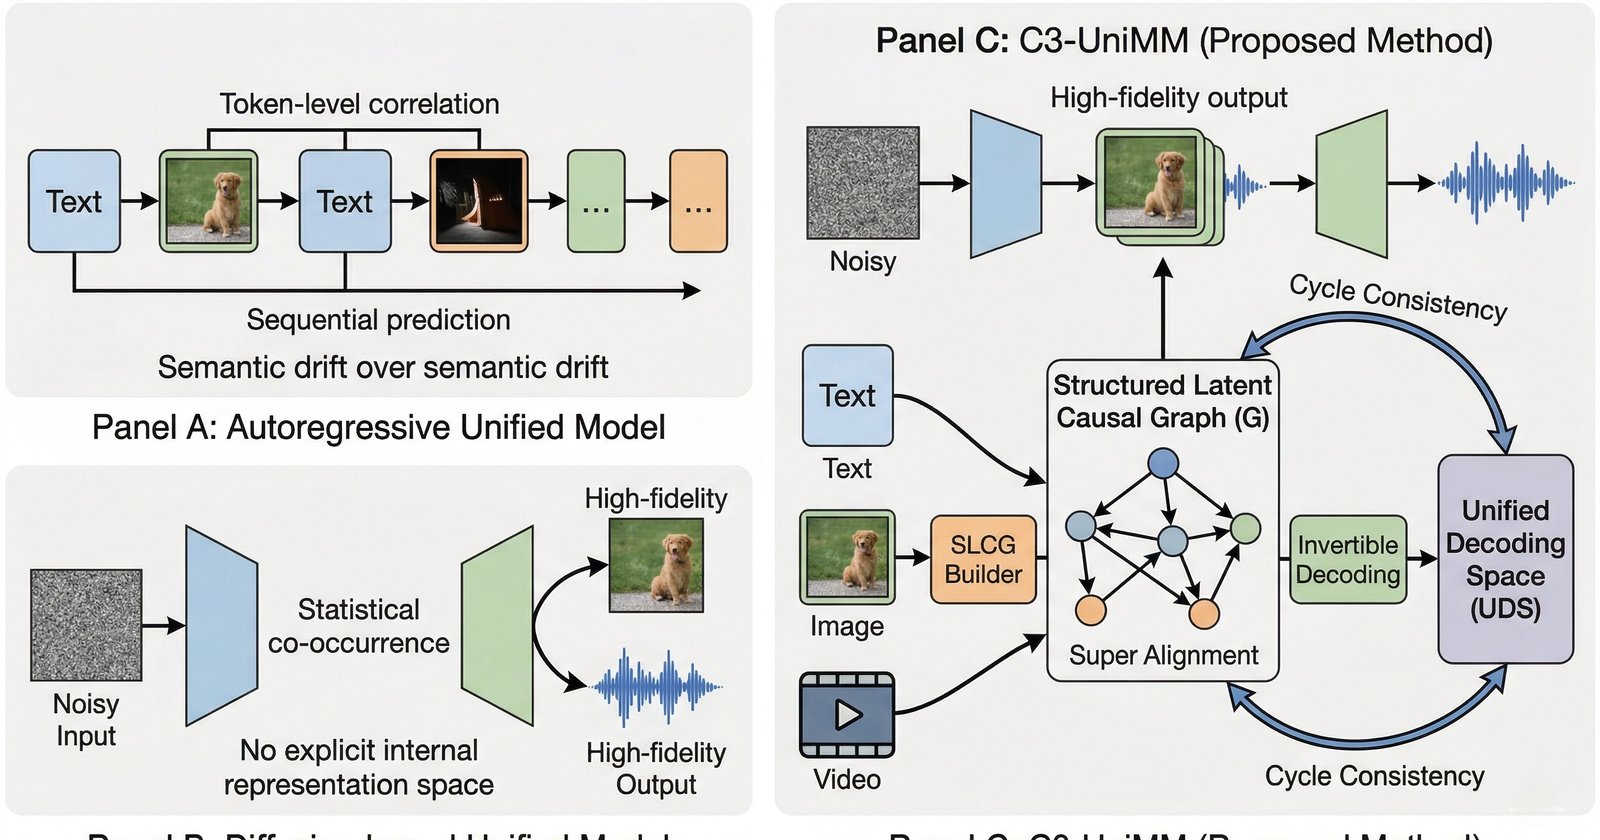
Em 4 de julho de 2026, um novo paper foi publicado no repositório arXiv (arXiv:2608.28603v1) apresentando o C3-UniMM (Causal Cycle-Consistent Unified Multimodal Modeling). A proposta é um framework que busca unificar a compreensão e a geração em qualquer modalidade (texto, imagem, áudio, etc.) através de um mecanismo de alinhamento baseado em causalidade. O framework introduz três componentes técnicos centrais: um Structured Latent Causal Graph (SLCG) para funcionar como espaço semântico compartilhado, blocos de codificação multimodal unificados e um Unified Decoding Space para garantir preservação estrutural e invertibilidade semântica. O resultado, segundo os autores, é um desempenho que "substantially outperforms" (supera substancialmente) os baselines multimodais unificados existentes em tarefas de compreensão, geração e generalização composicional.
Contexto
O campo de Unified Multimodal Models tem como objetivo criar sistemas capazes de qualquer compreensão e geração entre modalidades arbitrárias. Porém, a abordagem padrão se baseia em modelar correlações estatísticas implícitas, sem impor restrições de consistência estrutural entre as diferentes modalidades. Isso gera problemas concretos documentados na literatura: "semantic drift" (quando o modelo perde a noção central do objeto ao transitar entre modalidades), fraca generalização composicional (dificuldade em combinar conceitos de formas novas) e instabilidade sob intervenções (quando se tenta alterar um atributo específico da saída). O C3-UniMM surge como uma resposta direta a essas limitações, propondo um formalismo causal para impor consistência.
Por que importa
O impacto prático é direto para pesquisadores e engenheiros que desenvolvem modelos generativos e assistentes multimodais. Um framework que alinha causalmente a compreensão e a geração promete reduzir alucinações e erros lógicos. Por exemplo, ao gerar uma imagem a partir de uma descrição textual complexa, o modelo manteria melhor a relação causal entre os elementos. A "generalização composicional" melhorada significa que um modelo treinado para descrever cenas poderia, em teoria, combinar conceitos de forma mais confiável para criar cenas novas e plausíveis. Para empresas desenvolvendo agentes de IA para atendimento, criação de conteúdo ou computação visual, isso representa uma busca por mais previsibilidade e controle sobre as saídas do modelo.
Impacto
Os autores realizaram "extensive experimental results" (resultados experimentais extensivos) que cobrem múltiplas tarefas. A afirmação principal é que o C3-UniMM supera os baselines existentes. Embora o resumo não forneça métricas numéricas, o foco em "compositional generalization tasks" sugere ganhos particularly significativos em cenários onde o modelo precisa combinar informação de forma criativa. A abordagem teórica de "cycle consistency" e "super alignment" visa aumentar a invertibilidade (a capacidade de gerar uma modalidade a partir de outra e vice-versa, com fidelidade) e a invariância de mecanismo (garantir que a lógica subjacente do modelo se mantenha constante independentemente da modalidade de entrada ou saída).
O que muda
A mudança principal é uma proposta de arquitetura que dá precedência a uma estrutura causal explícita sobre a modelagem puramente estatística. A introdução do Structured Latent Causal Graph (SLCG) como "shared cross-modal semantic space" é uma tentativa de criar uma "linguagem" comum e estruturada que diferentes modalidades possam usar. Isso representa um avanço em relação a modelos que tratam cada modalidade de forma mais isolada antes da fusão. A pesquisa também destaca que a instabilidade e o drift são problemas "profundos" das abordagens atuais, posicionando o C3-UniMM como uma correção de arquitetura.
O que vem agora
O trabalho está na fase de publicação pré-print, com submissão datada de 4 de julho de 2026. Os próximos passos na academia serão a revisão por pares e a implementação independente por outros grupos para validação. Para a aplicação prática, a complexidade do framework e o custo computacional de treinar um grafo causal estruturado compartilhado são barreiras que precisarão ser endereçadas. A pesquisa futura provavelmente se concentrará em escalar o C3-UniMM e em testar sua eficácia em modelos de linguagem multimodais maiores e mais diversos.