
CacheScout: Camada de KV-cache Inteligente para Servidores de LLM Multi-Agente
Sistema aprende transições de execução para otimizar cache em tempo real sem treinamento offline.
O que aconteceu
No dia 16 de julho de 2026, um artigo no arXiv (arXiv:2608.14624) introduziu o CacheScout, uma camada de execução para gerenciamento de KV-cache em servidores de LLM multi-agente. Implementado sobre o vLLM, o sistema aprende online as transições de execução de agentes para guiar a substituição e o prefetching proativo de cache. Os resultados em cargas de trabalho reais mostram melhoria de 10 a 18 pontos percentuais na taxa de acerto do KV-cache, redução de 18% a 45% no TTFT médio (Time to First Token), queda de 29% a 38% na latência por turno e aumento de até 57% no pico de throughput. Em modelos maiores, o TTFT cai até 54% com throughput 37% maior.
Contexto
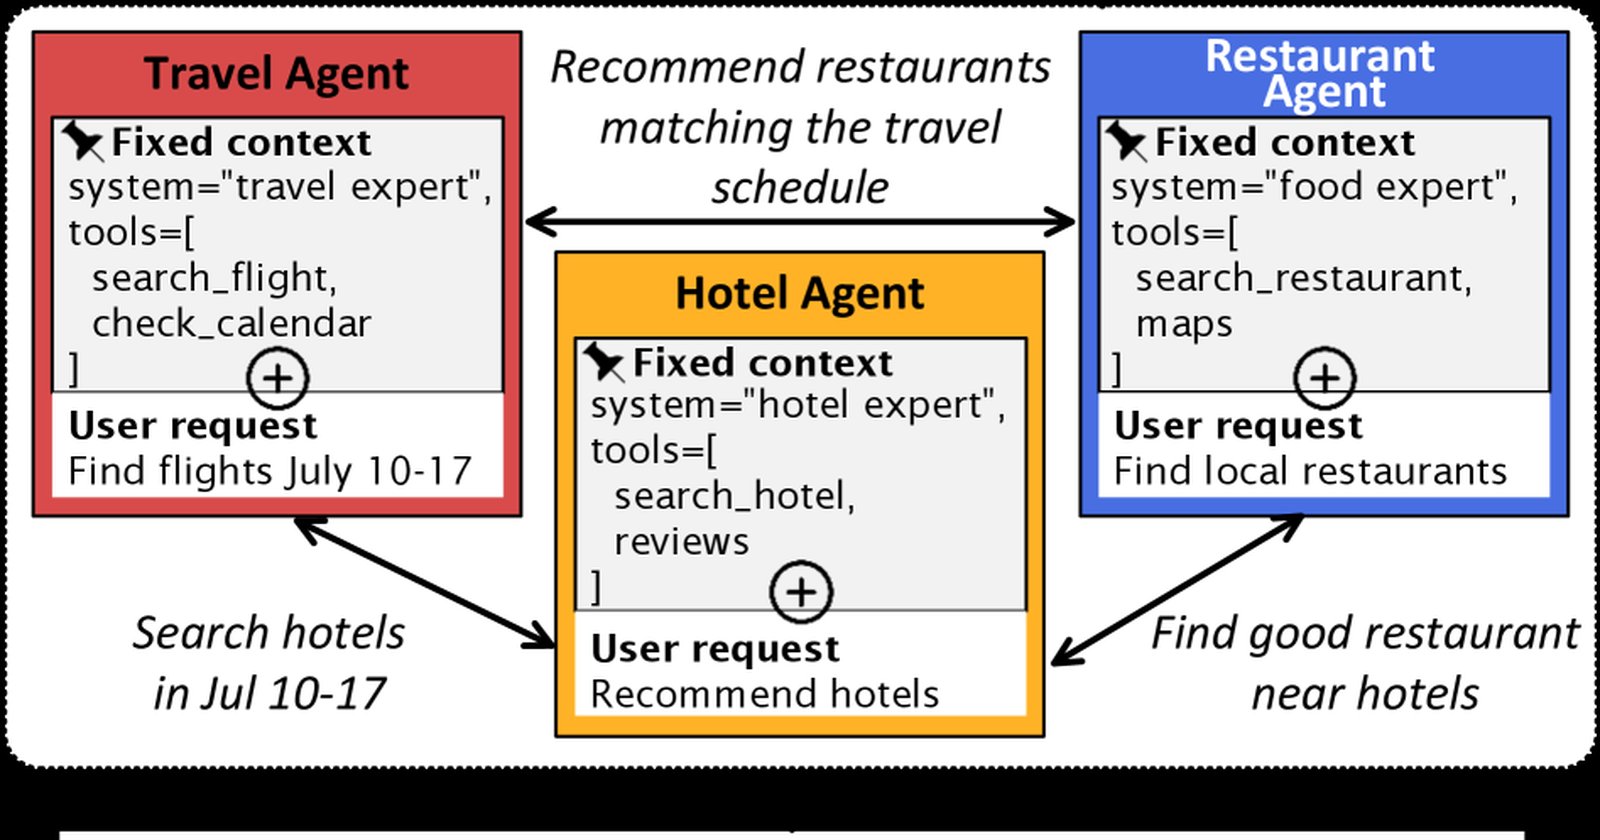
Sistemas multi-agente de LLM tornaram-se um paradigma importante para serviços de IA, onde cada requisição do usuário é decomposta em agentes especializados. Esses agentes repetem contextos fixos — prompts de sistema, definições de ferramentas e exemplos — criando oportunidades para reutilização de KV-cache. No entanto, sistemas existentes como o vLLM gerenciam o cache de forma reativa, usando cache de prefixo e substituição baseada em recência. Isso faz com que contextos reutilizáveis sejam evicted antes da próxima invocação, forçando recomputação custosa. O CacheScout aborda isso ao focar na semântica de execução, não apenas na recência.
Por que importa
Para empresas e desenvolvedores que deployam serviços de IA, a ineficiência no gerenciamento de cache aumenta custos computacionais e latência. O CacheScout melhora a eficiência operacional, permitindo respostas mais rápidas e custos menores. No Brasil, onde a adoção de IA cresce em startups e corporações, isso pode otimizar infraestrutura local e competitividade global, especialmente em sistemas multi-agente que são cada vez mais comuns em automações complexas.
Impacto
No curto prazo, servidores de LLM poderão processar mais requisições com menor latência, reduzindo custos de hardware e energia. No médio prazo, a abordagem agent-aware pode tornar-se padrão em frameworks de serving, incentivando a adoção de arquiteturas multi-agente mais eficientes. Isso também pode acelerar a inovação em aplicações que dependem de interações rápidas, como assistentes virtuais e sistemas de raciocínio.
O que muda
O CacheScout altera fundamentalmente a gestão de KV-cache de um modelo reativo para um proativo. Em vez de depender apenas de regras de recência, o sistema aprende padrões de execução em tempo real, sem precisar de grafos de workflow predefinidos ou treinamento offline. Isso deixa o caminho crítico de serving inalterado, garantindo compatibilidade e desempenho. A camada pode ser integrada a sistemas existentes, promovendo uma migração suave.
O que vem agora
Os próximos passos incluem testes em ambientes de produção com cargas de trabalho diversas e possíveis integrações com outros frameworks além do vLLM. Pesquisas futuras podem explorar a escalabilidade para modelos ainda maiores e a adaptação a diferentes padrões de execução de agentes. A validação em cenários reais do mercado brasileiro poderia ajudar a impulsionar sua adoção local.