
CDRL: IA com certificação acelera busca por modelos de neutrinos
Método de aprendizado por reforço usa feedback simbólico para explorar espaço de 10^26 hipóteses
O que aconteceu
O artigo arXiv:2608.20686, submetido em 21 de agosto de 2026 na área de Inteligência Artificial (cs.AI), introduz o Certification-Driven Reinforcement Learning (CDRL). Trata-se de um framework que integra feedback estruturado de ferramentas de raciocínio simbólico ao processo de aprendizado por reforço. Quando um candidato viola restrições de domínio, essas ferramentas produzem certificados que identificam as ações responsáveis pela falha. O CDRL converte esses certificados em restrições reutilizáveis, eliminando classes de soluções inválidas e orientando a exploração para regiões válidas.
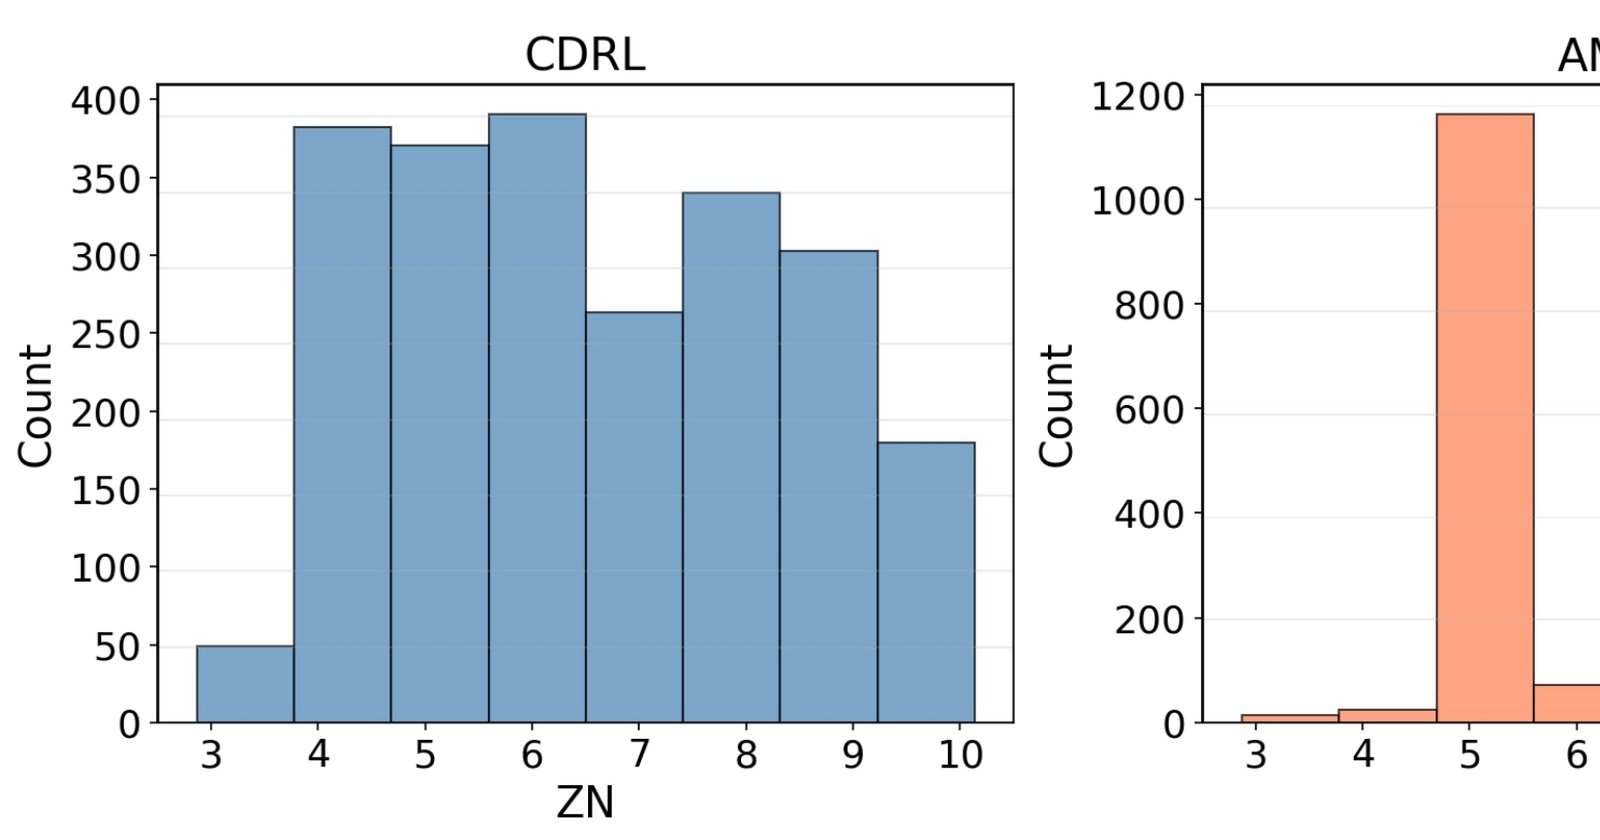
O método foi avaliado na descoberta de modelos de sabor de neutrinos, um problema de física teórica de partículas onde o espaço de hipóteses excede 10^26 modelos possíveis. Comparado ao estado da arte em aprendizado por reforço usado anteriormente nessa tarefa, o CDRL obteve, em três espaços teóricos, até 1,95x mais modelos válidos, até 6,33x mais modelos de neutrinos, avaliando até 4x menos candidatos.
Contexto
Muitos problemas de descoberta científica exigem buscar espaços de hipóteses combinatórios sob restrições complexas. O aprendizado por reforço (RL) aparece como abordagem promissora, mas os métodos existentes dependem de recompensas escalares, que dão informação limitada sobre o motivo do fracasso de um candidato. Isso faz com que os agentes explorem repetidamente regiões inválidas, desperdiçando recursos computacionais.
O problema específico dos neutrinos é clássico na física teórica. A descoberta de modelos de sabor envolve combinar representações de grupos de simetria e campos escalares para reproduzir as massas e misturas observadas. O espaço combinatório explode rapidamente, e a validação de cada modelo exige verificar restrições de física de partículas. Sem orientação estruturada, o RL gasta a maior parte do tempo em hipóteses que não podem ser realizadas.
O CDRL ataca exatamente esse gargalo. Ao usar certificados simbólicos como fonte de feedback, o framework aprende não apenas que um candidato falhou, mas também por que falhou, permitindo podar regiões inteiras do espaço de busca.
Por que importa
O ganho prático é direto para qualquer área de descoberta científica com espaços discretos e restrições rígidas. No caso dos neutrinos, o CDRL avalia 4x menos candidatos para obter mais modelos válidos. Isso significa menos tempo de GPU e mais resultados por experimento.
O artigo também extrai 40 regras interpretáveis das trajetórias de busca usando um framework de árvore de decisão pós-hoc. Quando essas regras são reutilizadas como restrições suaves, os ganhos chegam a 2x na taxa de modelos válidos e 3x na descoberta de modelos de neutrinos, nos três espaços teóricos avaliados.
Esse resultado sugere que o CDRL descobre estrutura reutilizável em espaços de busca combinatórios. A implicação é que o conhecimento obtido em uma execução pode ser transferido para outras, reduzindo o custo de exploração futura.
Impacto
Em curto prazo, o método pode acelerar a busca por modelos de física além do modelo padrão. Em médio prazo, a abordagem de certificados é geral e pode ser aplicada em bioinformática, química combinatória ou design de materiais, onde restrições de domínio são complexas e ferramentas simbólicas existem.
O ganho de interpretabilidade também importa. As 40 regras extraídas permitem que físicos entendam quais propriedades tornam um modelo viável, transformando a IA em uma ferramenta de exploração científica, não apenas de geração de candidatos.
No cenário brasileiro, grupos de física teórica de partículas e aprendizado de máquina poderiam replicar o método em problemas locais, como análise de dados de oscilação de neutrinos em colaborações internacionais das quais o Brasil participa.
O que vem agora
O artigo não lista próximos passos explícitos, mas a natureza geral do framework sugere expansão para outras áreas de descoberta científica. A avaliação em três espaços teóricos de neutrinos é uma prova de conceito; aplicações em outras teorias de física ou em problemas de otimização combinatória são caminhos naturais.
Como o código e os dados não foram liberados no preprint, a replicação depende da publicação dos materiais pelos autores. A comunidade de IA pode acompanhar o andamento do trabalho no arXiv, onde o identificador é 2608.20686.
Fonte
- arXiv: CDRL: Certification-Driven Reinforcement Learning for Neutrino Flavor Model Discovery (arXiv:2608.20686, submetido em 21 de agosto de 2026). https://arxiv.org/abs/2608.20686