
CLIP em geolocalização regional: adaptação eleva acurácia de 39% para 82%
Pesquisa com 9.085 imagens da Grande Los Angeles compara técnicas de ajuste fino e revela qual informação visual pesa de verdade
O que aconteceu
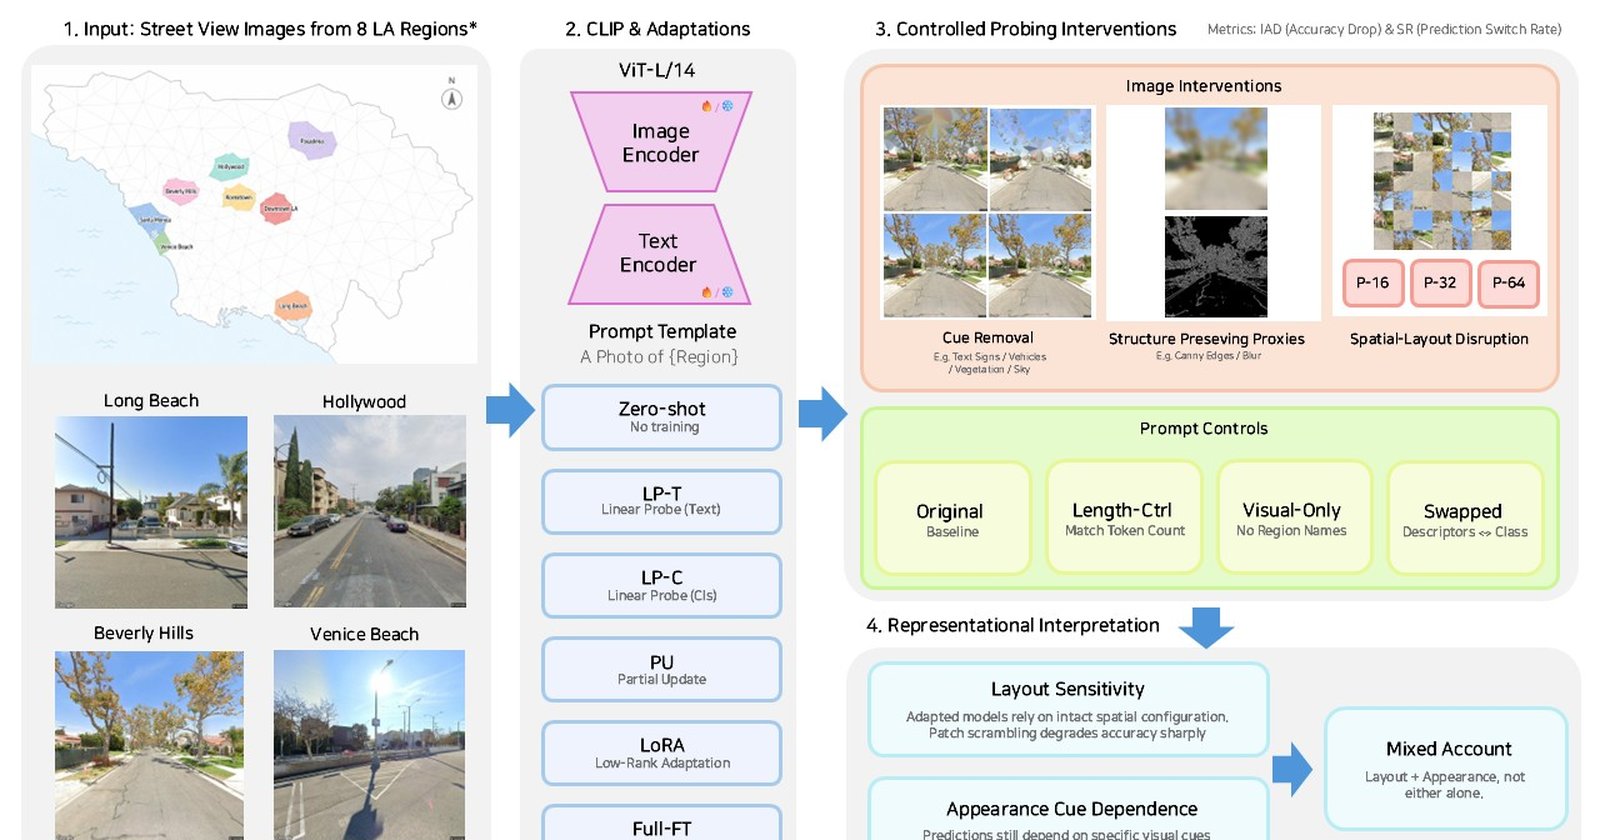
Pesquisadores submeteram ao arXiv o artigo "What Does CLIP Learn for Regional Geolocalization? Probing Visual Cues and Scene Configuration After Adaptation" (arXiv:2608.21761). O estudo usou 9.085 imagens de street view de oito regiões da Grande Los Angeles para testar cinco abordagens: CLIP zero-shot, leitura com encoder congelado, atualização parcial do encoder, Low-Rank Adaptation (LoRA) e fine-tuning completo.
O CLIP zero-shot, que usa o modelo sem nenhum treinamento adicional, acertou a região correta em 39,03% dos casos. Os métodos com encoder congelado ficaram perto desse número. Já a adaptação do encoder, seja por LoRA ou fine-tuning parcial, alcançou entre 75,94% e 82,10% de acurácia. O fine-tuning completo também reduziu a distância média entre a previsão e o centro real da região, de 12,30 km para 3,86 km.
Contexto
A geolocalização regional de imagens de rua é um problema difícil porque áreas vizinhas compartilham sinais visuais parecidos, como o mesmo tipo de vegetação, arquitetura e postes de luz. O texto do estudo explica que, embora grandes coleções de imagens de street view ofereçam informação rica, extrair dados geográficos finos dessas imagens continua desafiador.
O CLIP, modelo pré-treinado em pares de imagem e texto, já é usado para tarefas de visão e linguagem. Mas a pergunta central do artigo é se as características do CLIP pré-treinado bastam para discriminar regiões próximas dentro de uma metrópole, e qual informação visual sustenta o desempenho depois que o modelo é adaptado.
Por que importa
Para aplicações de mapeamento urbano, navegação autônoma e análise de cidades, saber em qual região uma foto foi capturada importa na prática. Sistemas de entrega, carros autônomos e plataformas de turismo dependem de estimar localização a partir de imagens. Um modelo que erra a região em mais de 60% dos casos, como o CLIP zero-shot, é inútil para esse tipo de tarefa.
O estudo mostra que a adaptação do encoder, não apenas do classificador final, é o que faz a diferença. A precisão salta de 39,03% para 82,10%, e o erro de distância cai mais de três vezes. Isso significa que quem quiser usar CLIP para geolocalização precisa investir em ajuste fino do modelo, não em um simples cabeçote de classificação.
Impacto
Os pesquisadores também testaram o que o modelo aprende de fato. Eles removeram pistas semânticas, reduziram a aparência com mapas de borda e desfoque, e destruíram a configuração da cena embaralhando patches da imagem. Após a adaptação, os modelos mudaram entre 42,92% e 45,56% das previsões quando a cena foi embaralhada, contra apenas 10,79% a 14,60% nos métodos com encoder congelado. Ou seja, o modelo adaptado passou a depender mais da configuração intacta da cena.
Curiosamente, a adaptação não melhorou a fração de desempenho retida quando a aparência foi reduzida. Vegetação e céu continuaram influentes. Um controle com o dataset Caltech101 mostrou que a sensibilidade ao embaralhamento não é exclusiva da geolocalização, o que sugere que esse comportamento pode ser geral para modelos de visão adaptados.
O que muda
Para quem trabalha com visão computacional aplicada a cidades, o recado prático é claro: a geolocalização regional fina exige adaptação do encoder, e o ganho vem principalmente da sensibilidade à estrutura da cena, não apenas de pistas isoladas. A conclusão, porém, tem limites. O estudo alerta que os resultados valem para variação de ponto de vista perto de locais conhecidos, não para generalização geográfica em áreas nunca vistas.
O que vem agora
O artigo foi submetido ao arXiv em 22 de agosto de 2026 e está em pré-impressão. Os autores não divulgaram código ou dataset, e não há datas de publicação em conferência. Próximos passos prováveis incluem testar a abordagem em outras metrópoles e verificar se a conclusão sobre configuração de cena se mantém fora da Grande Los Angeles. Enquanto isso, o trabalho oferece um roteiro para quem quer extrair localização regional de imagens de rua: adapte o encoder, meça o erro em distância e desconfie de resultados baseados apenas em pistas visuais óbvias.