
Colapso de modelo: estudo revisa o risco de IA treinar com dados sintéticos
Revisão publicada no arXiv consolida pesquisas sobre o fenômeno e aponta caminhos para evitá-lo
O que aconteceu
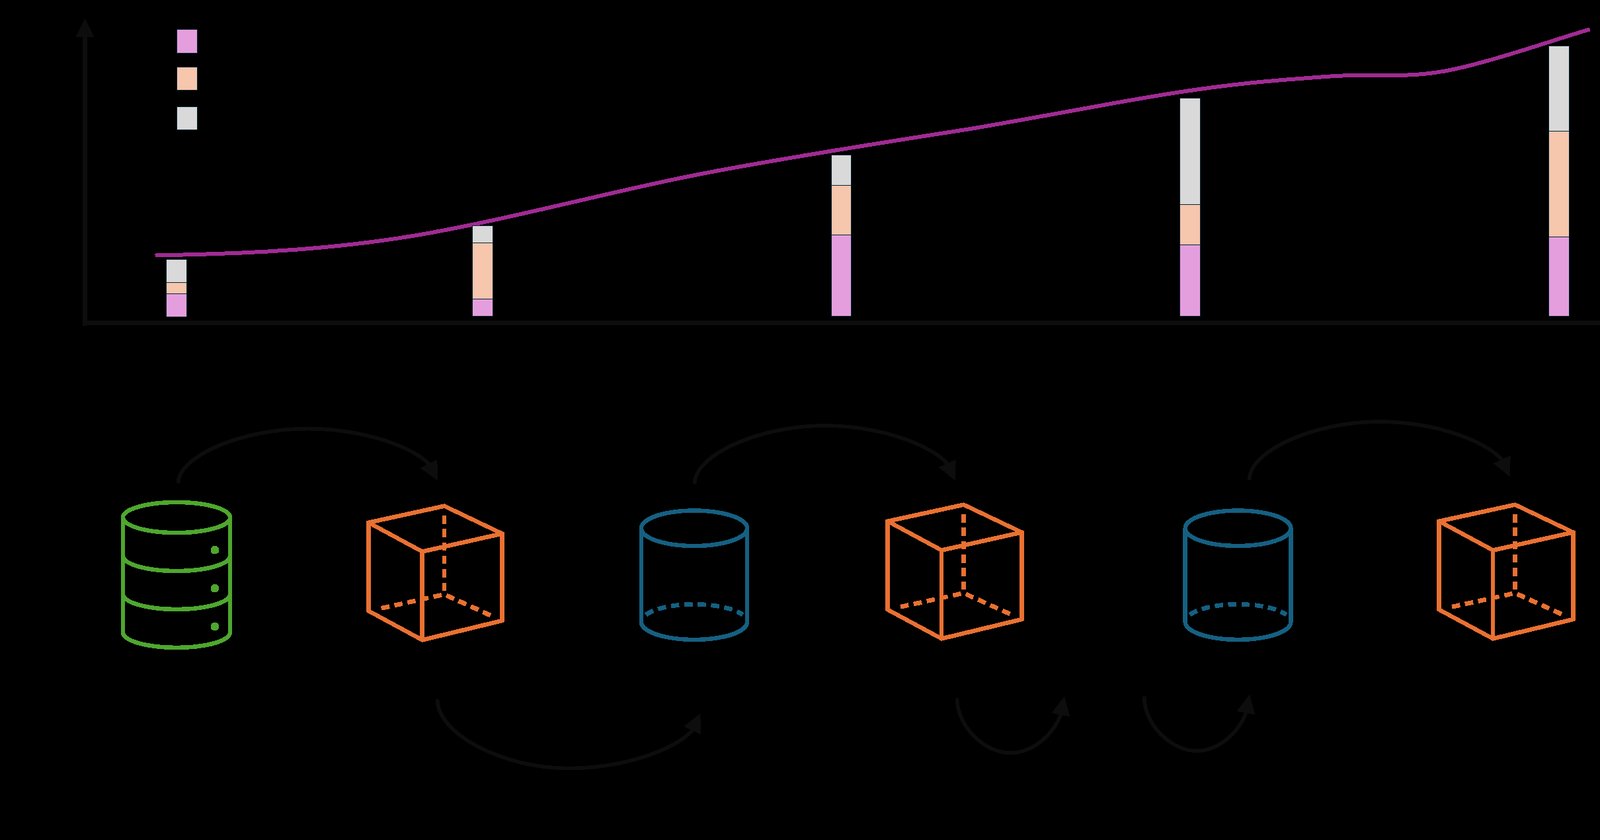
O paper 'Reviewing Model Collapse and Countermeasures' foi submetido ao repositório arXiv em 17 de junho de 2026, na categoria Computer Science > Artificial Intelligence (cs.AI). O trabalho, identificado pelo código arXiv:2608.21366, propõe a primeira revisão abrangente do fenômeno conhecido como colapso de modelo (model collapse, em inglês). O estudo define o problema: quando uma IA generativa é treinada com dados sintéticos criados por outra IA, em um ciclo de consumo contínuo entre modelo e dados, o modelo acaba por colapsar. Esse colapso levanta preocupações sobre a confiabilidade dos sistemas generativos.
O colapso de modelo, fenômeno central do paper, ocorre em um ciclo autofágico entre modelo e dados. O estudo do arXiv explica que o uso de dados sintéticos aliviou a demanda por dados reais, mas introduziu um problema crítico: a degradação progressiva do modelo em gerações sucessivas. O paper reúne estudos recentes sobre o fenômeno, aplicações em diferentes cenários e contramedidas para mitigá-lo.
Contexto
A IA generativa avançou impulsionada por grandes volumes de dados da web. Esse progresso levou pesquisadores a usar dados sintetizados por IA para treinar modelos de próxima geração. O uso de dados sintéticos reduziu a pressão por dados reais, que são caros e escassos. Mas o ciclo de autoconstrução criou um problema: a qualidade do modelo degrada a cada iteração.
A revisão 'Reviewing Model Collapse and Countermeasures' preenche uma lacuna. Antes dela, não havia uma consolidação do conhecimento sobre o colapso de modelo. O paper organiza o que se sabe sobre o fenômeno em diferentes cenários de aplicação e as soluções já propostas.
Por que importa
O colapso de modelo afeta diretamente empresas e pesquisadores que dependem de dados sintéticos para treinar grandes modelos de linguagem. Se uma IA treina com saídas de outra IA, os erros e os vieses se acumulam. Isso pode gerar modelos menos precisos, com respostas repetitivas ou desconectadas da realidade.
Para startups e laboratórios que não têm acesso a grandes bases de dados proprietárias, a dependência de dados sintéticos é ainda maior. O estudo aponta que o risco não é teórico: o colapso de modelo, fenômeno já observado em experimentos, pode minar a confiança nos sistemas generativos. Quem usa IAs em produção precisa conhecer as contramedidas para evitar a degradação silenciosa.
Impacto
No curto prazo, a revisão orienta pesquisadores sobre quais abordagens funcionam para mitigar o colapso de modelo. O paper destaca que as contramedidas variam conforme o cenário de aplicação. Algumas soluções envolvem filtrar dados sintéticos, outras propõem manter uma proporção mínima de dados reais no treinamento.
No médio prazo, o estudo deve influenciar a forma como as empresas planejam seus pipelines de dados. O colapso de modelo impõe um limite prático ao uso indiscriminado de dados gerados por IA. A revisão do arXiv serve como referência para quem precisa decidir quanto dado sintético é seguro usar.
O que muda
O paper 'Reviewing Model Collapse and Countermeasures' muda o estado da arte ao consolidar o conhecimento sobre o fenômeno. Antes, cada estudo abordava o colapso de forma isolada. Agora, pesquisadores têm um mapa das pesquisas existentes e das lacunas abertas. O trabalho também sinaliza oportunidades futuras de pesquisa, especialmente na criação de contramedidas mais robustas.
A publicação reforça que o colapso de modelo não é um problema único, mas um conjunto de manifestações que exigem estratégias específicas. Isso muda a expectativa de quem acreditava que bastaria alimentar um modelo com dados de outro para melhorá-lo.
O que vem agora
O paper foi anunciado em 25 de agosto de 2026, mas segue como preprint, sujeito a revisão da comunidade. Os próximos passos esperados incluem a validação das contramedidas listadas em cenários reais de produção. O estudo também abre espaço para novos trabalhos que testem as soluções propostas em diferentes escalas de modelo e domínios.
Pesquisadores que trabalham com dados sintéticos devem acompanhar os desdobramentos. O colapso de modelo, fenômeno descrito no paper, continuará sendo tema central à medida que mais empresas adotam ciclos de treinamento com dados gerados por IA. A revisão fornece a base para que essas decisões sejam mais informadas.