
CoMA-DiT: Diffusion Transformer decodifica estados cerebrais
Novo método usa modalidades pareadas como fonte de supervisão generativa, não só como entradas para fusão
O que aconteceu
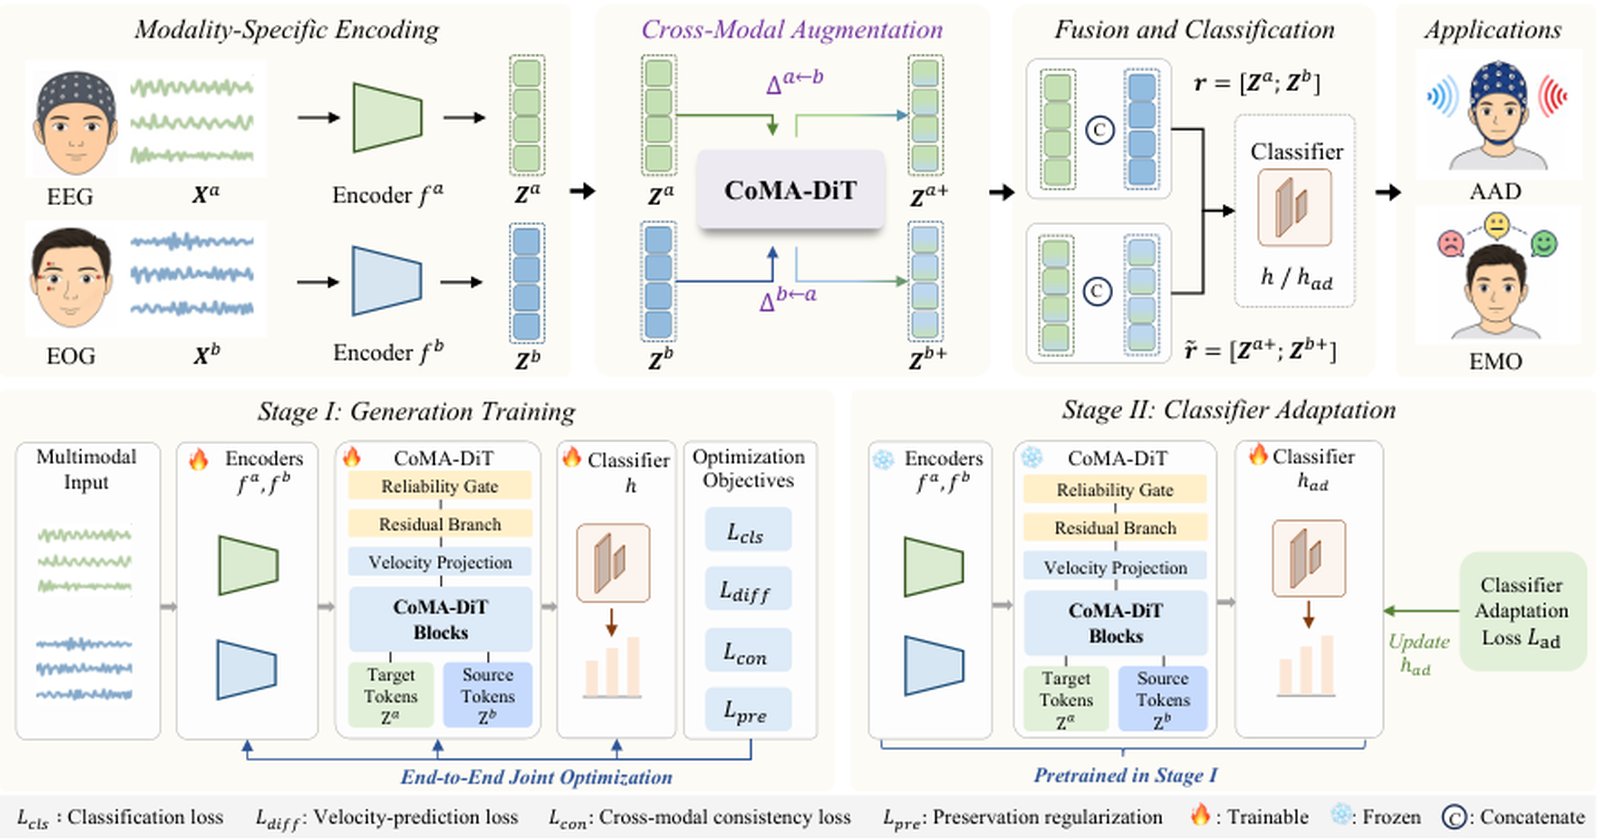
Um paper submetido ao arXiv em 10 de setembro de 2026 propõe o CoMA-DiT, um Diffusion Transformer bidirecional de aumento cross-modal para decodificação de estados cerebrais multimodais. O trabalho está registrado como arXiv:2609.11341v1, na área de Ciência da Computação com subárea em Inteligência Artificial. O CoMA-DiT, modelo apresentado no artigo arXiv:2609.11341v1, foi desenhado para atacar uma lacuna que os próprios autores descrevem na abertura do texto.
A literatura de decodificação de estados cerebrais multimodais, segundo o paper, concentrou-se em fundir modalidades pareadas para fazer previsões. O que ficou de fora foi explorar como a correspondência entre essas modalidades pode enriquecer os dados de treino e melhorar o aprendizado de representação multimodal. É exatamente aí que entra o CoMA-DiT.
O funcionamento tem dois componentes centrais. O primeiro condiciona a previsão de velocidade (velocity prediction) na modalidade pareada por meio de atenção cross-modal. O segundo injeta a variação resultante de forma adaptativa, com um mecanismo residual com porte de confiabilidade (reliability-gated residual). Na prática, o modelo trata as modalidades pareadas como fontes de supervisão generativa mútua, em vez de apenas entradas a serem fundidas.
Contexto
A decodificação de estados cerebrais multimodais trabalha com pares de modalidades que descrevem o mesmo fenômeno neural por ângulos diferentes. A abordagem dominante trata esses pares como um problema de fusão: cada modalidade entra no modelo, as representações são combinadas e a previsão sai no fim. O aumento de dados, quando aparece, costuma ser tratado como etapa separada e genérica.
O paper parte de uma premissa diferente. Se duas modalidades descrevem o mesmo estado cerebral, a relação entre elas carrega informação que pode ser usada para gerar variações latentes úteis ao treinamento. É esse raciocínio que sustenta a ideia de supervisão generativa mútua: cada modalidade ajuda a gerar dados para a outra.
A arquitetura escolhida para isso é o Diffusion Transformer (DiT), aplicado no espaço latente em vez do espaço de pixels ou sinais brutos. O termo bidirecional indica que a troca de supervisão acontece nos dois sentidos entre as modalidades do par.
Por que importa
Os números do experimento são o ponto mais concreto do paper. Em tarefas de decodificação auditiva de atenção multimodal e de reconhecimento de emoções, o CoMA-DiT superou 20 baselines representativos de forma consistente, segundo o artigo. O ganho absoluto foi de 4,28% em acurácia e de 6,70% em macro-F1 na comparação com o baseline sem aumento. O CoMA-DiT, portanto, não mede sua contribuição apenas em acurácia: o avanço em macro-F1 é maior, e essa métrica pesa mais quando as classes do problema são desbalanceadas.
A escolha de dois domínios distintos de teste também importa. Decodificação auditiva de atenção e reconhecimento de emoções envolvem alvos diferentes e servem como sinal de que o ganho não está amarrado a uma única tarefa. Os autores relatam ainda análises de ablação, sensibilidade, visualização e interpretabilidade, usadas para sustentar três afirmações: robustez, generalização e capacidade de capturar interações cross-modais funcionalmente relevantes.
Impacto
O impacto mais direto é arquitetural. Se modalidades pareadas podem funcionar como fontes de supervisão que aumentam umas às outras, pipelines multimodais deixam de ser apenas cadeias de fusão e passam a incluir etapas de geração latente orientada pela modalidade parceira. Isso muda onde o custo computacional aparece: o aumento acontece no espaço latente, não na geração de dados brutos sintéticos.
Para equipes que trabalham com sinais biológicos e interfaces cérebro-computador, o efeito prático é a possibilidade de extrair mais de conjuntos de dados já existentes. O gargalo histórico dessas áreas é a coleta, que exige equipamento, voluntários e protocolos longos. Um método que enriquece o treino a partir do que já foi gravado ataca esse gargalo pela raiz.
O que muda
A conclusão que os autores defendem é conceitual, e está declarada no fim do resumo: modalidades pareadas podem servir não só como entradas para fusão, mas também como fontes de supervisão que se aumentam mutuamente. O CoMA-DiT é a demonstração empírica dessa tese, com os ganhos de 4,28% em acurácia e 6,70% em macro-F1 sustentando a mudança de enquadramento.
O que vem agora
O material disponível não informa submissão a conferência, prazo de revisão por pares nem disponibilização de código ou dados. O paper está no arXiv como preprint, o que significa que ainda não passou pelo crivo de revisão de uma comunidade científica. Os próximos passos naturais são a replicação independente dos resultados em decodificação auditiva de atenção e reconhecimento de emoções, e a verificação de como o CoMA-DiT se comporta em outros pares de modalidades além dos testados.
Fontes
- arXiv cs.AI, paper arXiv:2609.11341v1, submetido em 10 de setembro de 2026 (https://arxiv.org/abs/2609.11341)