
Como avaliar LLMs antes da produção, segundo o GitHub
A equipe do GitHub compartilha práticas para migrar de resultados promissores em protótipos para avaliação eficaz em ambientes de produção.
O que aconteceu
O GitHub compartilhou, em seu blog oficial, um conjunto de práticas para avaliação de modelos de linguagem grande (LLMs) antes da implantação em ambientes de produção. A publicação, intitulada "How to evaluate LLMs before production", parte da experiência da empresa ao desenvolver um sistema baseado em LLM para reduzir falsos positivos na varredura de segredos do GitHub. A varredura de segredos identifica credenciais, como tokens e chaves, que podem ter sido commitadas em repositórios. Como algumas strings se assemelham a segredos sem serem reais, desenvolvedores podem perder tempo investigando alertas sem necessidade. O GitHub precisou entender se o sistema conseguia reduzir alertas ruins sem comprometer a capacidade de detectar credenciais reais. A avaliação não se limitou a acurácia em benchmarks, mas analisou o impacto real no fluxo de trabalho de segurança.
Contexto
Antes de migrar para a produção, o GitHub usou benchmarks e conjuntos de dados curados para comparar modelos e testar prompts iniciais. Esses recursos são úteis na fase de protótipo, mas perdem utilidade quando o sistema enfrenta entradas reais. Nesses casos, as entradas são frequentemente ambíguas, os rótulos podem ser inconsistentes e contextos importantes podem estar ausentes ou truncados. Além disso, o conjunto de avaliação raramente reflete a distribuição real de produção. Casos raros em benchmarks podem se tornar falhas comuns em ambientes reais. Mesmo quando métricas offline melhoram, os resultados nem sempre se traduzem em comportamentos estáveis em produção. O GitHub constatou que um modelo com bom desempenho em benchmarks podia falhar justamente nos cenários críticos do dia a dia.
Por que importa
A decisão de qual métrica guia o produto não pode ser técnica apenas. O GitHub destaca que, ao avaliar um sistema baseado em LLM, é preciso definir previamente quais erros são aceitáveis, quais métricas devem orientar a decisão e quais limites de segurança devem ser mantidos. Na varredura de segredos, suprimir incorretamente uma credencial real pode ser mais grave do que pedir a um desenvolvedor para revisar um alerta adicional. Por isso, a equipe priorizou a segurança sobre a conveniência. Essa abordagem evita ajustes técnicos mal direcionados e mantém o foco no valor real entregue ao usuário final.
Impacto
Ao alinhar a avaliação com a decisão de produto, o GitHub conseguiu migrar de resultados promissores em laboratório para um sistema estável em produção. O aprendizado reforça que a qualidade de um LLM não se mede apenas por benchmarks, mas pela capacidade de lidar com ambiguidade, inconsistência e variação real dos dados. Outras equipes que trabalham com análise de código, ferramentas de desenvolvimento, segurança e análise de dados podem aplicar as mesmas práticas para evitar surpresas na produção.
O que muda
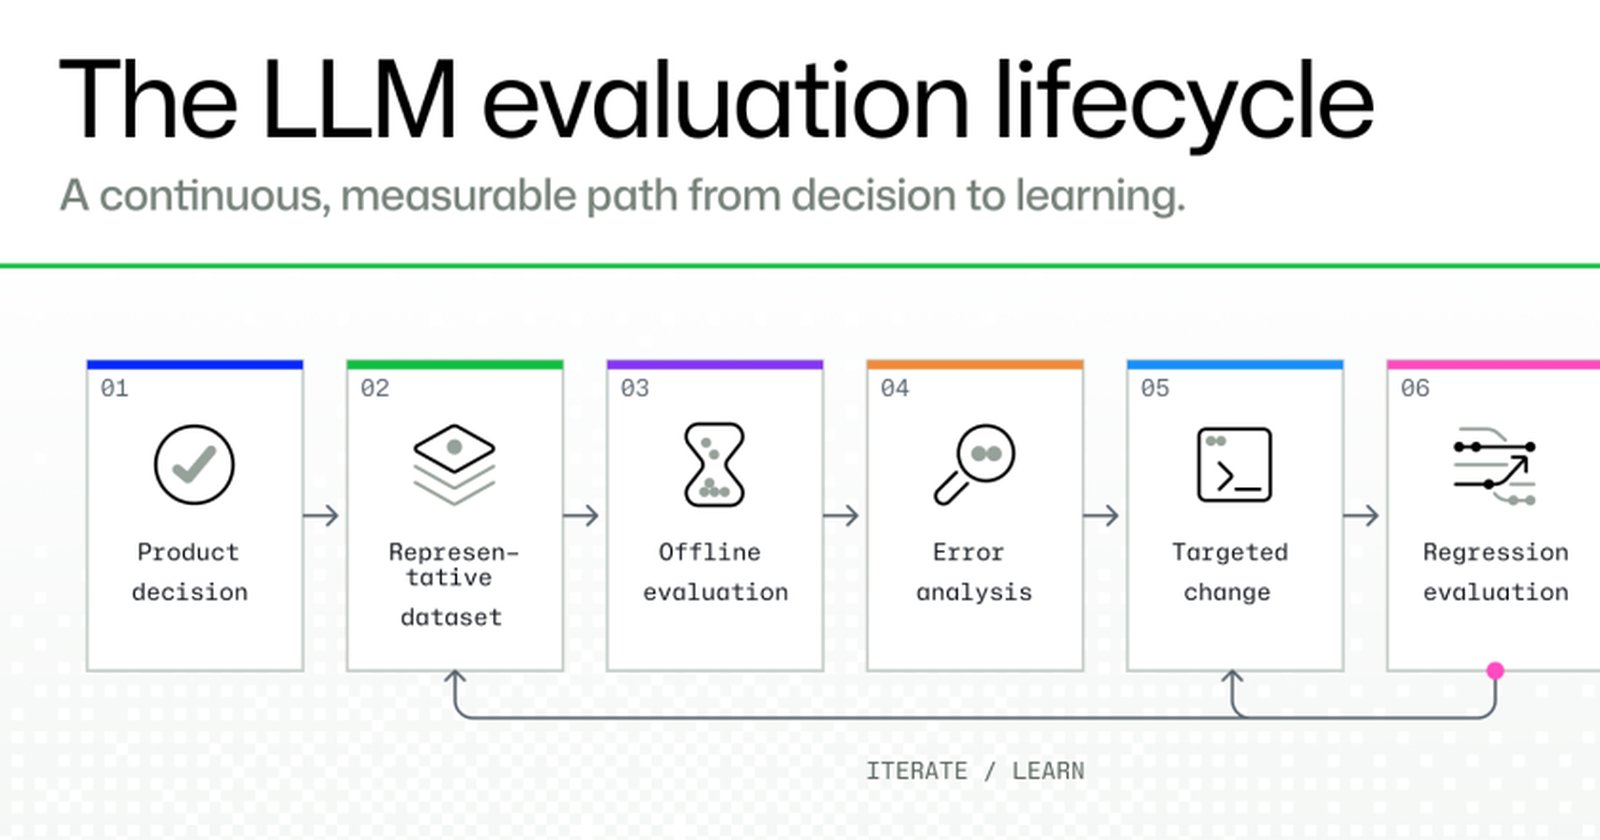
A publicação do GitHub indica que a avaliação de LLMs deve ser redefinida conforme o sistema avança da fase de protótipo para a produção. A equipe recomenda que os times comecem pela decisão de produto, e não pelo modelo. Isso significa definir claramente os objetivos, as métricas relevantes e os limites de segurança antes de ajustar prompts, modelos ou pipelines. A mudança de foco da técnica para o produto ajuda a evitar otimizações que não refletem o impacto real no dia a dia.
O que vem agora
O GitHub não detalhou próximos passos específicos, mas indica que as práticas compartilhadas são aplicáveis a sistemas de análise de código, ferramentas de desenvolvedor, segurança e análise de dados. Outras equipes que avaliam LLMs para produção podem adotar a estratégia de alinhar a avaliação com a decisão de produto, priorizando casos reais e métricas que reflitam o impacto no fluxo de trabalho. A publicação está disponível no GitHub Blog, com o título "How to evaluate LLMs before production".