
Compressão de raciocínio de IA para finanças atinge 91% de acurácia
Método HSDN reduz custo computacional do chain-of-thought em tarefas de alto risco, segundo artigo no arXiv.
O que aconteceu
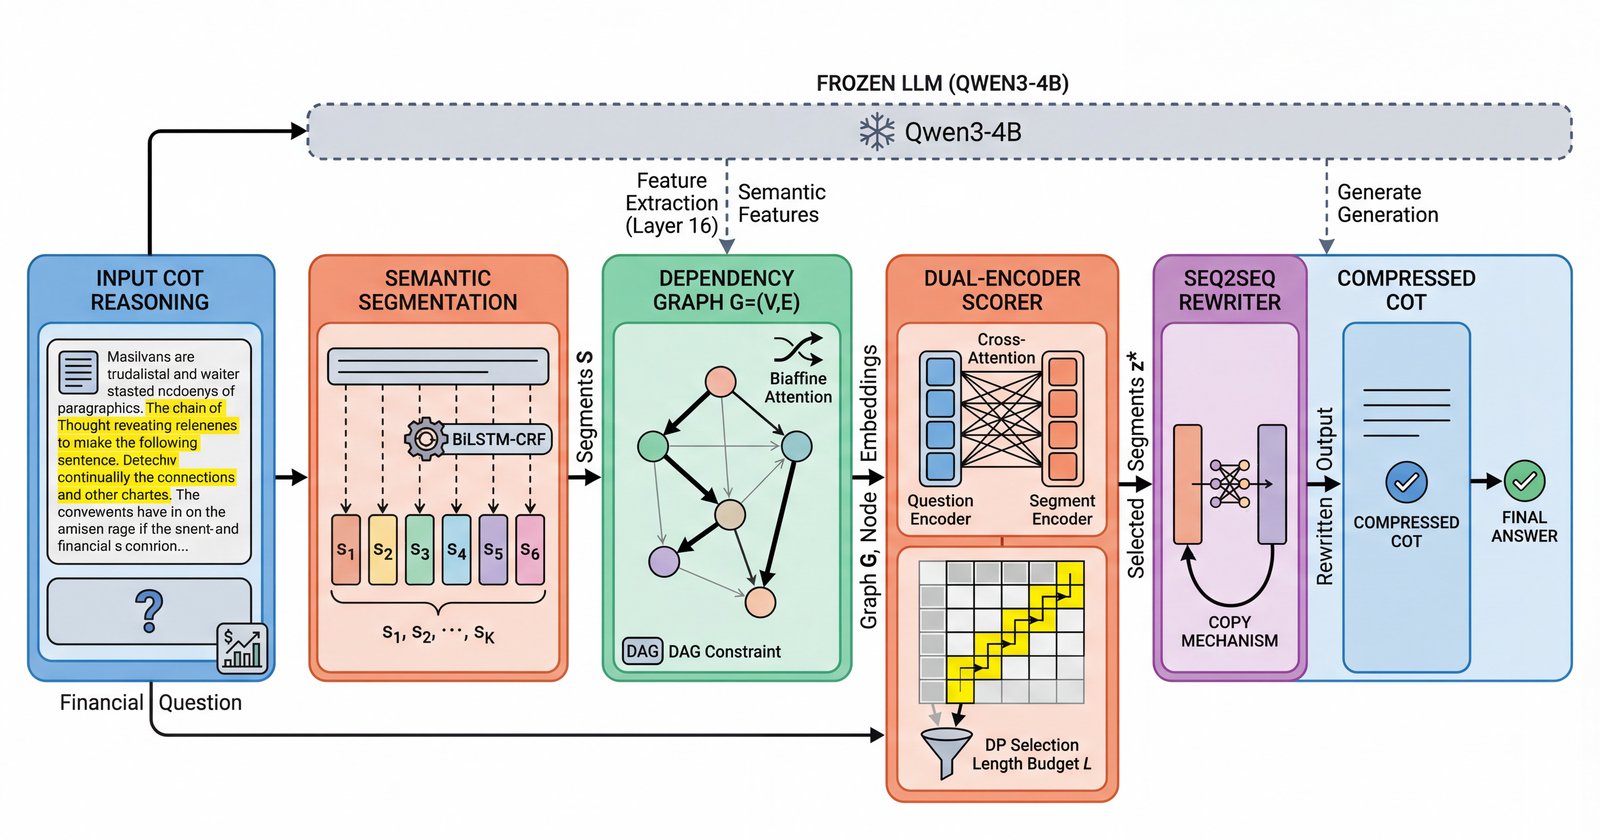
O artigo arXiv:2609.00413, submetido em 10 de julho de 2026, apresenta a Hierarchical Semantic Distillation Network (HSDN). O HSDN é um framework que comprime cadeias de raciocínio (chain-of-thought) preservando a precisão das respostas e a coerência lógica. No benchmark AFAC2025, o HSDN obteve 91% de acurácia com 68,4% de compressão, superando outros métodos de compressão em pontuação geral e coerência de raciocínio. A rede combina cinco componentes: segmentação semântica, construção de grafo de dependências, pontuação de importância com dois encoders, seleção de segmentos com restrições e reescrita de fronteiras locais. Um modelo Qwen3 4B congelado é usado apenas para extração de características e geração da resposta final, enquanto a compressão permanece estruturada e interpretável.
Contexto
O chain-of-thought prompting (CoT) melhora o raciocínio de modelos de linguagem ao gerar passos intermediários, mas esses passos longos aumentam o custo de inferência e dificultam a implantação em ambientes financeiros. Em finanças, onde decisões precisam ser rápidas e auditáveis, esse custo extra é um obstáculo. A compressão de CoT visa reduzir esse overhead mantendo a qualidade. Trabalhos anteriores tentaram comprimir cadeias, mas muitas vezes sacrificam coerência ou acurácia. O HSDN inova ao usar um grafo de dependências para guiar a compressão, garantindo que as relações lógicas entre passos sejam preservadas.
Por que importa
Em tarefas financeiras de alto risco, como análise de crédito, detecção de fraudes ou trading algorítmico, a precisão e a interpretabilidade são críticas. O HSDN oferece uma forma de reduzir custos computacionais sem abrir mão da transparência, já que a compressão é estruturada e o modelo Qwen3 4B atua apenas nas extremidades. Isso pode viabilizar a implantação de modelos com raciocínio mais profundo em sistemas de tempo real, além de facilitar auditorias e conformidade regulatória.
Impacto
A compressão de 68,4% significa que o modelo pode gerar respostas usando cerca de um terço dos tokens intermediários, reduzindo latência e custo por consulta. Para empresas que processam milhões de transações, isso representa economia significativa. O ganho em coerência de raciocínio, medido no AFAC2025, sugere que a técnica não apenas corta texto, mas mantém a lógica da cadeia. No curto prazo, o método pode ser adaptado para outros domínios regulados, como saúde e direito.
O que vem agora
O artigo está disponível no arXiv e, como é uma pesquisa acadêmica, ainda não há indicação de aplicação comercial ou disponibilização de código. A comunidade de IA pode reproduzir os experimentos e explorar variações do HSDN, como o uso de outros modelos base além do Qwen3 4B. Estudos futuros podem testar a técnica em benchmarks mais amplos e em cenários reais de mercado.