
Concordância não é alinhamento: estudo sobre moral em LLMs
Pesquisa do arXiv mostra que LLMs concordam com humanos em rótulos, mas usam fundamentos morais diferentes
O que aconteceu
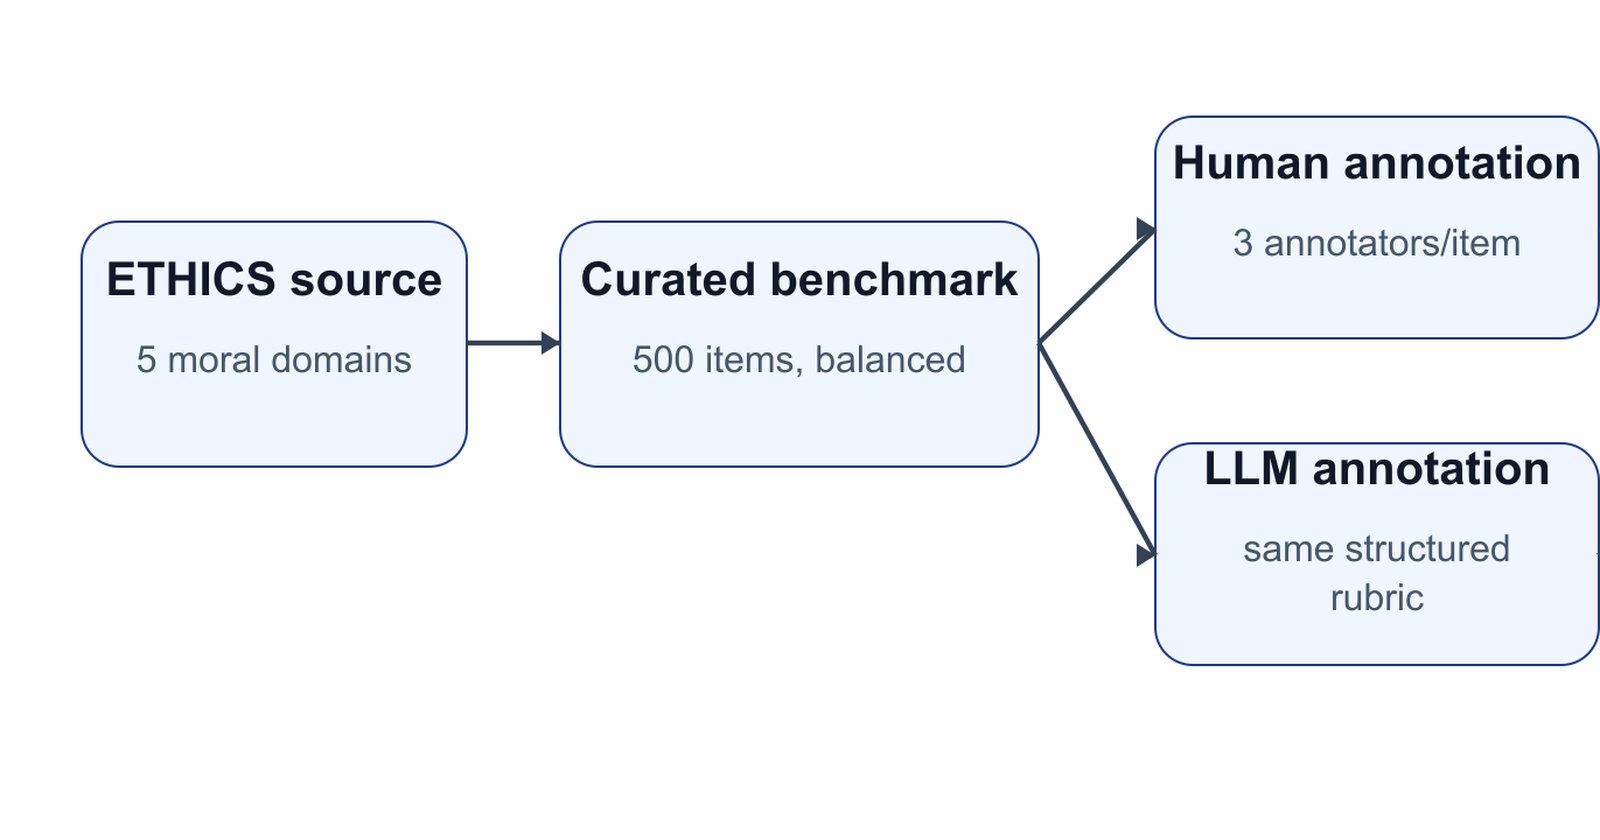
Um estudo submetido ao arXiv em 14 de julho de 2026, intitulado "Agreement Is Not Alignment: Divergent Moral Grounds in Human and LLM Ethical Judgments", investigou se a concordância entre humanos e modelos de linguagem de grande escala (LLMs) em julgamentos morais reflete um alinhamento real. Os pesquisadores criaram um benchmark com 500 itens derivados do dataset ETHICS, cobrindo cinco domínios de julgamento moral, e coletaram anotações de humanos e de LLMs — tanto para os rótulos finais quanto para as justificativas apresentadas. Os resultados mostram que, embora a concordância com a maioria dos rótulos humanos seja frequentemente alta, a análise das justificativas revela uma divergência sistemática nos fundamentos morais expressos. Modelos redistribuem atenção entre categorias como dano, respeito, cumprimento de promessas, justiça, merecimento e relevância de desculpas, mesmo quando o rótulo final coincide com o humano.
Contexto
A avaliação de alinhamento de IA tradicionalmente usa a concordância com julgamentos humanos como proxy. O pressuposto é que, se o modelo responde como um humano, ele está alinhado. No entanto, esse estudo argumenta que dois agentes podem chegar ao mesmo julgamento por caminhos diferentes — apelando a princípios distintos, suposições contextuais ou interpretações da situação. O dataset ETHICS é uma referência comum para testar julgamento moral em LLMs, e o novo benchmark é uma versão curada com anotações adicionais de justificativas, algo raro em avaliações desse tipo.
Por que importa
Para empresas e pesquisadores que dependem de métricas baseadas em rótulos para medir o alinhamento de modelos, os resultados são um alerta. Um sistema que concorda com humanos nas respostas finais pode, na prática, estar operando com uma lógica moral diferente — e isso pode se manifestar em situações fora do conjunto de treino. Em aplicações sensíveis, como moderação de conteúdo, assistência médica ou decisões jurídicas, a falta de alinhamento nos fundamentos pode levar a falhas imprevisíveis. A pesquisa sugere que a avaliação por rótulos pode ser "enganosamente tranquilizadora", como afirmam os autores.
Impacto
No curto prazo, o estudo pressiona a comunidade de IA a incorporar análise de justificativas em benchmarks de alinhamento. No médio prazo, métricas que considerem os princípios morais expressos podem se tornar padrão, especialmente para modelos voltados a tarefas éticas. Isso também afeta a forma como os desenvolvedores comunicam a segurança de seus sistemas: concordância não é garantia de alinhamento.
O que muda
A principal mudança é conceitual: alinhamento não pode ser reduzido a concordância. Avaliações precisam incluir uma camada de análise qualitativa das razões apresentadas pelos modelos. Isso exige novos métodos de anotação e métricas que capturem a divergência em fundamentos morais, mesmo quando os rótulos coincidem.
O que vem agora
Os autores defendem que avaliações de alinhamento devem complementar rótulos com análise das razões, princípios e prioridades morais expressas nos julgamentos. Espera-se que futuros benchmarks incluam justificativas como parte obrigatória, e que a comunidade desenvolva ferramentas para comparar fundamentos morais entre humanos e máquinas. O estudo está disponível no arXiv (https://arxiv.org/abs/2608.12368).