
ContractEval: framework audita conformidade de agentes de IA
Framework transforma instruções procedurais em obrigações ativas por consulta e aponta omissões, branches errados e violações de invariantes
O que aconteceu
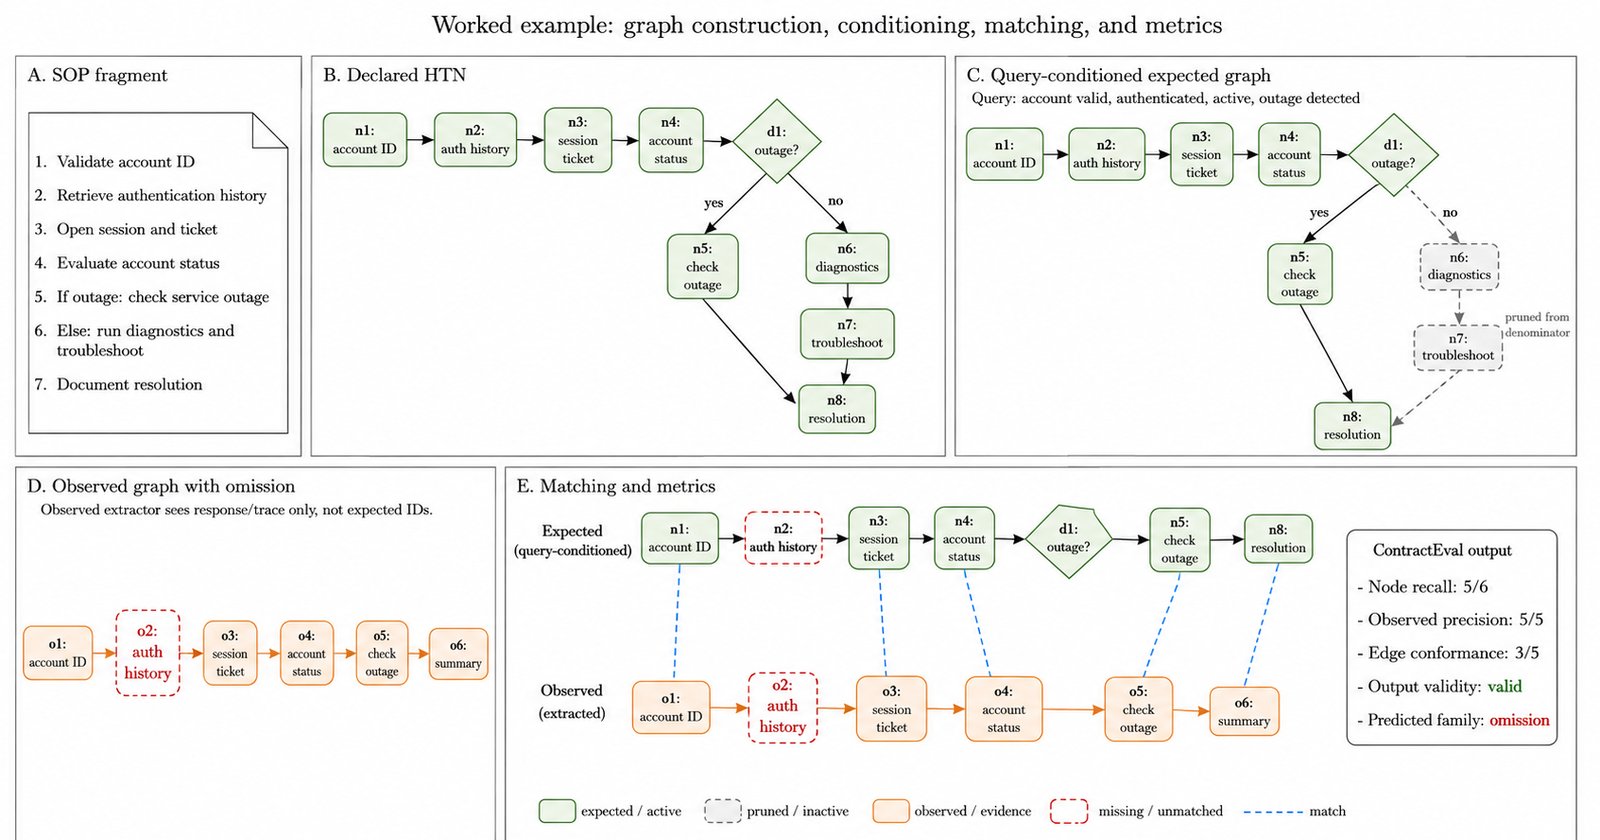
O paper "ContractEval: Query-Conditioned Execution Matching for Procedural Instruction Conformance" foi submetido em 8 de setembro de 2026 e divulgado como arXiv:2609.09458v1, na categoria Computer Science > Artificial Intelligence. O ContractEval, framework proposto no artigo, representa instruções procedurais como obrigações ativas por consulta, as chamadas query-active obligations.
A mecânica é direta: o ContractEval confronta essas obrigações com evidências extraídas da resposta final ou do trace de execução. Ao fazer isso, converte em categorias distintas de falha de conformidade seis tipos de problema: omissões, escolha de branches errados, erros de ordenação, ações extras, violação de invariantes e violação de contrato de saída.
A avaliação descrita no artigo aponta uma cegueira nas abordagens atuais. A avaliação que olha apenas a saída vê a resposta. O julgamento que examina o trace vê atividade. Nenhuma das duas identifica quais obrigações estavam ativas para aquela consulta específica. É exatamente essa lacuna que o ContractEval tenta fechar.
Os resultados vêm de uma suíte controlada de contratos procedurais auditados. Nessa suíte, juízes baseados em LLM, tanto os que avaliam só a saída quanto os que olham o trace, deixam passar muitas falhas estruturais injetadas de propósito. Quando recebe como entrada os grafos de referência (gold) de obrigações esperadas e observadas, o ContractEval detecta e localiza todas elas, segundo o artigo.
Há uma ressalva relevante. Quando a extração de obrigações é feita por LLM em vez de pelos grafos gold, o framework preserva boa parte do sinal, mas continua sensível à calibração do modelo extrator.
Contexto
O ponto de partida do paper é uma mudança de função dos agentes de LLM. Eles deixaram de apenas responder perguntas e passaram a executar procedimentos, com checagens, dependências, ramificações e invariantes. Nesse tipo de tarefa, a falha nem sempre aparece como erro visível. O artigo descreve esse fenômeno como falha injustificada: a resposta final parece boa, mas o caminho que a justificaria não foi percorrido.
As duas famílias de avaliação disponíveis hoje têm limites claros. Benchmarks de resposta final medem qualidade do texto produzido. Avaliadores que leem o trace medem atividade, ou seja, o que o sistema fez. O ContractEval, framework de diagnóstico apresentado no arXiv, se posiciona em uma terceira camada: a das obrigações que estavam ativas naquela consulta.
Por que importa
Para quem coloca agentes de IA dentro de processos que precisam de auditoria, a diferença é grande. Uma resposta bem escrita não prova que a checagem obrigatória foi executada, que a dependência correta foi consultada ou que a invariante foi respeitada. O ContractEval torna a conformidade procedural auditável em vez de implícita na qualidade da resposta final.
O ganho prático aparece na classificação. Em vez de um veredito binário sobre a resposta, a equipe recebe o tipo de falha: omitiu, escolheu o branch errado, ordenou mal, fez ação extra, quebrou invariante, violou contrato de saída. Isso muda o encaminhamento do erro, que deixa de ser tratado como problema de prompt e passa a ser tratado como problema de execução.
Impacto
No curto prazo, o efeito mais concreto é metodológico. Equipes de avaliação ganham uma taxonomia para nomear falhas estruturais que hoje passam despercebidas por juízes de LLM. O artigo mostra que esses juízes erram em muitos casos injetados, e essa constatação sozinha já questiona painéis de avaliação que só olham a resposta final.
No médio prazo, o gargalo está declarado no próprio paper: a extração de obrigações feita por LLM é sensível à calibração. Enquanto isso não for resolvido, o uso em produção tende a ficar restrito a cenários em que as obrigações podem ser especificadas de forma estruturada, próximas do que o artigo chama de grafos gold.
O ContractEval não é uma garantia de compliance. Os próprios autores afirmam que o framework torna a conformidade procedural auditável, e não que ele assegura que o procedimento foi cumprido.
O que muda
A métrica principal se desloca. Sai de cena a pergunta "a resposta final está boa?" e entra a pergunta "as obrigações ativas para esta consulta foram cumpridas?". O ContractEval, framework descrito no artigo do arXiv, opera justamente nesse segundo eixo, comparando obrigações esperadas com evidências observadas.
Para agentes de LLM que executam procedimentos, isso cria uma trilha de verificação separada da qualidade textual. A consequência é que a avaliação de um agente passa a ter duas camadas: a da resposta e a da execução.
O que vem agora
O paper não anuncia cronograma de produto, versão de código aberto ou adoção por empresas. O que o artigo deixa registrado é o estado atual do método: funciona com grafos gold, preserva parte do sinal com extração via LLM e depende de calibração nesse segundo caso.
O caminho de pesquisa indicado é reduzir essa dependência de calibração, para que a extração automática de obrigações chegue perto do desempenho obtido com os grafos de referência. Até lá, o ContractEval se apresenta como ferramenta de diagnóstico e auditoria, não como selo de conformidade.
Fontes
- arXiv cs.AI, ContractEval: Query-Conditioned Execution Matching for Procedural Instruction Conformance (arXiv:2609.09458v1, submetido em 8 de setembro de 2026): https://arxiv.org/abs/2609.09458