
DAREBench: novo benchmark avalia 35 modelos de IA como agentes em 233 tarefas
Estudo no arXiv testa modelos comerciais e open-weight em matriz de cargas de trabalho e conclui que nota única engana na hora de escolher modelo
O que aconteceu
Pesquisadores submeteram ao arXiv, em 5 de setembro de 2026, o artigo "DAREBench: Deployment-Aware and Reliable Evaluation of Models as Agents" (arXiv:2609.06059). O DAREBench, cujo nome completo é Deployment-Aware and Reliable Evaluation of Models as Agents, é um benchmark criado para avaliar modelos de linguagem em papel de agente, ou seja, executando tarefas de múltiplas etapas com uso de ferramentas e entrega de artefatos, e não apenas respondendo perguntas.
Os números do estudo são concretos. O DAREBench organiza 233 tarefas, selecionadas e adaptadas de 22 benchmarks de origem, em uma matriz de cargas de trabalho 2x3 definida por modalidade de entrada e forma de execução. A avaliação cobriu 23 modelos comerciais acessados por API e 12 modelos open-weight implantados localmente, somando 7.587 rodadas de execução modelo-tarefa. Todas as tarefas rodam em um ambiente de execução compartilhado chamado OpenClaw, sob um protocolo unificado baseado em contratos, com auditoria de pontuação baseada em evidências.
Contexto
O problema que motivou o DAREBench é conhecido de quem acompanha o setor. Modelos de linguagem de grande porte deixaram de ser sistemas de perguntas e respostas e viraram agentes de uso geral. Avaliar essa nova função exige medir percepção multimodal, execução em múltiplas etapas, uso de ferramentas e entrega de artefatos.
Os benchmarks existentes, segundo o artigo, costumam estar presos a tipos específicos de tarefa, ambientes de execução próprios ou protocolos de pontuação particulares. Isso limita comparabilidade, interpretabilidade e confiabilidade quando a decisão é de implantação real. O DAREBench ataca exatamente esse ponto: ao unificar 22 benchmarks de origem em um único ambiente, o OpenClaw, e em um protocolo com auditoria de evidências, o benchmark permite comparar modelos em condições iguais.
Por que importa
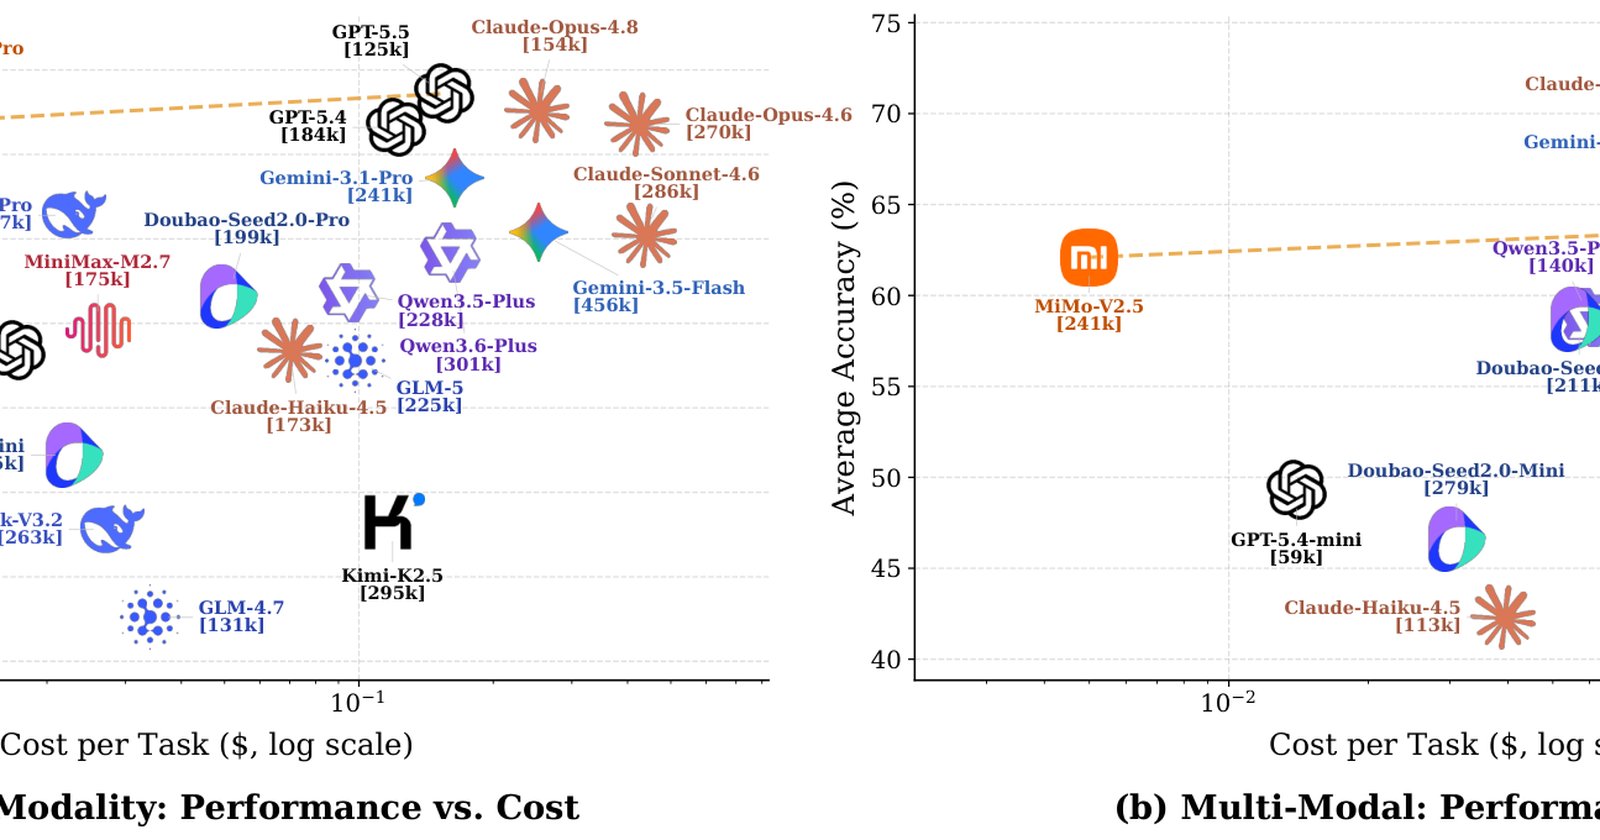
Os resultados do DAREBench derrubam a ideia de que existe um campeão absoluto. O estudo mostra que nenhum modelo domina todos os grupos de carga de trabalho. Tarefas de texto e tarefas multimodais apresentam trade-offs distintos entre acurácia e custo. Os modelos open-weight locais são competitivos em vários grupos, mas ainda ficam atrás dos modelos comerciais de fronteira no conjunto geral.
Para empresas que escolhem modelos, a mensagem é direta: confiar em uma única pontuação agregada pode levar à decisão errada. O artigo sugere que a seleção de modelos e a implantação de agentes devem considerar o perfil de carga de trabalho, o modo de implantação e o equilíbrio entre acurácia e custo.
Impacto
Na prática, o DAREBench oferece três ganhos. Primeiro, comparabilidade: 35 modelos avaliados no mesmo ambiente, o OpenClaw, com o mesmo protocolo contratual. Segundo, confiabilidade: a auditoria de pontuação baseada em evidências reduz o risco de notas infladas por falhas de avaliação. Terceiro, transparência de custo: o estudo reporta acurácia e consumo de tokens, além de custos de referência para os modelos de API.
Para o mercado de modelos abertos, o dado relevante é que os 12 modelos open-weight locais competem de perto em vários grupos de tarefa. Para quem roda infraestrutura própria, isso reforça a tese de que implantação local pode fazer sentido dependendo do perfil de carga, mesmo sem liderança geral.
O que muda
O que muda com o DAREBench é o critério de decisão. Em vez de olhar um ranking único, times de engenharia e produto passam a ter um retrato por grupo de carga: como cada modelo se sai em texto versus multimodal, em cada forma de execução, e a que custo em tokens. A matriz 2x3 do benchmark, construída a partir de 233 tarefas de 22 benchmarks de origem, funciona como um mapa de escolha.
O que vem agora
O artigo foi submetido ao arXiv em 5 de setembro de 2026 e está disponível para leitura em PDF e HTML na plataforma. O próximo passo natural, típico de benchmarks desse tipo, é a adoção pela comunidade: se o ambiente OpenClaw e o protocolo contratual forem incorporados por outros grupos de pesquisa, o DAREBench pode se tornar referência para decisões de implantação de agentes. O próprio artigo deixa a direção clara: avaliação de agentes precisa capturar variação de carga de trabalho e ser confiável o bastante para sustentar decisões reais de deployment.