
DARS: framework de RL resolve problema central de treino em edição de imagens por IA
Novo framework de reforço calcula quem merece o crédito — planner ou renderer — e melhora edits com instruções em linguagem natural
O que aconteceu
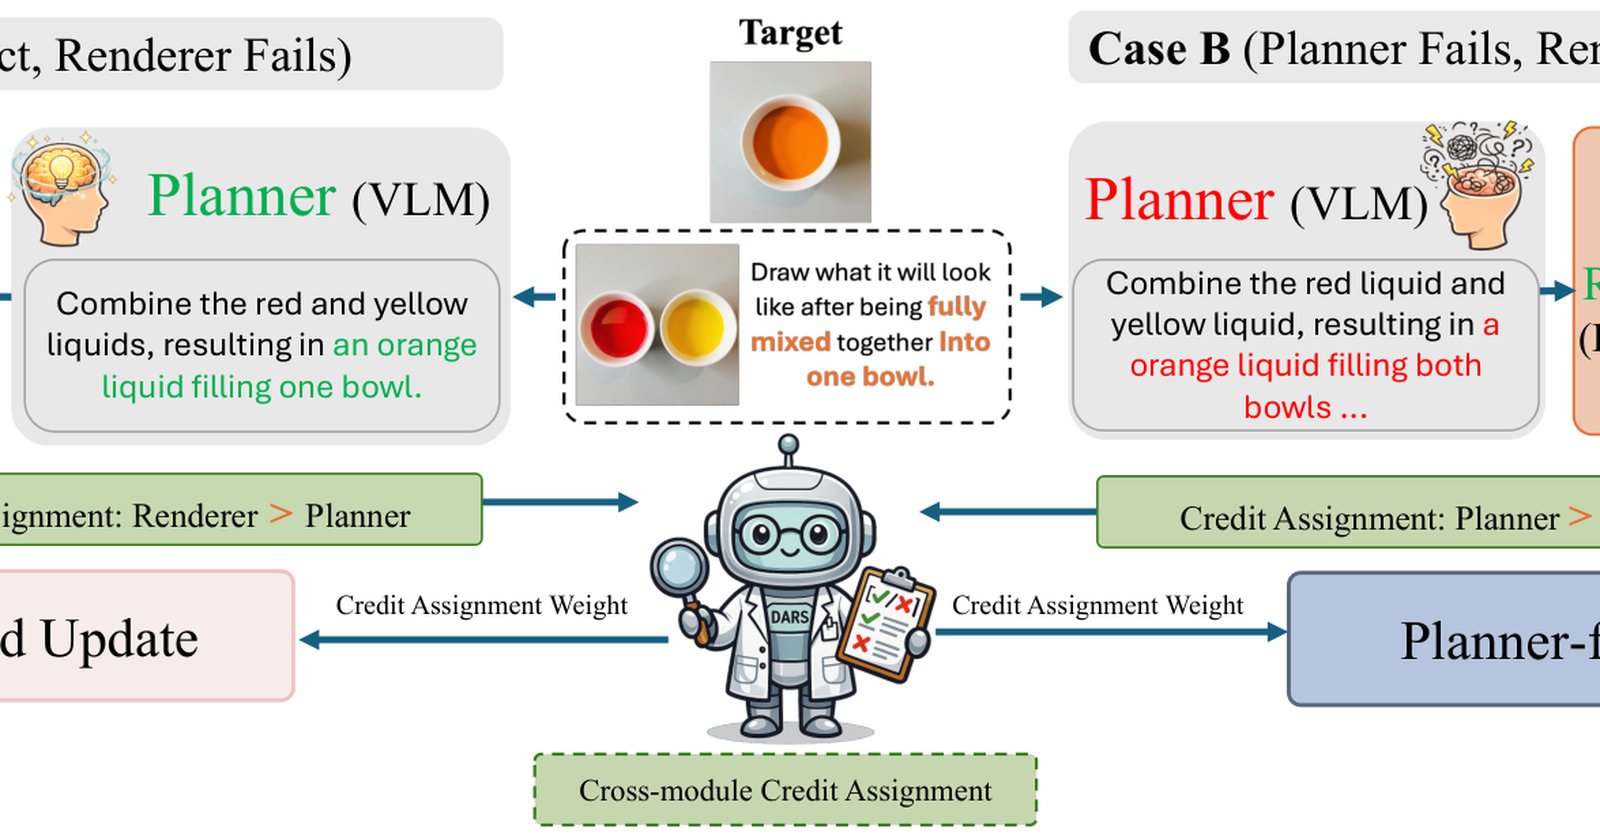
Pesquisadores publicaram no dia 20 de agosto de 2026 o paper "DARS: Dual-Level Credit Assignment RL with Structured Reasoning for Instruction-Based Image Editing" (arXiv:2608.20161). O trabalho apresenta um framework de reinforcement learning (RL) que divide a responsabilidade entre os dois módulos de um sistema de edição de imagens por instrução: o planner (um modelo de visão e linguagem que converte o comando em plano de edição) e o renderer (um modelo de difusão que executa o plano).
O problema central que o DARS ataca é a ineficiência do treino com recompensa apenas na imagem final. Quando a edição falha, o sistema não consegue localizar se o erro veio do planner, do renderer ou de ambos — e esse sinal de feedback vago travava a otimização.
Nos experimentos realizados em cinco benchmarks, o DARS superou um baseline de RL joint com o mesmo backbone, dados, modelo de recompensa e orçamento de rollouts. Os maiores ganhos apareceram em edições que exigem raciocínio complexo.
Contexto
Edição de imagens por instrução segue uma pipeline de dois estágios: primeiro o VLM interpreta o que o usuário quer (ex.: "troque o céu por um pôr do sol"), depois o diffusion model renderiza a edição. Essa separação é funcional, mas cria um problema de treino com RL: a recompensa binária (a imagem final ficou boa ou não) não permite atribuir crédito granular a cada etapa.
Isso significa que, num treino convencional, o sistema não diferencia um planner ruim de um renderer ruim. O resultado é convergência lenta e desperdício de computação, especialmente em edits que demandam raciocínio multi-passo.
Por que importa
O DARS introduz atribuição de crédito em dois níveis. Entre os módulos (inter-planner), roda múltiplos planos com múltiplos renders para medir a variabilidade de recompensa — isso permite um "roteamento suave" que adapta o peso entre planner e renderer a cada caso. Dentro do planner (intra-planner), uma saída de raciocínio estruturado em quatro campos permite recompensa com prefixo filtrado e reponderância de vantagem no nível de token. Em vez de apenas dizer "ficou bom/ruim", o feedback se localiza no trecho do raciocínio que falhou.
Para quem trabalha com modelos generativos, o impacto prático é claro: treino mais eficiente, melhor convergência em casos complexos e menos desperdício de rollouts em cenários onde o sinal de recompensa era fraco.
Impacto
O resultado mais relevante é o ganho desproporcional em edições "reasoning-intensive" — aquelas que exigem interpretação contextual, não apenas operações visuais diretas. Isso indica que a fronteira de qualidade em edição de imagens por IA não está só no renderer, mas na capacidade do planner de raciocinar e estruturar seu output. Sistemas que integrarem o DARS ou técnicas similares devem apresentar ganhos perceptíveis em precisão de edits semânticos.
Do ponto de vista acadêmico, o framework oferece uma arquitetura reutilizável para qualquer pipeline planner-renderer com treino via RL, não apenas edição de imagens.
O que vem agora
O paper foi publicado como preprint no arXiv em 20 de agosto de 2026. Não há código ou modelo público anunciado até o momento. O próximo passo esperado é validação em ambientes de produção e possível integração com pipelines de edição já existentes (como as baseadas em InstructPix2Pix ou modelos proprietários). A comunidade de pesquisa em RL para modelos generativos deve absorver a técnica de structured reasoning output para além do domínio de imagem.
Fontes
- arXiv: DARS: Dual-Level Credit Assignment RL with Structured Reasoning for Instruction-Based Image Editing (https://arxiv.org/abs/2608.20161)