
DASO: otimização consciente de dificuldade para recomendações generativas
Técnica de pós-treino reatribui rollouts na árvore de IDs semânticos e melhora recall em benchmarks públicos e internos.
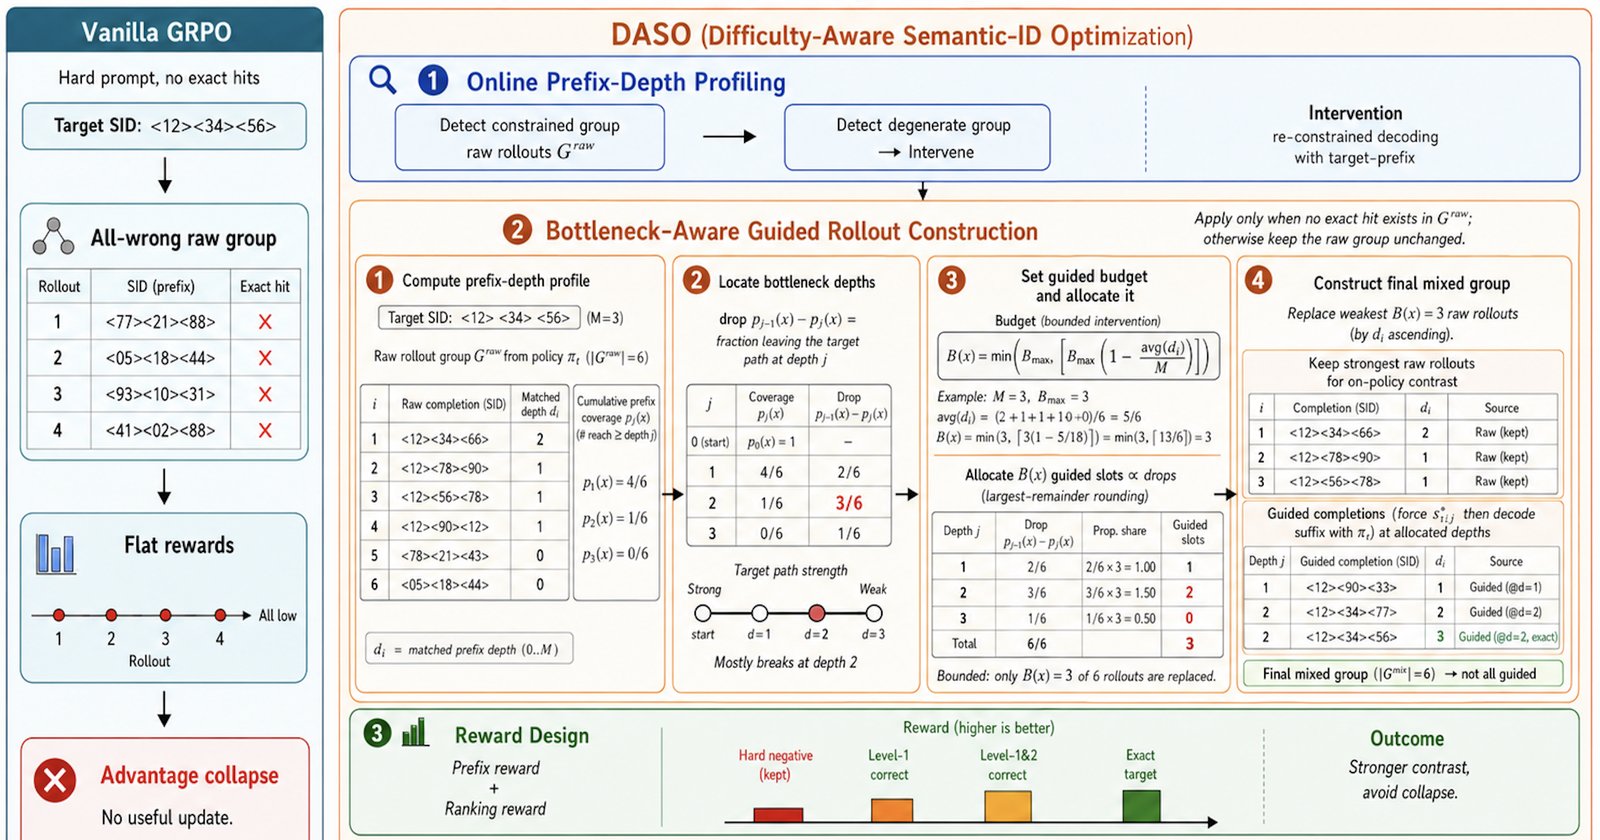
O que aconteceu
Pesquisadores publicaram no arXiv (arXiv:2608.20611v1) um artigo que propõe a Difficulty-Aware Semantic-ID Optimization (DASO), um método de pós-treino para sistemas de recomendação generativa que usam IDs semânticos hierárquicos. A técnica redefine o problema como uma alocação online de rollouts, em vez de usar buckets fixos de dificuldade.
A DASO melhora o desempenho sobre o GRPO no estilo MiniOneRec em 11 das 12 métricas dos benchmarks públicos, e alcança o melhor resultado absoluto em 9 delas. Em tarefas internas de recomendação, ela também melhora a maioria das métricas de recall por nível.
O artigo foi submetido em 20 de agosto de 2026 e está classificado na área de Computer Science > Artificial Intelligence.
Contexto
Sistemas de recomendação generativa baseados em IDs semânticos convertem recuperação e ranqueamento em geração autorregressiva sobre identificadores hierárquicos de itens. A receita mais comum é aplicar SFT (Supervised Fine-Tuning) seguido de GRPO (Group Relative Policy Optimization).
O problema, segundo o artigo, é que o GRPO vanilla se ajusta mal a tarefas estruturadas em árvore. Com o checkpoint SFT congelado, o alvo exato está ausente das primeiras 16 candidatas de um ranking restrito de 50 beams para muitos prompts. Em casos mais difíceis, nenhuma dessas candidatas sequer entra no ramo do ID semântico alvo.
Esse diagnóstico em nível de prompt motivou uma preocupação de treinamento: quando os grupos de GRPO on-policy também estão sem o alvo, recompensas em nível de item podem produzir variação fraca ou degenerada, mesmo que alguns candidatos sigam parte do caminho correto.
A DASO foi criada para tratar esse modo de falha de forma direta. Em vez de injetar completions de verdade ancoradas uniformemente, ela perfila cada grupo de rollout atual pela profundidade de correspondência de prefixo, localiza os níveis de ID mais críticos e reatribui uma porção limitada do grupo para completions guiadas por prefixo, mantendo os rollouts brutos para contraste.
Por que importa
A técnica ataca um gargalo real de sistemas de recomendação generativa: o treinamento com recompensas fracas em tarefas em árvore. Sem essa correção, o modelo tende a se saturar em soluções degeneradas, sem explorar caminhos parciais corretos.
A reatribuição dinâmica de rollouts e a recompensa por prefixo de ID (SID-prefix reward) fornecem crédito graduado para candidatos que seguem parte do caminho. Isso é mais informativo que uma recompensa binária em nível de item.
Além disso, a DASO inclui uma âncora SFT auxiliar para mitigar regressão em exemplos já resolvidos pelo checkpoint SFT. Esse cuidado evita que o pós-treino desaprenda o que o modelo já sabia.
Impacto
Para plataformas de e-commerce, streaming e conteúdo, o ganho de recall nível a nível significa recomendações mais precisas em catálogos grandes e hierárquicos. A melhora de 9 de 12 métricas absolutas no benchmark público indica que a abordagem pode ser integrada a pipelines existentes de SFT + GRPO sem reestruturação completa do modelo.
A DASO também serve como alternativa ao uso de buckets fixos de dificuldade, que exigem calibração manual e muitas vezes não refletem a dificuldade real por prompt. A adaptação online é mais robusta a variações na distribuição de dificuldade dos dados.
O que muda
Para a comunidade de pesquisa, a DASO propõe uma nova formulação: tratar a falha do GRPO em árvores como um problema de alocação de rollouts, e não como mero ajuste de hiperparâmetros. Isso abre caminho para técnicas que combinam diagnóstico por prefixo com recompensas graduadas.
Para engenheiros de ML, o método é implementável sobre a arquitetura SFT + GRPO existente, exigindo apenas a lógica de profiler de prefixo e a reatribuição limitada de amostras. O custo computacional extra é contido, já que apenas uma porção do grupo é redirecionada.
O que vem agora
O artigo não publica código nem detalha datas de lançamento. A expectativa é que os autores divulguem os pesos e o script de treinamento nos próximos meses, seguindo o padrão comum de papers de ML. Também deve surgir uma versão estendida com análises de ablação mais profundas sobre o efeito da âncora SFT.
Para sistemas industriais, o próximo passo natural é testar a DASO em pipelines de recomendação com catálogos maiores, onde a hierarquia de IDs semânticos é mais profunda e o gargalo de prefixo tende a ser mais severo.