
DevRev NL2SQL: benchmark com 900 consultas desafia sistemas de linguagem natural para SQL
Paper no arXiv apresenta benchmark com 900 consultas verificadas e arquitetura agêntica consciente de custo para esquemas empresariais aninhados
O que aconteceu
Um novo estudo sobre conversão de linguagem natural para SQL foi publicado no arXiv em 4 de setembro de 2026, sob o número 2609.04641v1, com submissão registrada por Yoga Sri Varshan Varadharajan. O trabalho, intitulado "A Cost-Aware Agentic Architecture for NL-to-SQL over Nested Enterprise Schemas, with a New Benchmark", faz duas contribuições complementares.
A primeira é o benchmark DevRev NL2SQL: 900 consultas verificadas por execução, construídas com tipos aninhados e estrutura de grafo de links, características típicas de esquemas empresariais reais. O benchmark vem acompanhado do Semantic Depth Score (SDS), uma rubrica independente de esquema para medir a profundidade do raciocínio analítico exigido de cada consulta.
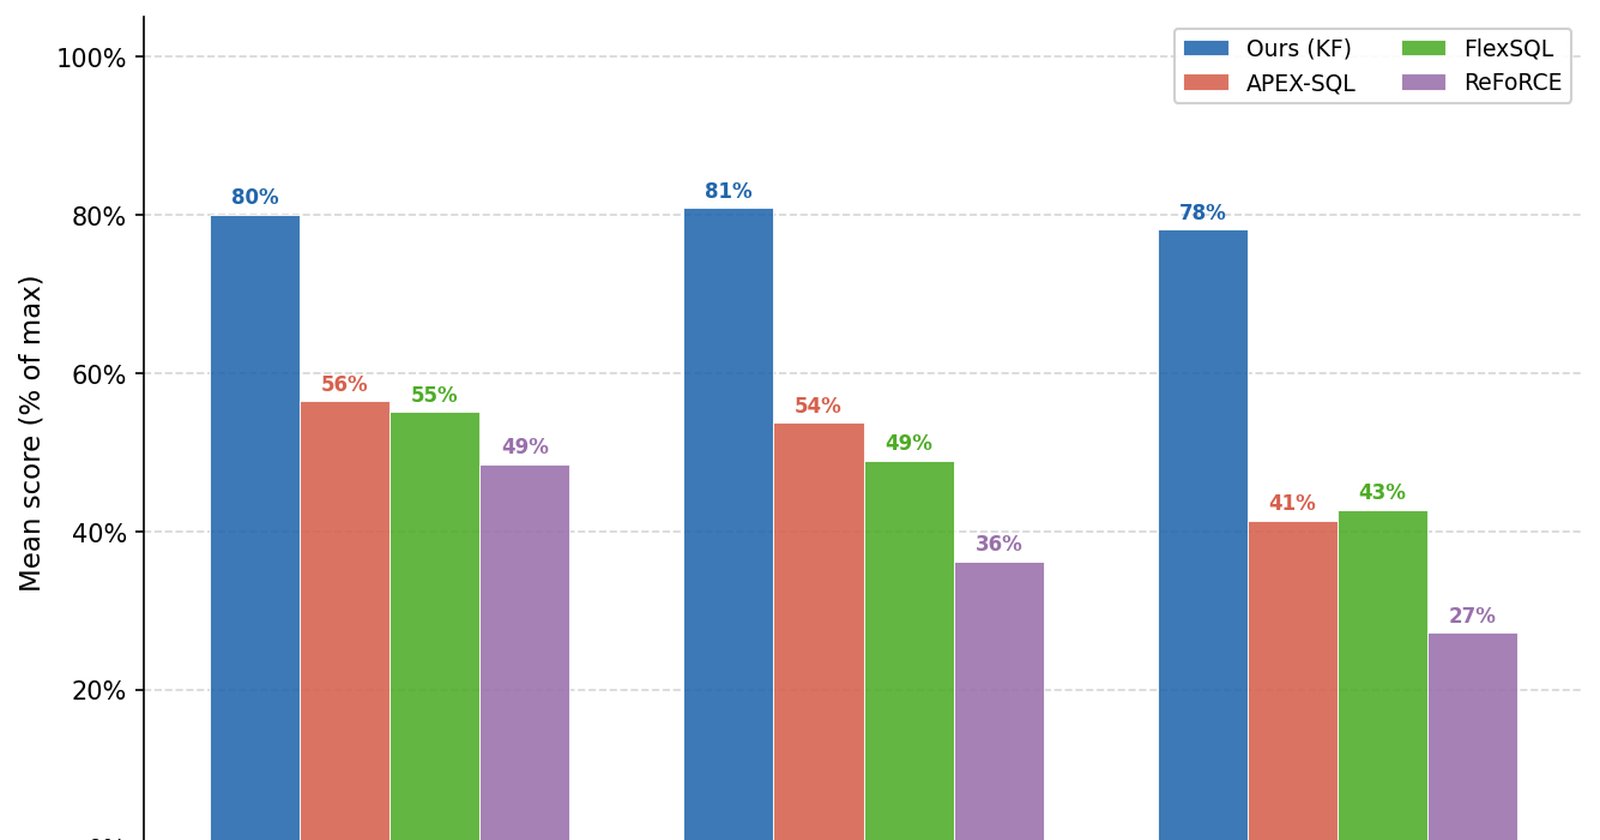
A segunda contribuição é uma arquitetura agêntica de geração única, consciente de custo, cujos componentes de seleção de esquema, recuperação de metadados e reparo de erros foram desenhados para as exigências desse regime de dados. O sistema da DevRev atinge 91,7% de correção de respostas no próprio benchmark, uma vantagem de 54,6 pontos percentuais sobre o próximo melhor baseline. No dataset público Spider 2.0 Snowflake, a arquitetura se mostra competitiva com os sistemas líderes operando em um ponto único de geração.
Contexto
Os sistemas de natural-language-to-SQL avançaram rapidamente nos benchmarks acadêmicos, mas os autores do paper apontam um descompasso: os esquemas em produção nas empresas exibem estrutura semiestruturada, semelhante a grafos e profundamente aninhada, algo que os benchmarks atuais não medem. Em outras palavras, os números altos obtidos em laboratório não garantem desempenho quando o modelo enfrenta um esquema corporativo de verdade.
O Spider 2.0 Snowflake, dataset público usado na validação, representa a tentativa anterior de aproximar os testes de condições reais. O benchmark DevRev NL2SQL vai além ao incluir explicitamente tipos aninhados e relações de grafo, com cada uma das 900 consultas verificada por execução real, não apenas por comparação de strings SQL.
Por que importa
Quem já implementou perguntas em linguagem natural sobre bancos corporativos conhece o problema: as perguntas simples funcionam, e as que exigem atravessar múltiplas relações aninhadas falham. O SDS proposto no paper dá às equipes uma forma padronizada de medir essa profundidade analítica, independentemente do esquema usado.
O detalhe "cost-aware" também pesa. A arquitetura opera em ponto único de geração, o que reduz o número de chamadas a LLMs por consulta. Em escala empresarial, onde milhões de consultas podem ser processadas, a diferença entre uma arquitetura de múltiplas gerações e uma de geração única aparece direto na fatura de inferência.
Impacto
A margem de 54,6 pontos percentuais sobre o próximo melhor baseline no benchmark DevRev NL2SQL sugere que os sistemas existentes, treinados e ajustados para benchmarks planos, não estavam preparados para estruturas aninhadas. Para fornecedores de ferramentas de analytics conversacional, o novo benchmark se torna um teste de estresse adicional antes de prometer cobertura sobre esquemas corporativos complexos.
O desempenho competitivo no Spider 2.0 Snowflake indica que a arquitetura não sacrifica desempenho nos testes públicos já consolidados para ganhar no novo cenário aninhado. Isso fortalece a tese central do paper: o gargalo estava na medição, e corrigir a medição expõe onde os sistemas realmente falham.
O que muda
Para o mercado de NL2SQL, o benchmark DevRev NL2SQL e o Semantic Depth Score oferecem um novo padrão de avaliação focado em profundidade de raciocínio analítico. Equipes que avaliam fornecedores de text-to-SQL passam a ter um conjunto de 900 consultas verificadas por execução que reproduz a estrutura de grafos e aninhamento dos esquemas empresariais, em vez de depender apenas de benchmarks acadêmicos planos.
O que vem agora
O paper está disponível no arXiv sob o identificador 2609.04641, com PDF e versão HTML experimental. Os próximos passos esperados envolvem a adoção do benchmark por outros grupos de pesquisa e a comparação de sistemas concorrentes sob o Semantic Depth Score. O material associado ao paper, incluindo código e dados, está listado nas ferramentas de referência do arXiv, o que deve facilitar replicações independentes dos resultados de 91,7% de correção reportados pela equipe da DevRev.