
DirEAG: novo método calibra confiança verbalizada de LLMs em raciocínio matemático
Técnica usa agregação de evidências de Dirichlet para reduzir erros de calibração em modelos como Qwen, Mistral e Gemma.
O que aconteceu
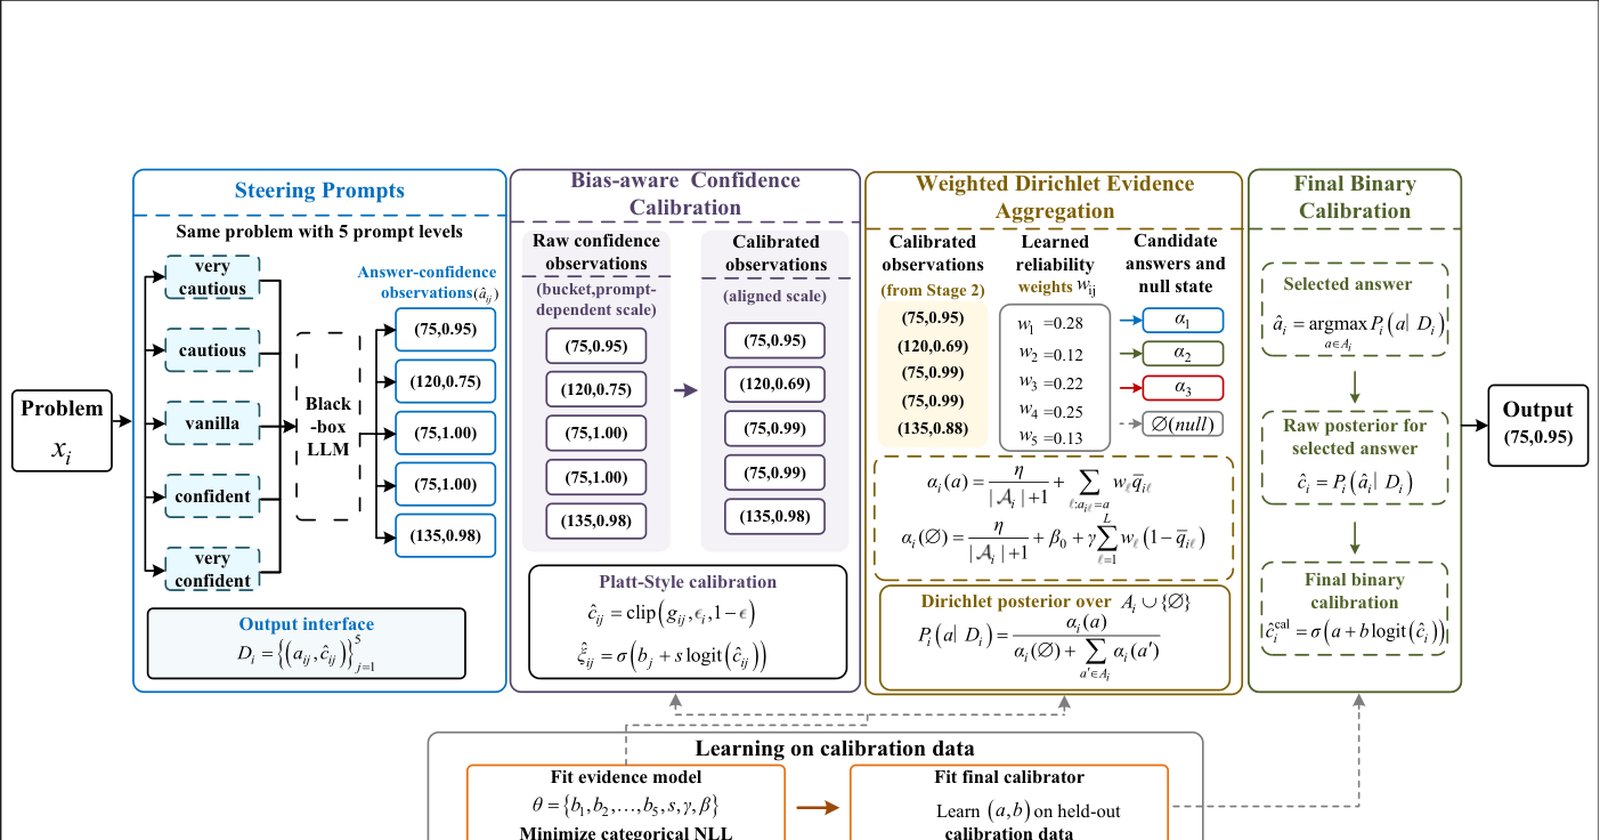
O arXiv recebeu em 21 de agosto de 2026 o artigo "DirEAG: Dirichlet Evidence Aggregation for Calibrating Verbalized Confidence in Mathematical Reasoning" (arXiv:2608.20717). O trabalho, da área de Inteligência Artificial (cs.AI), propõe o DirEAG, um método de agregação de evidências de Dirichlet. Ele converte cada observação de resposta-confiança elicitada de um LLM em evidência soft calibrada, distribuída entre as respostas candidatas e um estado nulo adicional. Esse estado nulo permite ao modelo representar casos em que nenhuma das respostas geradas está correta.
O método foi testado em três conjuntos de dados de raciocínio matemático: GSM8K, SVAMP e GSM-Hard, usando os modelos Qwen, Mistral e Gemma. A comparação foi feita contra a média direta da confiança (direct confidence averaging) e a agregação heurística de confiança (heuristic confidence-steering aggregation). Em várias configurações, o DirEAG alcançou melhor calibração, mantendo a seleção de respostas em nível competitivo.
O DirEAG, método proposto no artigo, trata de um problema específico: a confiança verbalizada por modelos em caixa preta (black-box) é difícil de calibrar. Quando o mesmo problema é consultado com múltiplos prompts que direcionam a confiança, as observações resultantes contêm informação útil de incerteza, mas as escalas mudam entre níveis de direcionamento, modelos e datasets.
Contexto
Métodos existentes de incerteza em caixa preta costumam depender de concordância de respostas, consistência de amostras ou entropia. Essas técnicas descrevem a variação da saída, mas não modelam o significado numérico da confiança autodeclarada pelo modelo. Por outro lado, a média direta ou a agregação heurística da confiança elicitada não conseguem aprender o viés dependente do prompt e da tarefa.
A dificuldade é recorrente em uso real de LLMs. Um sistema que diz ter 90% de confiança numa resolução matemática erra com frequência maior do que 10% das vezes, o que compromete a adoção em áreas como educação, finanças ou engenharia. O artigo aborda exatamente esse descompasso.
Por que importa
Para quem usa LLMs em tarefas analíticas, saber quando o modelo está seguro é tão importante quanto a resposta em si. A calibração de confiança permite que sistemas automatizados decidam quando pedir revisão humana, quando aceitar a resposta ou quando iniciar uma nova tentativa. O DirEAG oferece um caminho para isso sem acesso aos pesos internos do modelo, apenas às saídas.
O ganho prático aparece na seleção de respostas. Nos testes com GSM8K, SVAMP e GSM-Hard, o DirEAG manteve a qualidade da escolha da resposta correta, mesmo melhorando a calibração. Isso significa que o método não sacrifica precisão em troca de melhor estimativa de incerteza, um trade-off comum em abordagens anteriores.
Impacto
A agregação de evidências e a calibração binária final atacam partes distintas do problema de calibração, como mostram as ablações do estudo. A primeira parte lida com a conversão das observações em evidência útil; a segunda ajusta a probabilidade final em decisões binárias, como certo ou errado. Separar essas etapas permite ajustes finos em cada uma.
Para a indústria, a implicação é direta: provedores de APIs de LLMs, como Qwen, Mistral e Gemma, podem usar o DirEAG para oferecer pontuações de confiança mais confiáveis em seus endpoints de raciocínio. Uma aplicação imediata seria em plataformas de tutoria de matemática que dependem de avaliação automatizada.
O estado nulo é um diferencial. Ele cobre situações em que nenhuma das respostas candidatas está correta, algo que métodos que apenas escolhem entre candidatas ignoram. Isso reduz a confiança indevida em cenários de erro completo.
O que muda
O estudo muda a forma como se pensa a confiança verbalizada. Em vez de tratar as respostas autoavaliadas como números fixos, o DirEAG as transforma em evidência distribuída, aprendendo os vieses de prompt e tarefa. Isso é particularmente relevante para modelos de raciocínio matemático, onde a confiança declarada muitas vezes não reflete a real probabilidade de acerto.
A técnica também reduz a dependência de heurísticas manuais. Agregações simples, como tirar a média das confianças elicitadas, são substituídas por um processo aprendido que se adapta aos dados.
O que vem agora
O artigo não apresenta código público, mas o método é replicável a partir da descrição. Próximos passos prováveis incluem testes em mais modelos e datasets, além da integração com técnicas de geração de cadeia de pensamento. A validação em problemas matemáticos mais complexos, como os do GSM-Hard, indica que o caminho para aplicações de maior exigência está aberto.
Para a comunidade brasileira, o avanço sinaliza que a calibração de confiança deve acompanhar o crescimento do uso de LLMs em educação e análise de dados no país, onde o raciocínio matemático automatizado ainda enfrenta barreiras de confiabilidade.
Fontes
- arXiv: DirEAG: Dirichlet Evidence Aggregation for Calibrating Verbalized Confidence in Mathematical Reasoning (arXiv:2608.20717) - https://arxiv.org/abs/2608.20717