
Dual-Flow Transformers: separando prefill e decode para reduzir custo
Nova arquitetura de IA adiciona computação apenas na fase de decode, mantendo cache KV único
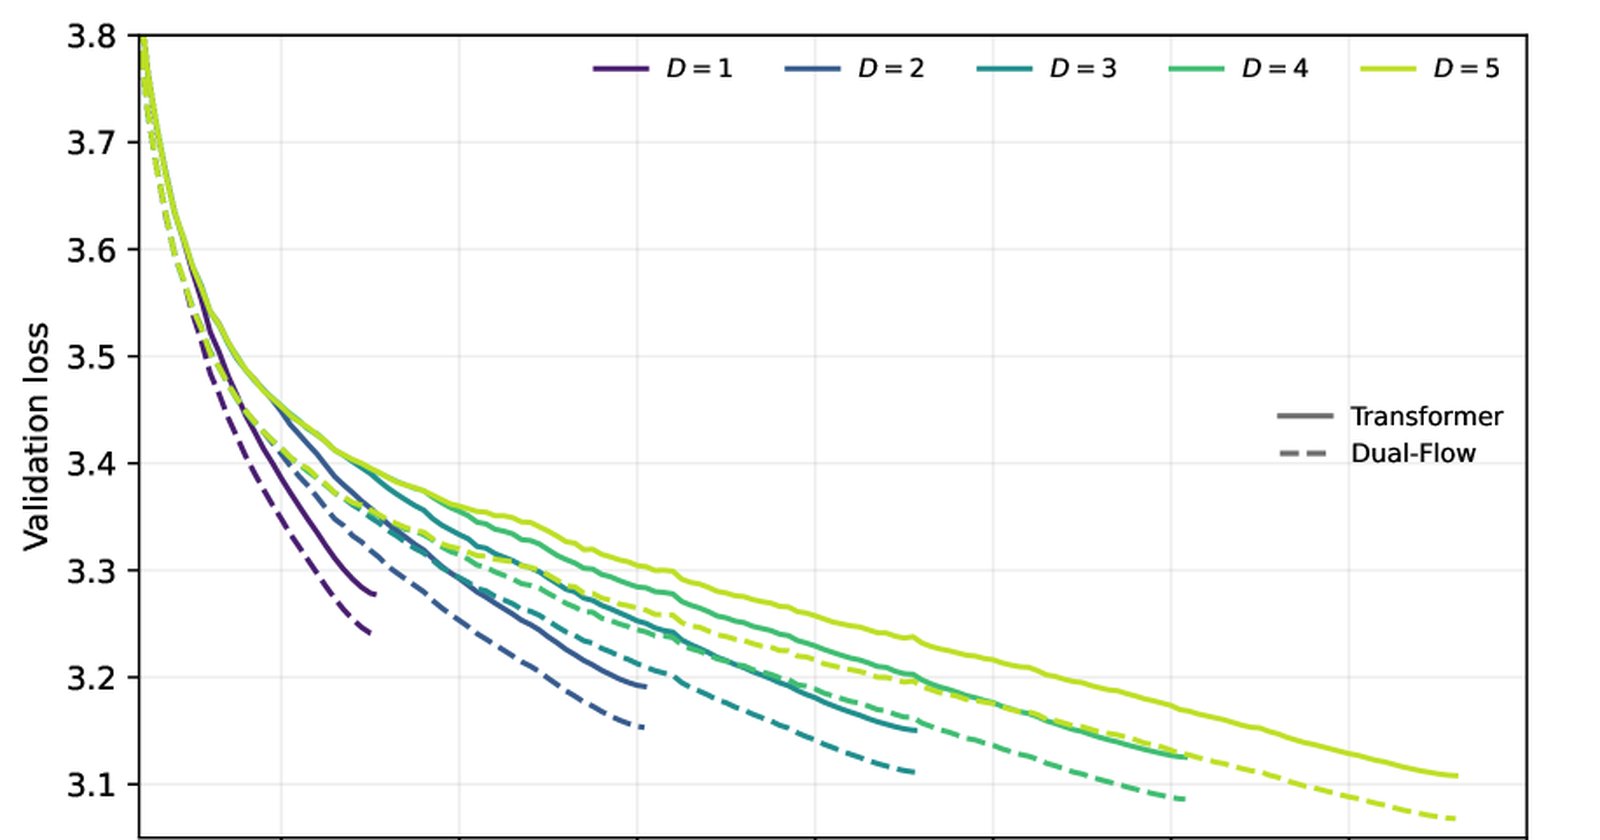
Pesquisadores propõem o Dual-Flow Transformer, uma arquitetura que separa a computação de prefill e decode para reduzir o custo cumulativo de inferência em modelos de linguagem de grande porte. O paper, submetido em 31 de julho de 2026 no arXiv, mostra que é possível adicionar computação apenas na fase de decode sem afetar o processamento do prompt.
O que aconteceu
O artigo arXiv:2608.12385 apresenta o Dual-Flow Transformer, que possui dois fluxos: o primário processa o prompt e escreve o cache de chave-valor (KV), enquanto o auxiliar é ativado apenas a partir da posição final do prompt, adicionando computação para predição de continuação sem escrever estado persistente. Os dois fluxos compartilham as principais matrizes de atenção, MLP e saída, mas usam embeddings separados e acoplamento leve. Em comparações com mesmo número de tokens, a arquitetura alcança menor perda de validação em diferentes arquiteturas e configurações de dados.
Contexto
O custo de inferência cumulativa está se tornando mais relevante que o custo de treinamento, especialmente com o aumento de requisições. As duas fases de inferência têm demandas distintas: o prefill é paralelo e limitado por computação, enquanto o decode é sequencial e limitado por largura de banda de memória. O escalonamento convencional de largura ou profundidade aumenta ambos os custos, pois cada camada é avaliada nas duas fases. O Dual-Flow propõe alocar computação adicional apenas para a predição de continuação, preservando a computação primária do prompt e um cache KV persistente.
Por que importa
A separação entre prefill e decode permite otimizar cada fase de forma independente, o que pode reduzir significativamente o custo por requisição em modelos de larga escala. Em modelos de mistura de especialistas (MoE), a separação torna os fan-outs de especialistas primários e auxiliares controles independentes sobre o custo do prompt, o custo da continuação e a qualidade preditiva. Isso abre espaço para ajustar a alocação de recursos conforme a demanda.
Impacto
A arquitetura pode influenciar o design de futuros LLMs, especialmente para serviços com alto volume de requisições. O compartilhamento de pesos e do cache primário também cria oportunidades de reutilizar pesos carregados e chaves/valores em cache durante a execução agrupada. Os experimentos revelam um trade-off entre prefill e decode, demonstrando o potencial da alocação de especialistas por fase.
O que muda
Para empresas que operam LLMs, a possibilidade de controlar o custo de decode sem afetar o prefill pode levar a implantações mais eficientes. A arquitetura também sugere que a qualidade do modelo pode ser melhorada com custo adicional apenas na fase de decode, o que é vantajoso para cenários de geração longa.
O que vem agora
Os pesquisadores estudaram dois regimes: aumentar a computação de decode com prefill fixo e realocar um orçamento fixo de decode entre os dois fluxos. Os próximos passos incluem explorar mais configurações e aplicações práticas. O paper está disponível no arXiv (https://arxiv.org/abs/2608.12385).