
Dude: sistema multiagente detecta divergências entre paper e código
Artigo submetido ao arXiv em setembro de 2026 reduz falsos positivos e melhora F1 em até 18,7%
O que aconteceu
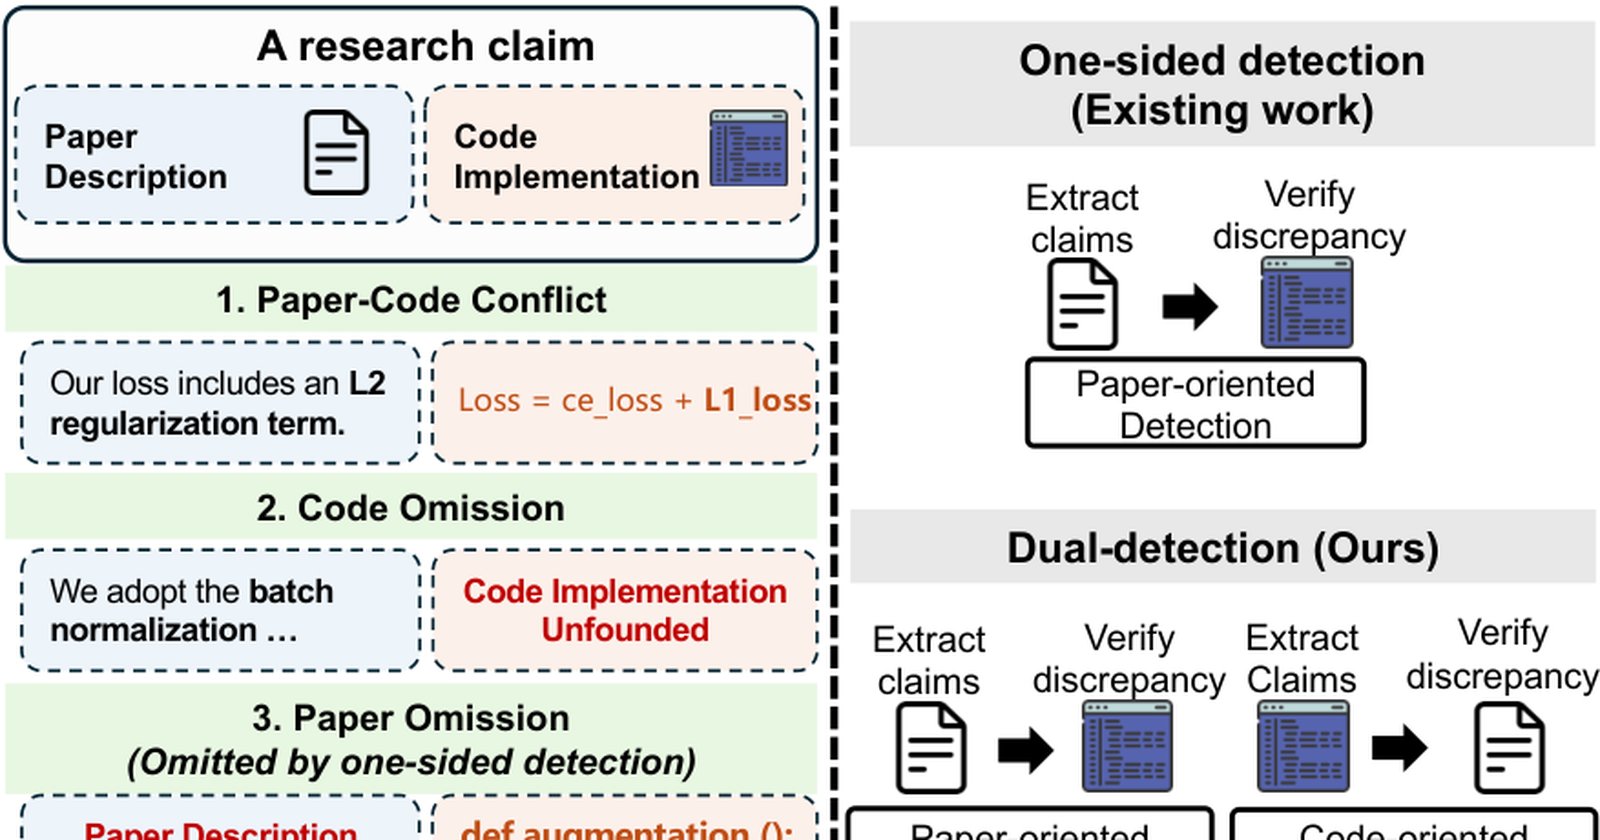
Os pesquisadores submeteram ao arXiv, em 3 de setembro de 2026, o artigo intitulado 'Dude: A Dual-Detection Multi-Agent System for Paper-Code Discrepancy Detection', classificado como Computer Science > Artificial Intelligence (cs.AI) e identificado como arXiv:2609.03416. O texto descreve o Dude, que os autores definem como o primeiro sistema de detecção dupla multiagente para averiguar discrepâncias entre um artigo científico e o código que ele apresenta. Nos testes com conjuntos de dados reais de discrepâncias paper-código, o Dude alcançou melhorias de recall e precisão de até 22,8% e aumento do F1 score em até 18,7% em relação aos métodos baseline.
O sistema Dude, segundo o resumo, foi desenhado para atacar duas limitações dos modelos anteriores de agente único: a capacidade restrita de contexto e a detecção de discrepâncias feita apenas por um lado da comparação. Recall e precisão, de acordo com os resultados experimentais reportados, subiram em até 22,8% quando o Dude foi aplicado em datasets reais de divergências entre artigo e código.
Contexto
O ponto de partida do trabalho é uma constatação escalar: o volume de submissões de pesquisa cresceu além do que a revisão manual consegue cobrir. Nesse cenário, sistemas automatizados baseados em modelos de linguagem (LLMs) passaram a ser estudados para detectar divergências entre o que um paper descreve e o que o código de fato executa.
Métodos anteriores, baseados em um único agente de LLM, tinham dois defeitos apontados pelos autores. Primeiro, o contexto limitado impedia que o agente processasse artigos longos e códigos extensos de uma vez. Segundo, a detecção unilateral fazia com que o sistema olhasse apenas para um lado da comparação, deixando escapar inconsistências que aparecem quando texto e código são confrontados. Essas falhas resultavam em recall inferior, ou seja, menos discrepâncias reais encontradas.
Por que importa
A reprodutibilidade na ciência computacional depende de o código corresponder exatamente ao que o artigo afirma. Quando há divergência entre texto e implementação, leitores não conseguem reproduzir resultados, e revisores gastam horas tentando descobrir onde está a falha.
Para pesquisadores que submetem trabalhos com código, o Dude oferece a possibilidade de uma verificação automatizada antes do envio, padronizando aquilo que hoje depende de leitura manual. Para repositórios acadêmicos e conferências, a ferramenta pode atuar como um primeiro filtro de consistência, antes da revisão por pares.
O ganho de 18,7% no F1 score, métrica que combina recall e precisão, indica que o sistema não apenas acha mais divergências, mas também reduz o custo de revisar alertas falsos.
Impacto
O principal obstáculo técnico identificado no paper é o que os autores chamam de assimetria de granularidade entre a linguagem do paper e a linguagem do código. Textos científicos descrevem métodos de forma abstrata e por parágrafos, enquanto código é explícito, em nível de função e linha. Essa diferença gera dois efeitos indesejados em sistemas multiagente: over-interpretation, quando o agente lê significado demais no código, e over-reporting, quando reporta discrepâncias que não existem. O resultado é uma elevação de falsos positivos.
Para enfrentar isso, o Dude incorpora dois mecanismos. O primeiro é a granularity-aligned negotiation, um processo de negociação entre agentes que alinham o nível de detalhe ao comparar uma seção do texto com os trechos de código correspondentes. O segundo é a two-stage salience-filtering, um filtro de saliência em dois estágios que descarta relatos de baixa importância antes de eles virarem alertas.
Na prática, esses mecanismos reduziram os falsos relatos e melhoraram o equilíbrio entre detecção e confiabilidade, um dos motivos do avanço sobre os métodos de base.
O que muda
Para a área de verificação automática de consistência paper-código, o Dude introduz a ideia de múltiplos agentes que conversam entre si ao comparar dois artefatos, em vez de um único modelo analisando tudo de uma vez. A negociação alinhada por granularidade e o filtro de saliência são componentes que outros sistemas podem reutilizar em tarefas semelhantes.
Para quem trabalha na prática com revisão de código científico, o sistema promete menos horas perdidas com falsos positivos e maior chance de achar uma divergência real escondida em um repositório grande.
O que vem agora
O artigo está disponível no arXiv na forma de preprint, e o resumo não informa data de liberação do código nem planos de integração com ferramentas como GitHub Actions ou plataformas de revisão por pares. A expectativa razoável é que a comunidade acadêmica teste o método em outros domínios, como papers sem código público ou repositórios com múltiplas versões de implementação.
Cabe também observar que a identificação do artigo, arXiv:2609.03416, indica uma submissão em setembro de 2026, então ainda não há resultados de validação independente ou comparações feitas por outros grupos.
Fontes
- arXiv:2609.03416, página oficial do artigo no servidor de preprints (https://arxiv.org/abs/2609.03416)