
EnvHarness: ferramenta cria ambientes dinâmicos para treinar IAs agentes
Sistema programável modulariza e adapta ambientes estáticos para o desenvolvimento contínuo de agentes baseados em LLMs
O que aconteceu
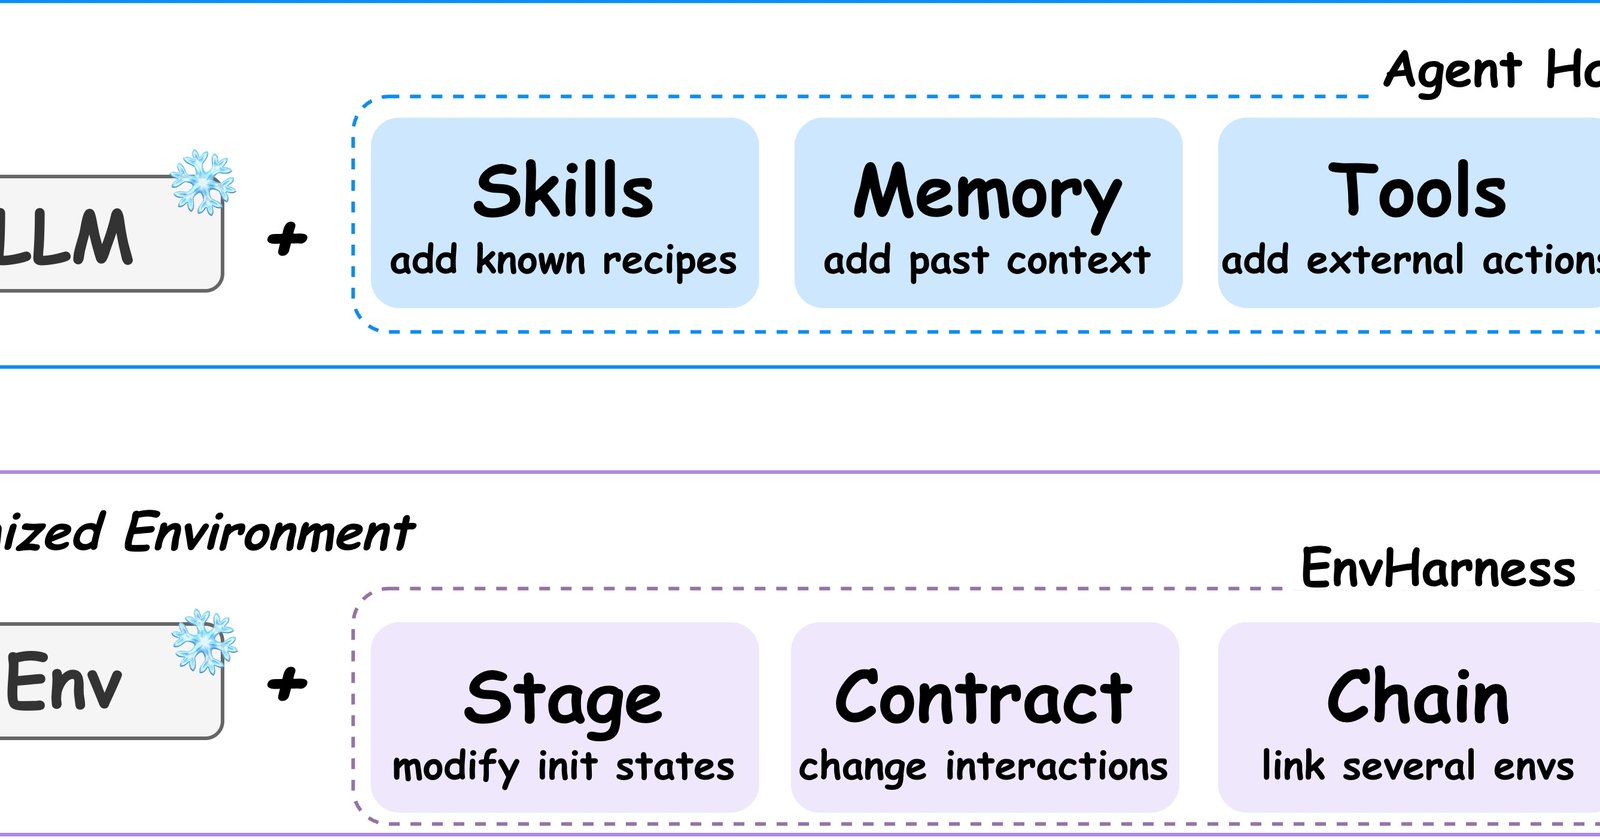
Pesquisadores publicaram no arXiv, em 20 de agosto de 2026, o artigo "EnvHarness: Awakening Static Worlds for Agent Learning". O estudo apresenta uma nova abordagem para o treinamento de agentes baseados em grandes modelos de linguagem (LLMs). A solução, chamada Environment Harness (EnvHarness), é uma camada programável e modular de componentes plug-in que encapsula um ambiente de treinamento estático. Seu objetivo é redesenhar o comportamento desse ambiente para torná-lo mais desafiador e adaptável, sem modificar a lógica subjacente do software original. Para automatizar a criação desses componentes, foi desenvolvido o EnvRigger, que observa a execução do agente para identificar falhas e sintetiza módulos que as corrigem.
Contexto
O treinamento de agentes de IA depende da interação com ambientes simulados. Tradicionalmente, esses ambientes são construídos manualmente e permanecem estáticos. Isso cria dois problemas: eles são "cegos" às fraquezas específicas de um agente e ficam ultrapassados à medida que o agente melhora. Métodos recentes de geração automática de ambientes tentam resolver isso, mas exigem pipelines específicos para cada domínio, dependem de verificadores dispendiosos ou pouco confiáveis, e ainda produzem resultados estáticos. O EnvHarness surge para aliviar o ônus de engenharia de reconstruir esses ambientes do zero.
Por que importa
O principal impacto está na eficiência e na escalabilidade do desenvolvimento de IAs agentes. Em vez de depender de engenheiros para criar novos cenários de treinamento sempre que o agente evolui, o EnvHarness permite que o próprio processo de treinamento gere desafios mais sofisticados. Isso acelera o ciclo de aprendizado contínuo. A abordagem é mais acessível, pois funciona com interfaces padrão e pode ser aplicada a diferentes domínios sem necessidade de reformulação completa do ambiente. Para empresas e pesquisadores que desenvolvem agentes autônomos, isso representa uma redução significativa de custos e tempo no desenvolvimento.
Impacto
Os resultados experimentais mostram que o EnvHarness superou tanto os ambientes originais quanto pipelines de geração específicos para domínio em cinco benchmarks, abrangendo quatro áreas distintas. O desempenho melhorou até 9,0 pontos em instâncias de teste não vistas, com uma redução de 9,8% no número de passos de execução necessários. Além de melhorar o desempenho imediato do agente, o sistema fornece um sinal de otimização superior para técnicas de aprendizado por reforço (reinforcement learning). Isso possibilita uma co-evolução contínua e direcionada entre a política (o comportamento do agente) e o seu ambiente de treinamento.
O que muda
A mudança principal é de paradigma: sair de ambientes de treinamento fixos e genéricos para ecossistemas adaptativos e específicos para as deficiências de cada agente. Isso pode acelerar o desenvolvimento de agentes mais robustos e especializados. A técnica também estabelece uma nova forma de pensar o treinamento, onde o ambiente evolui em resposta ao agente, criando um ciclo de melhoria contínua. Para o campo de IA, isso pode levar a avanços mais rápidos em capacidades de raciocínio e resolução de problemas por parte dos agentes.
O que vem agora
A publicação do artigo no arXiv marca o início da validação acadêmica da abordagem. Os próximos passos lógicos envolvem a liberação do código-fonte e a replicação dos resultados pela comunidade. Caso a técnica se mostre eficaz em domínios mais amplos, pode haver adoção em projetos de código aberto e, posteriormente, em plataformas comerciais de desenvolvimento de agentes. A integração com frameworks existentes de aprendizado por reforço e a testagem em ambientes complexos do mundo real serão cruciais para definir a extensão real do impacto do EnvHarness.