
Estudo aponta falha de raciocínio composicional em LLMs pós-RL
Paper mostra que RL ensina partes, mas não a combiná-las, e que o caminho inverso funciona melhor
O que aconteceu
O paper Compositional Reasoning in Language Models under Reinforcement Learning Post-Training foi submetido em 16 de setembro de 2026 e está publicado no arXiv sob o identificador 2609.19465v1, na categoria cs.AI. O paper, identificado como arXiv:2609.19465, propõe um framework de grafo de dependências para formalizar o raciocínio composicional e deriva dele três níveis de compositionalidade, de complexidade crescente.
Para testar o framework na prática, os autores usaram tarefas de estruturas de dados. A escolha tem razão técnica: essas tarefas oferecem recompensa determinística, o que permite medir acerto sem ruído de avaliação subjetiva, e expõem uma estrutura composicional clara, em que habilidades menores se encaixam para resolver o problema maior.
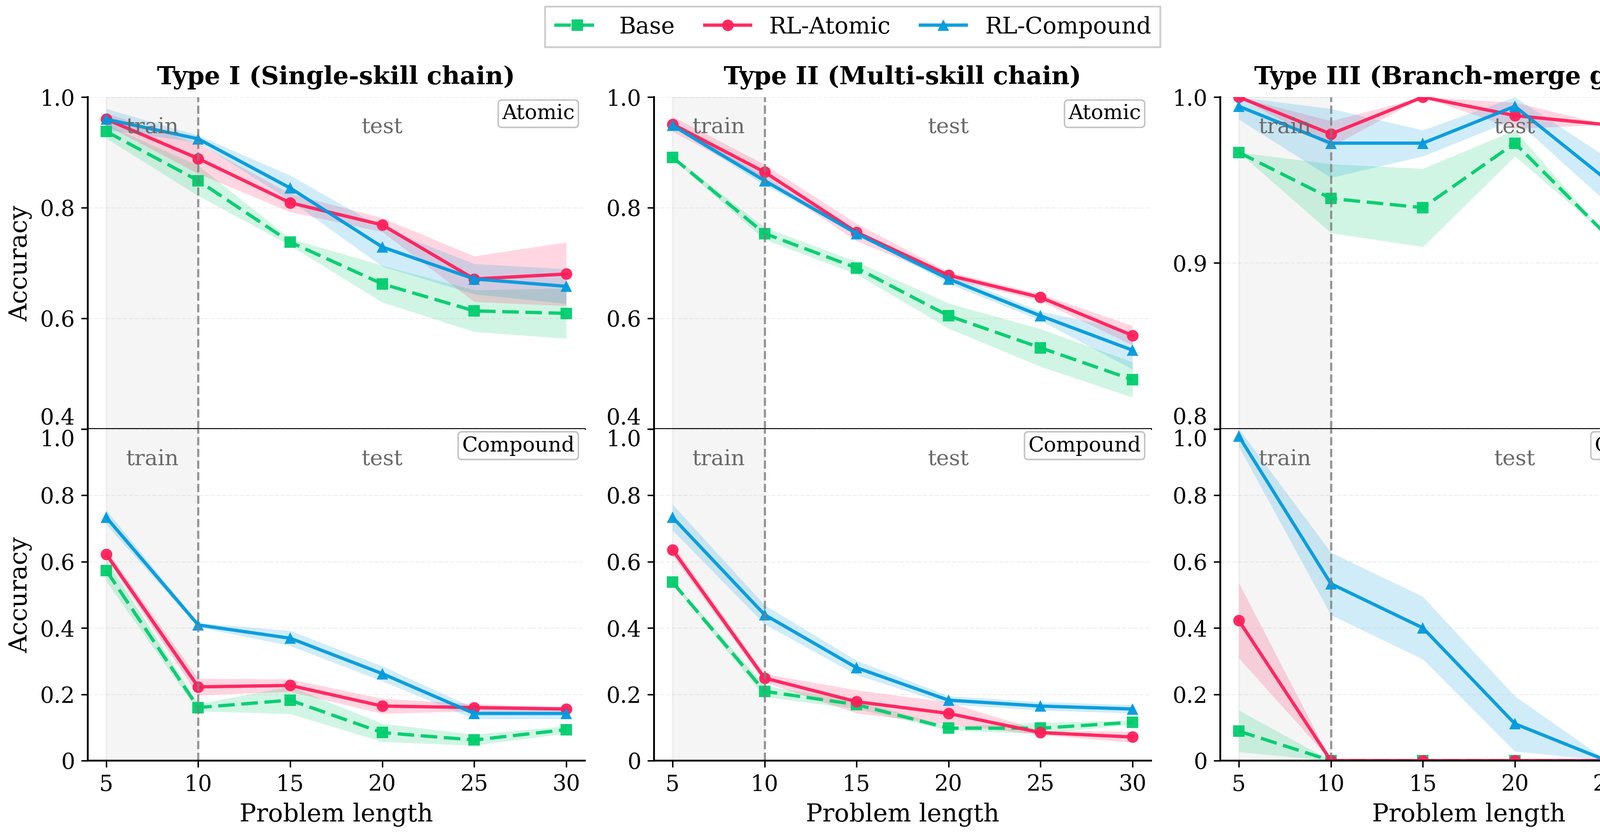
O resultado central é o que os autores chamam de assimetria decomposto-para-composto. O treino em habilidades decompostas não transfere de forma confiável para tarefas compostas. Já o treino em tarefas compostas transfere com mais facilidade de volta para as tarefas decompostas. O paper também apresenta uma explicação teórica para essa assimetria, ou seja, não se limita a descrever o fenômeno.
Os autores foram além do teste básico e avaliaram a generalização composicional em três frentes: extrapolação de comprimento, mudança de distribuição estrutural e transferência para tarefas que exigem habilidades nunca vistas no treino. Por fim, um estudo-piloto em benchmarks de tool calling do mundo real traz evidência preliminar de que a assimetria decomposto-para-composto se estende a cenários práticos.
Contexto
Métodos de pós-treino baseados em reinforcement learning melhoraram de forma substancial a capacidade de raciocínio dos modelos de linguagem nos últimos anos. O efeito desses métodos sobre o raciocínio composicional, porém, permanecia pouco compreendido. É essa lacuna que o paper ataca.
A premissa é simples e difícil de contornar: dados de treino são necessariamente limitados. Nenhum corpus cobre todas as combinações de problemas que um modelo vai encontrar em produção. Por isso, a capacidade de compor habilidades já aprendidas de formas novas deixa de ser um detalhe e passa a ser o mecanismo central de generalização.
Na prática da indústria, a resposta comum a esse problema tem sido o currículo decomposto. Empresas quebram tarefas complexas em subtarefas, anotam cada passo separadamente e treinam o modelo por etapas, na expectativa de que a soma das partes produza o todo. O paper sugere que essa expectativa não se sustenta sozinha.
Por que importa
O achado mexe direto com onde o dinheiro é gasto. Datasets decompostos, com anotação granular e tarefas isoladas, são caros de produzir e dominam boa parte dos pipelines de RL usados para ajustar modelos. Se o treino decomposto não transfere de forma confiável para tarefas compostas, parte desse investimento pode não se converter em ganho de capacidade real.
Do outro lado, o treino em tarefas compostas se mostra mais eficiente como ponto de partida, porque transfere para as partes. Isso inverte a lógica de montagem de currículo que muitas equipes adotam hoje.
O caso do tool calling torna o problema concreto. Um agente que chama ferramentas precisa encadear busca, cálculo, formatação e verificação de resultado. Cada uma dessas habilidades pode ser ensinada isoladamente. O paper aponta que ensinar bem cada habilidade não garante que o modelo saiba combiná-las quando o encadeamento aparece.
Impacto
No curto prazo, times de pós-treino tendem a revisar como montam seus conjuntos de dados, dando mais peso a tarefas compostas desde o início em vez de apostar apenas na decomposição. Fornecedores de dados voltados a subtarefas isoladas sentem o efeito direto dessa mudança de prioridade.
Há também um impacto sobre avaliação. Benchmarks que medem habilidades separadamente podem superestimar o que um modelo entrega em uso real. Se a assimetria se confirmar, medir composição passa a ser obrigatório, não opcional.
O que muda
A contribuição teórica do framework de grafo de dependências dá aos pesquisadores uma forma de prever quando a transferência vai falhar, em vez de descobrir isso por tentativa e erro. Os três níveis de compositionalidade funcionam como escala para classificar tarefas e comparar resultados entre experimentos.
O paper arXiv:2609.19465 também desloca o debate sobre RL pós-treino. A pergunta deixa de ser apenas se o modelo melhora em raciocínio e passa a incluir em que ordem as habilidades foram ensinadas.
O que vem agora
O trabalho é um preprint e ainda não passou por revisão por pares. O estudo-piloto em benchmarks de tool calling é explicitamente descrito como evidência preliminar, o que abre espaço para replicação em escala maior e com outros modelos. Testes com métodos de pós-treino além do reinforcement learning são um caminho natural de continuação, assim como verificar se a assimetria se mantém em domínios fora das tarefas de estruturas de dados.
FONTES
- Compositional Reasoning in Language Models under Reinforcement Learning Post-Training, arXiv:2609.19465v1 (https://arxiv.org/abs/2609.19465)