
Estudo com 9 LLMs revela limite coletivo em decisões oncológicas
Benchmark com 2.005 pontos de decisão em câncer mostra que GPT-5.5 e Gemini 3.1 Pro assumem riscos 5x mais
O que aconteceu
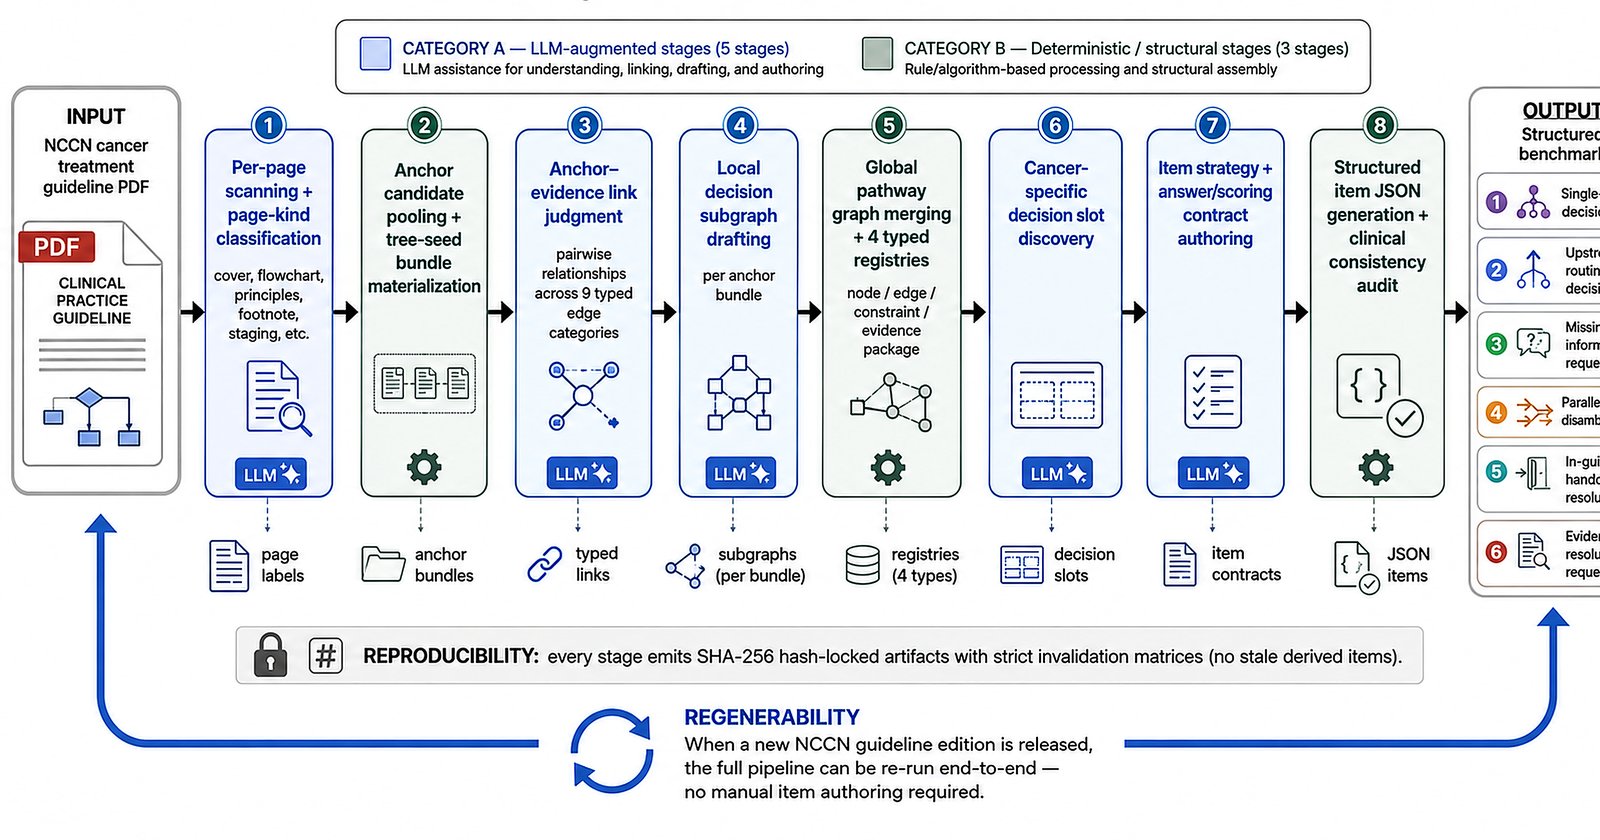
Pesquisadores criaram o Oncology Decision Boundary Benchmark (ODBB), um conjunto de 2.005 pontos de decisão oncológica baseados nas diretrizes da NCCN (National Comprehensive Cancer Network) e em casos reais de câncer colorretal. O ODBB foi usado para avaliar nove LLMs de fronteira, lançados entre junho de 2025 e abril de 2026, sendo quatro de código fechado e cinco famílias com pesos abertos. O estudo foi publicado no arXiv sob o identificador arXiv:2608.28592.
O avaliador, totalmente determinístico e sem inferência de LLM, classificou as respostas em 14 tipos de falha. A classificação foi validada de forma independente por dois oncologistas, com coeficiente kappa de Cohen ponderado de 0,939 e 0,790 em uma amostra estratificada de 225 itens. Esse número indica alta concordância, o que reforça a confiabilidade do método.
Quando os nove modelos foram tratados como um super-modelo combinado, 42,1% de todos os itens não foram respondidos corretamente por nenhum deles. O intervalo de confiança de Wilson de 95% foi de 40,0% a 44,3%. Em itens específicos, a taxa de falha coletiva subiu para 35,7% nos 1.586 itens da NCCN e atingiu 66,4% nos 419 casos de câncer colorretal. Os erros se concentraram na escolha entre diferentes caminhos de diretrizes, antes mesmo de qualquer raciocínio dentro do caminho escolhido. Esse padrão indica uma falha consistente no que os pesquisadores chamam de meta-julgamento clínico, um ponto cego que provavelmente exige intervenção arquitetural, não apenas mais dados de treinamento.
Contexto
LLMs já demonstram pontuações altas em exames de conhecimento médico. A questão levantada pelo estudo é que oncologia real não é uma prova de conhecimento, mas uma sequência de escolhas de caminhos baseados em diretrizes, julgamentos de escalonamento e compromissos sob incerteza. Benchmarks anteriores mediram principalmente recordação factual, deixando em aberto se os modelos compartilham pontos cegos de decisão que nem a combinação de modelos consegue corrigir.
Dois modelos explicitamente ajustados para serem decididos, o GPT-5.5, da OpenAI, e o Gemini 3.1 Pro Preview, do Google, se destacaram negativamente. Eles assumiram compromissos inseguros de três a cinco vezes mais frequentemente que os outros sete modelos mais cautelosos, sem obter pontuações mais altas. Em 3% a 9% dos itens, os modelos afirmavam a etapa clínica correta, mas não se comprometiam com ela. Isso configura uma falha de decisão, não de conhecimento.
Por que importa
Os resultados indicam que a qualidade do modelo não é mais o principal gargalo para a implantação clínica de LLMs. O fator limitante é a suposição de que um único modelo pode servir como base exclusiva para uma decisão clínica. Essa descoberta tem impacto direto em hospitais e startups de saúde que já testam ferramentas de IA para oncologia. No Brasil, onde o acesso a especialistas é desigual, a tentação de delegar decisões a modelos de IA é real, mas este estudo mostra o risco de falhas que nenhum modelo atual consegue evitar.
A concentração de erros na escolha entre diretrizes, antes do raciocínio, sugere que o problema não é falta de conhecimento dos modelos, mas de arquitetura. O GPT-5.5, da OpenAI, e o Gemini 3.1 Pro Preview, do Google, foram avaliados nesse contexto. Mesmo quando combinados com todos os outros, a taxa de acerto coletivo não passou de 57,9% em todos os itens. Isso significa que, para uma parcela significativa de decisões oncológicas, nenhum modelo disponível atualmente produz a resposta certa.
Impacto
No curto prazo, hospitais que usam LLMs para apoio à decisão oncológica precisam rever seus protocolos de supervisão. A falha coletiva de 66,4% nos casos de câncer colorretal é particularmente alarmante, pois esse é um dos tipos de tumor com diretrizes bem estabelecidas. A incapacidade de escolher o caminho correto pode levar a atrasos no tratamento ou a condutas não conformes, com consequências graves para pacientes.
Os dois modelos ajustados para decisão, GPT-5.5 e Gemini 3.1 Pro Preview, que cometeram compromissos inseguros com frequência até cinco vezes maior, não podem ser usados sem barreiras extras de verificação clínica. Os pesquisadores defendem que o progresso exige arquiteturas capazes de detectar quando um modelo atinge seu limite de competência e, nesse momento, rotear a decisão para um médico. Esse roteamento automático para um clínico é apontado como o próximo passo prático.
O que muda
O estudo muda a conversa sobre IA em medicina. Deixamos de perguntar "qual modelo é melhor" para perguntar "quando um modelo deve ser ignorado". A noção de que a combinação de vários LLMs pode compensar fraquezas individuais foi refutada: mesmo tratando os nove como um único super-modelo, 42,1% dos itens ficaram sem resposta correta. A falha de decisão, em que o modelo sabe o passo certo mas não o executa, foi medida em 3% a 9% dos itens, mostrando um hiato entre conhecimento e ação.
Os resultados reforçam que mais dados de treinamento não resolverão o problema, pois o ponto cego está na escolha da diretriz, não no conteúdo delas. A recomendação dos autores é clara: a arquitetura precisa incluir mecanismos de consciência de limite e de encaminhamento a humanos. Na prática, isso significa que sistemas de IA em oncologia devem ser desenhados como ferramentas de triagem e consulta, não como decisores autônomos.
O que vem agora
Os próximos passos incluem o desenvolvimento de arquiteturas que detectem quando um modelo atinge seu limite de competência. Os autores não indicam prazos, mas o estudo abre caminho para novos benchmarks focados em meta-julgamento clínico. Para o mercado, a mensagem é que a certificação de IA médica precisará incluir testes de decisão, não apenas de conhecimento. Empresas como a OpenAI e o Google, que tiveram modelos avaliados, poderão responder ao estudo com ajustes em seus sistemas, especialmente os modelos GPT-5.5 e Gemini 3.1 Pro Preview, que demonstraram comportamento mais arriscado.
A comunidade oncológica, por sua vez, pode usar o ODBB como referência para avaliar futuros modelos antes de qualquer uso clínico. Com 2.005 pontos de decisão padronizados, o benchmark já está público para reprodução e extensão. O estudo completo está disponível no arXiv e pode ser consultado por qualquer pesquisador ou desenvolvedor.
Fontes
- arXiv:2608.28592 - A collective capability boundary in frontier large language models on guideline-conformant and case-specific oncology decision-making (https://arxiv.org/abs/2608.28592)