
Estudo mapeia 14.767 benchmarks de LLMs no arXiv
Levantamento analisou benchmarks de LLMs publicados no arXiv entre 2022 e 2026 e mostra avanço da avaliação feita por modelos
O que aconteceu
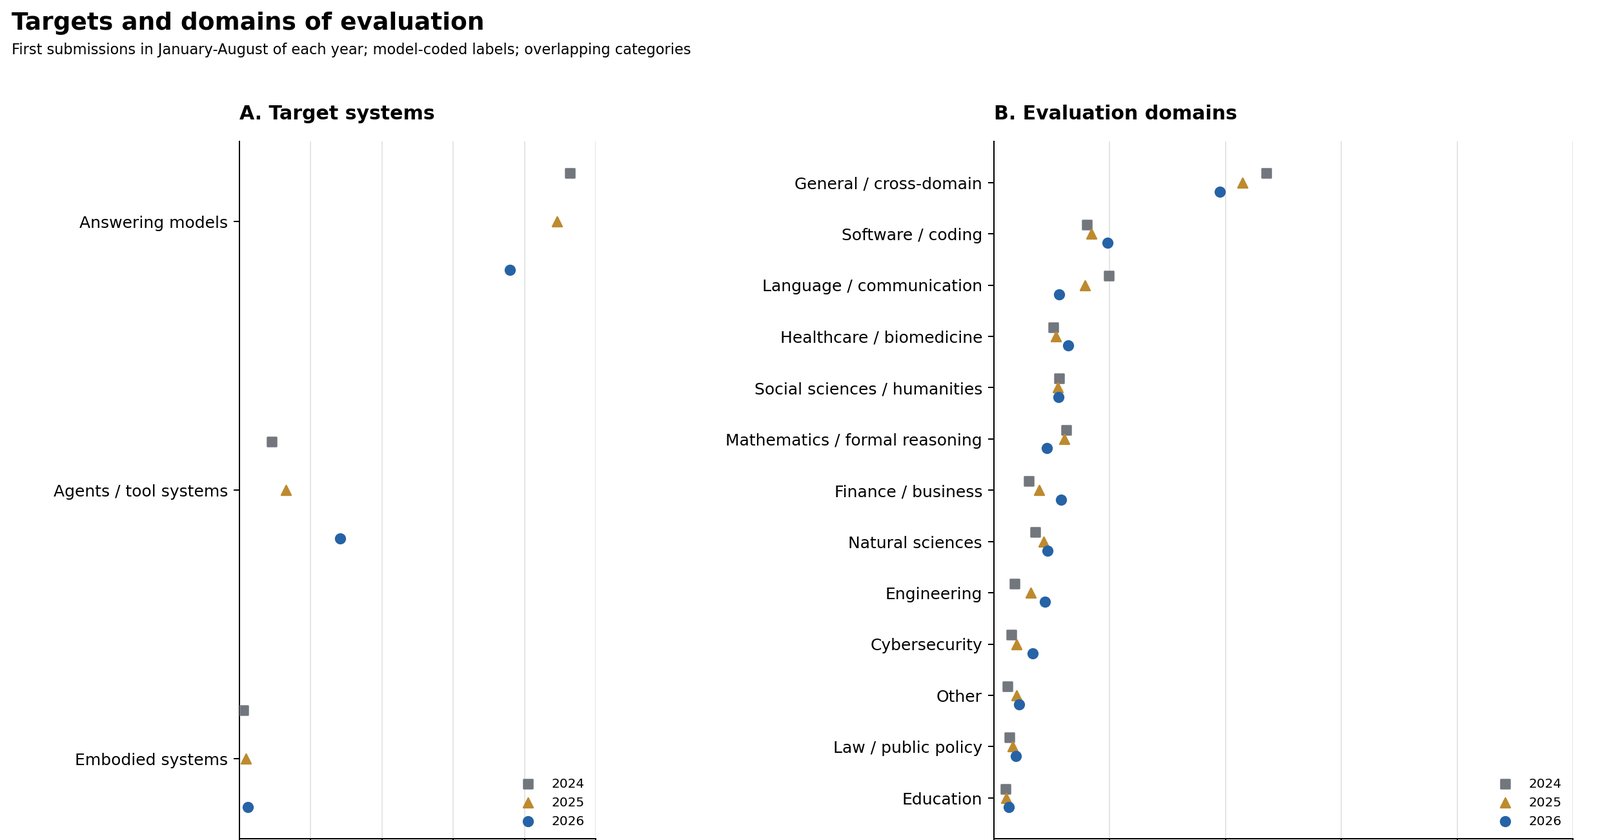
O artigo "What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks" foi submetido ao arXiv em 15 de setembro de 2026 e catalogado sob o identificador arXiv:2609.19182v1, na área de Inteligência Artificial. O estudo analisou 14.767 papers que introduziram ou atualizaram recursos de avaliação, todos publicados no arXiv entre janeiro de 2022 e agosto de 2026. Os 14.767 benchmarks foram mapeados por meio de triagem em etapas e codificação automatizada de texto completo, segundo o resumo do artigo.
O levantamento olhou para três frentes: quais sistemas e domínios os benchmarks miravam, quais materiais e condições de avaliação usavam, e como as respostas eram pontuadas.
Contexto
Benchmarks são o instrumento central para medir e comunicar o progresso em LLMs. O problema, segundo os autores, é que rankings de modelos dizem pouco sobre como as exigências de avaliação em si estão mudando. Olhar para a variedade crescente de testes oferece outra perspectiva: o que os pesquisadores esperam que os LLMs façam e o que eles consideram desempenho bem-sucedido.
A coleta do estudo mostra uma ênfase crescente em ação, interação e aplicações profissionais. Elementos de design antigos e novos coexistem com frequência nos benchmarks analisados. Ou seja, a área não substituiu métricas tradicionais por abordagens recentes. Empilhou umas sobre as outras.
A participação dos modelos no processo de avaliação também avança de forma desigual. A pontuação feita por LLMs cresce tanto dentro do grupo de benchmarks voltados a agentes quanto fora dele. Já os materiais gerados por modelos não apresentam aumento sustentado comparável nas coortes mais recentes.
Por que importa
A questão prática é quem controla o crivo. Quando um modelo de linguagem executa a tarefa e outro modelo julga a resposta, a avaliação deixa de depender apenas de gabaritos fixos ou de anotadores humanos. Isso reduz custo e escala, mas cria uma dependência circular: o desempenho de um LLM passa a ser medido, em parte, por outro LLM.
Os próprios autores formulam a dúvida central do trabalho. À medida que a IA participa da construção dos testes, da execução das tarefas e do julgamento das respostas, a avaliação expandida oferece mais evidência independente ou corre o risco de reproduzir as preferências e os pontos cegos dos modelos que participam dela?
O dado de que a pontuação por LLM cresce nos dois grupos, agentes e não agentes, mostra que essa prática não ficou restrita a benchmarks experimentais de agentes autônomos. Ela se espalhou pela avaliação de LLMs em geral. Já a estabilidade dos materiais gerados por modelos indica uma assimetria: os pesquisadores aceitam que um modelo julgue, mas são mais cautelosos em deixar que ele produza o conteúdo do teste.
Impacto
Para laboratórios e empresas que publicam modelos, o mapeamento de 14.767 papers de benchmarks é um retrato do que o mercado passou a cobrar de um LLM. A ênfase em aplicações profissionais sugere que a avaliação acompanha a migração dos modelos de linguagem de demonstrações de texto para uso dentro de fluxos de trabalho reais.
Para quem consome esses rankings, o alerta é direto: a lista de benchmarks cresceu, mas crescimento em número de testes não equivale automaticamente a crescimento em independência dos testes. Se o juiz é um modelo, o viés do juiz entra no resultado.
Para a pesquisa acadêmica, o estudo oferece um mapa quantitativo do que a área decidiu medir. Essa base permite comparar coortes e identificar quando um tipo de design de benchmark se consolidou, algo que antes ficava disperso em milhares de PDFs separados.
O que muda
O estudo reposiciona a discussão sobre avaliação de LLMs. Em vez de perguntar apenas qual modelo lidera um ranking, ele propõe olhar para o desenho dos testes: o que se pede ao modelo, com que material, sob quais condições e com que critério de sucesso.
O mapeamento também documenta a convivência entre designs estabelecidos e novos, o que contraria a ideia de substituição limpa de gerações de benchmarks. Na prática, um mesmo campo de pesquisa carrega camadas de critérios acumulados ao longo de quatro anos.
O que vem agora
O artigo deixa aberta a pergunta sobre independência da avaliação de LLMs e não anuncia uma proposta de correção. O caminho natural é que a comunidade discuta protocolos para separar quem gera o teste, quem executa a tarefa e quem julga o resultado, evitando que o mesmo tipo de modelo ocupe os três papéis.
O mapeamento também serve de base para análises futuras, já que cobre coortes sucessivas de benchmarks de LLMs entre 2022 e 2026 e permite medir se a pontuação por LLM continuará crescendo, se os materiais gerados por modelos vão se firmar e se a ênfase em ação, interação e aplicações profissionais seguirá dominando o desenho dos testes.
Fontes
- arXiv cs.AI: "What Do We Expect from LLMs? Mapping the Design of LLM Benchmarks" (arXiv:2609.19182v1), submetido em 15 de setembro de 2026. https://arxiv.org/abs/2609.19182