
Estudo revela falha de segurança em IAs com Camuflagem Semântica e propõe nova defesa
Pesquisa identifica 'Horizonte de Intenção' onde modelos confundem segurança e perigo
O que aconteceu
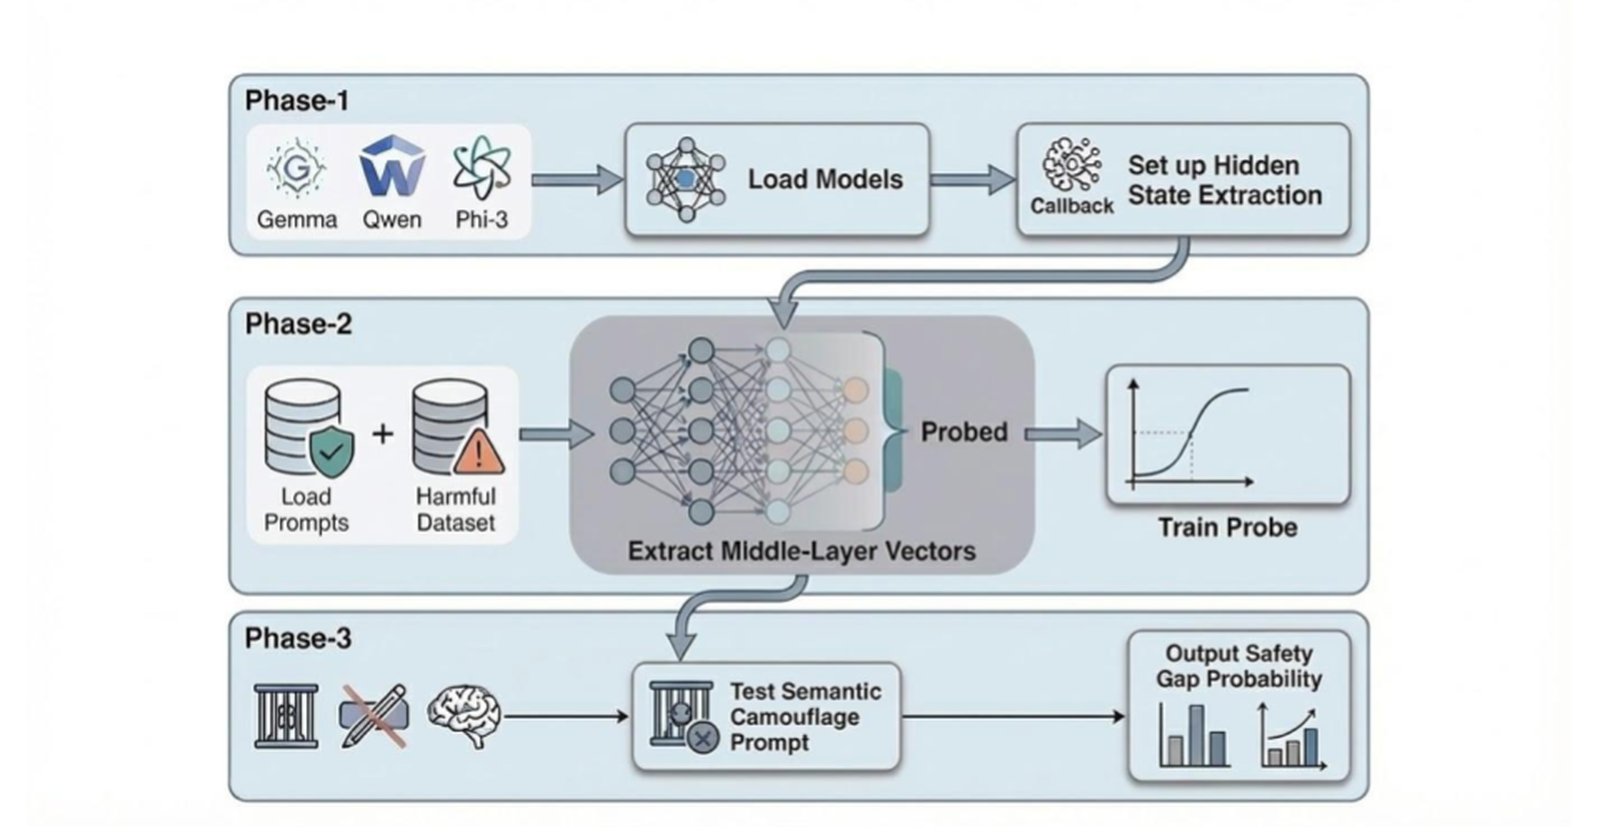
Em 27 de junho de 2026, o pesquisador Md. Hasib Ur Rahman e equipe submeteram o artigo "Truth Lies Deep: Countering Semantic Camouflage via Latent Intent Verification" ao servidor de pré-print arXiv, na categoria Computer Science > Artificial Intelligence. O estudo analisa três famílias de Small Language Models (SLMs): Phi-3, Qwen2.5 e Gemma-2b. A pesquisa demonstrou que esses modelos são vulneráveis à Camuflagem Semântica, um tipo de ataque adversarial que envolve intenção maliciosa em contextos narrativos benignos, como escrita criativa. Esse disfarce permite que os ataques bypassem os sistemas de segurança convencionais. O estudo identificou um fenômeno chamado "Intent Horizon" (Horizonte de Intenção), localizado entre 15% e 20% das camadas totais dos modelos. Nessa profundidade, a representação latente da intenção prejudicial colapsa conforme o modelo contextualiza a pergunta em uma narrativa "segura". Nos estágios finais da geração, as representações de ataques camuflados tornam-se matematicamente indistinguíveis de consultas seguras, com uma taxa de detecção inferior a 20% pelos mecanismos padrão. Em contraste, as camadas iniciais retinam uma "assinatura de dano" distinta e detectável. Com base nisso, os autores propõem a LIV, uma defesa leve baseada em sondagem. Experimentos no conjunto de dados PKU-SafeRLHF mostraram que a LIV superou os guardrails padrão em margens de 20 a 50% em todas as arquiteturas testadas, neutralizando ataques semânticos de zero-day sem necessidade de retreinamento do modelo.
Contexto
A alinhamento de segurança em LLMs tem sido uma prioridade, mas o estudo argumenta que ela é frequentemente superficial. Essa abordagem depende de mecanismos de recusa que só são acionados nos últimos estágios da geração, sem erradicar o conhecimento fundamental de conceitos prejudiciais adquirido durante o pré-treinamento. Essa desconexão arquitetural cria a vulnerabilidade à Camuflagem Semântica. Atacantes podem, por exemplo, pedir a um modelo que gere uma história contendo instruções perigosas, disfarçadas como parte da trama. O modelo, focado em manter o contexto narrativo seguro, pode ignorar os sinais de perigo nas camadas finais. A pesquisa analisou especificamente modelos de linguagem menores, como Phi-3 da Microsoft, Qwen2.5 do Alibaba Cloud e Gemma-2b do Google DeepMind. A identificação de um "Intent Horizon" universal em famílias tão distintas sugere que a vulnerabilidade é estrutural, não específica de uma arquitetura ou empresa.
Por que importa
Essa vulnerabilidade tem implicações práticas sérias para a adoção segura de IAs em ambientes corporativos e públicos. Se um LLM pode ser enganado para executar ou ensinar ações prejudiciais através de pedidos aparentemente inocentes, o risco de uso indevido aumenta drasticamente. Empresas que integram esses modelos em produtos, como assistentes virtuais ou ferramentas de codificação, enfrentam novos desafios de segurança. A LIV proposta oferece uma camada de defesa adicional que pode ser implementada sem retreinar o modelo, reduzindo custos e complexidade. Para o mercado brasileiro, onde a adoção de IAs acelera em setores como atendimento ao cliente e análise de dados, essa pesquisa sinaliza que as soluções de segurança precisam evoluir além da verificação de entrada e saída. A capacidade de detectar intenções em camadas latentes abre caminho para defesas mais proativas.
Impacto
No curto prazo, os resultados podem acelerar a pesquisa em segurança de IA focada em espaços latentes. Empresas de tecnologia e startups que desenvolvem soluções baseadas em LLMs podem precisar revisar suas pipelines de segurança. A melhoria de 20 a 50% na detecção é significativa para prevenir incidentes. No médio prazo, o conceito de "Intent Horizon" pode influenciar o design de novos modelos, levando a arquiteturas com camadas de segurança integradas mais cedo no processo de geração. Para desenvolvedores, a LIV representa uma ferramenta potencial para proteger aplicações sem sacrificar performance. O fato de a defesa funcionar contra ataques de zero-day é crucial, pois indica que ela pode se adaptar a ameaças ainda não conhecidas.
O que muda
Muda a abordagem defensiva da segurança de IA, saindo de uma verificação superficial no final para uma auditoria nas representações internas do modelo. Em vez de apenas filtrar palavras-chave ou padrões de saída, sistemas podem sondar ativação iniciais para identificar assinaturas de dano. Isso representa um salto metodológico. Para pesquisadores, abre um novo campo focado em "segurança latente". Para empresas, pode significar a integração de novas ferramentas de monitoramento nas camadas de processamento dos modelos. A pesquisa também destaca que a segurança atual, baseada em refusal mechanisms, é insuficiente por si só. Isso pode pressionar organizações a adotar abordagens de defesa em profundidade.
O que vem agora
O artigo é um pré-print publicado em 27 de junho de 2026, portanto, passará por revisão por pares. Os próximos passos incluem validação em modelos maiores, como LLMs com bilhões de parâmetros, e testes em cenários mais complexos. A equipe de pesquisa, liderada por Md. Hasib Ur Rahman, pode colaborar com instituições para implementação prática. O conjunto de dados PKU-SafeRLHF, usado nos experimentos, continuará como referência. Espera-se que empresas como Microsoft (Phi-3), Alibaba (Qwen2.5) e Google (Gemma) avaliem os achados para melhorar a segurança de seus próprios modelos. A comunidade de IA provavelmente explorará mais o conceito de "Intent Horizon" para desenvolver defesas ainda mais robustas.
Fontes
- arXiv (27 de junho de 2026): "Truth Lies Deep: Countering Semantic Camouflage via Latent Intent Verification" (https://arxiv.org/abs/2608.20378)