
Evicção de KV cache: agregação temporal é o fator decisivo
Estudo do arXiv mostra que a regra temporal de agregação de escores, e não o scoring, define o sucesso da compressão agressiva.
O que aconteceu
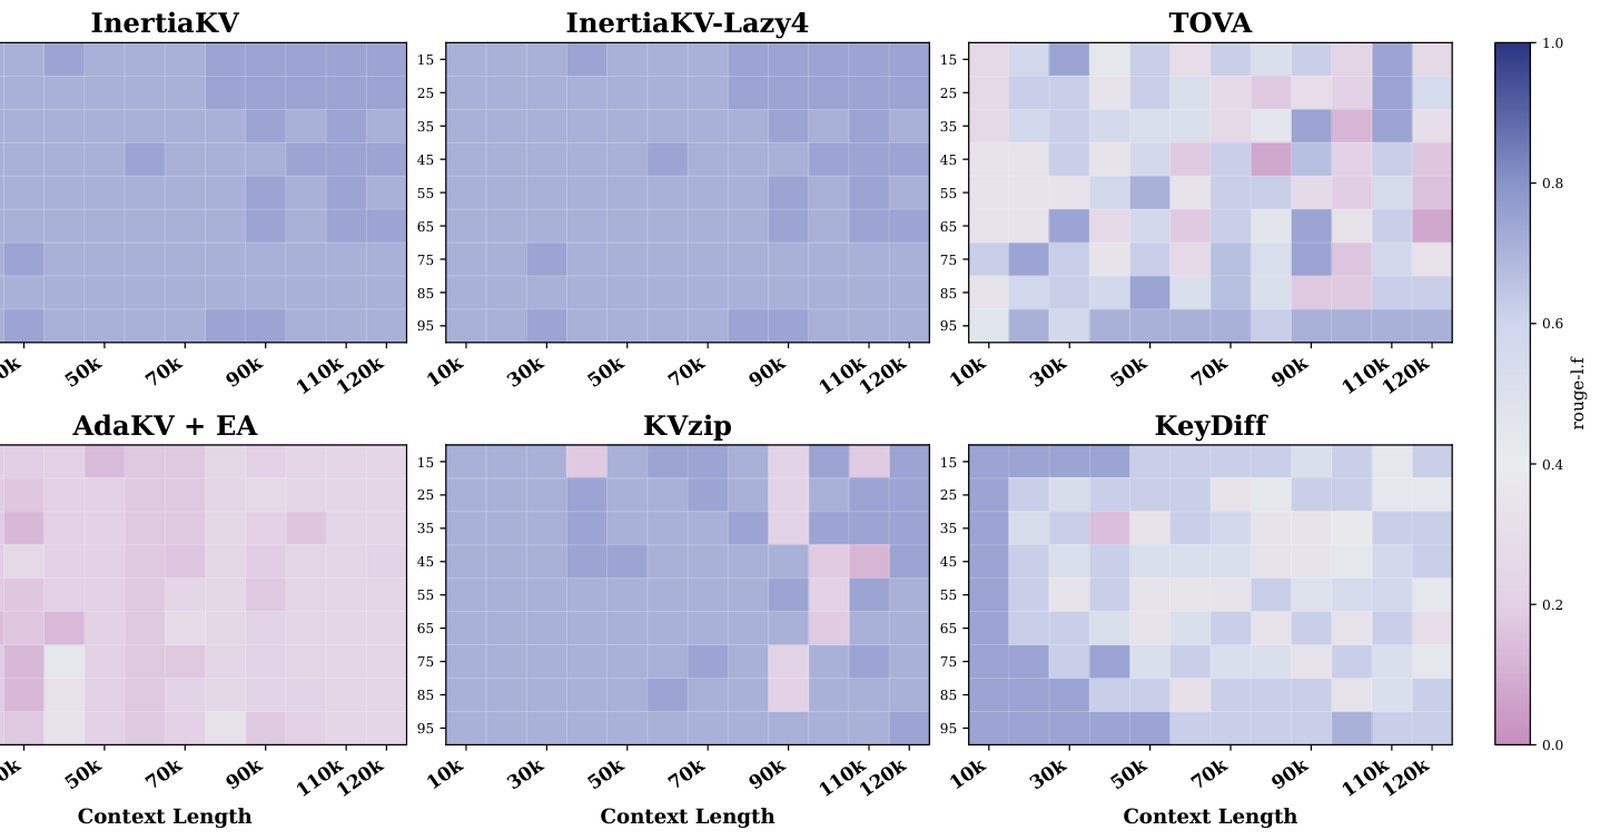
Pesquisadores publicaram em 3 de setembro de 2026 no arXiv (identificador 2609.03515) o estudo "What Matters for Aggressive Decoding-Time KV Eviction?", na categoria cs.AI. O grupo testou diferentes funções de scoring de tokens sob compressão agressiva do cache KV e encontrou um resultado contraintuitivo. Quando a agregação dos escores é feita por média móvel exponencial (EMA), modificações aproximadamente preservadoras de ordem no scoring tornam-se praticamente indistinguíveis no conjunto de evicção. Ou seja, o scoring perde influência se a regra temporal for adequada.
No estudo, variantes de norma de valor e entropia continuaram altamente correlacionadas com atenção e mantiveram conjuntos de retenção quase inalterados. Já KeyDiff, norma de chave, recência e um scorer aprendido alteraram o ranking e degradaram substancialmente os resultados. Os autores atribuíram essa estabilidade à agregação avaliada, que acopla ponderação de camadas e retenção temporal.
Para aproveitar essa descoberta, eles criaram o InertiaKV, método de evicção de cache em tempo de decodificação baseado em EMA. Em seguida, desenvolveram o InertiaKV-Lazy, variante que atualiza o ranking apenas periodicamente. Nas medições, o InertiaKV-Lazy alcançou um ganho de 1.34 a 1.46 vezes no throughput de decodificação em comparação ao InertiaKV com atualização completa do ranking a cada passo.
Contexto
A evicção de KV cache é usada para reduzir o custo de inferência de grandes modelos de linguagem. Durante a decodificação, o modelo armazena chaves e valores de atenção de tokens anteriores. Em janelas longas, essa memória cresce rápido e pode estourar a VRAM, forçando a remoção de tokens. Grande parte da pesquisa recente concentrou-se em criar funções de scoring mais refinadas para escolher quais tokens descartar. A regra temporal, que decide como combinar os escores entre passos, era quase sempre tratada como detalhe de implementação.
Esse estudo submetido ao arXiv em 2026 contraria essa visão. Os pesquisadores testaram seis backbones de código aberto e três benchmarks de contexto longo: LongBench, LongBench-v2 e RULER. O desenho experimental, múltiplos modelos e benchmarks, busca evitar conclusões restritas a uma arquitetura. A tese central é que a preservação do ranking e a agregação temporal são fatores de design independentes e consequentes, e não meros detalhes.
Por que importa
Para quem desenvolve ou opera LLMs em produção, o custo de inferência é dominado por memória e tempo de decodificação. Comprimir o cache KV permite processar mais tokens por requisição ou servir mais usuários com o mesmo hardware. O ganho de throughput de 1.34 a 1.46 vezes do InertiaKV-Lazy é relevante: em ambientes de alta demanda, isso significa menos GPUs ou menor latência por resposta. Como a qualidade é preservada, a troca entre velocidade e precisão fica mais favorável.
Além disso, o trabalho questiona a premissa de que melhorar o scoring é o único caminho. Equipes que investem em scorers aprendidos podem estar otimizando a peça errada se a agregação temporal não estiver bem calibrada. Um mecanismo simples, como o EMA, pode render mais do que novos modelos de scoring complexos.
Impacto
No curto prazo, o InertiaKV e o InertiaKV-Lazy podem ser integrados a frameworks de inferência como vLLM ou TensorRT-LLM, reduzindo a latência sem exigir mudanças na arquitetura do modelo. O Score-Free decoding, outro ponto operacional do estudo, também tem implicações práticas. O método pontua todo o contexto uma única vez no primeiro passo de decodificação e congela esse ranking para o restante. Score-Free, como é chamado esse ponto operacional, apresentou variação média de qualidade de apenas +0.03, ao mesmo tempo que elimina todo o scoring subsequente.
No médio prazo, a pesquisa pode redirecionar as linhas de estudo em compressão de cache. Ao identificar agregação temporal e preservação de ranking como fatores distintos, ela abre espaço para novos métodos que combinem informação temporal de formas ainda não exploradas. A adoção experimental em ferramentas open-source é plausível nas próximas semanas, dado o ganho de performance e a simplicidade das técnicas.
O que muda
O estudo reposiciona o foco da área de compressão de KV cache. Em vez de perseguir funções de scoring cada vez mais elaboradas, a pesquisa indica que a escolha da agregação temporal é o ponto de maior alavancagem. Os autores têm cuidado de não afirmar que a qualidade do scoring seja irrelevante em geral. Eles delimitam a conclusão ao cenário de compressão agressiva, onde o EMA nivelou as diferenças entre scorers quase preservadores de ordem.
Como o artigo ainda é um preprint sem revisão por pares, a validação independente é necessária. Ainda assim, a combinação de seis backbones abertos e três benchmarks consolidados dá peso aos resultados. A publicação no arXiv em 3 de setembro pode gerar réplicas e extensões rápidas na comunidade de eficiência de LLMs.
O que vem agora
O artigo está disponível no arXiv desde 3 de setembro de 2026, com primeira versão anunciada em 4 de setembro de 2026. Não há anúncios públicos de integração em produtos ou frameworks até o momento. É esperado que os autores publiquem o código e os modelos em repositórios como Hugging Face, seguindo a prática da área. Novos experimentos com modelos maiores e outras formas de agregação temporal devem aparecer nas próximas semanas, conforme outros grupos testem e ampliem os achados.
Fontes
- arXiv cs.AI: "What Matters for Aggressive Decoding-Time KV Eviction? Temporal Aggregation and Ranking Preservation" (arXiv:2609.03515v1) - https://arxiv.org/abs/2609.03515