
EXIMO: Algoritmo de IA reduz dados para treinar robôs em novas tarefas
Algoritmo de três etapas combina planejamento por linguagem com RL para resolver problema de amostragem
O que aconteceu
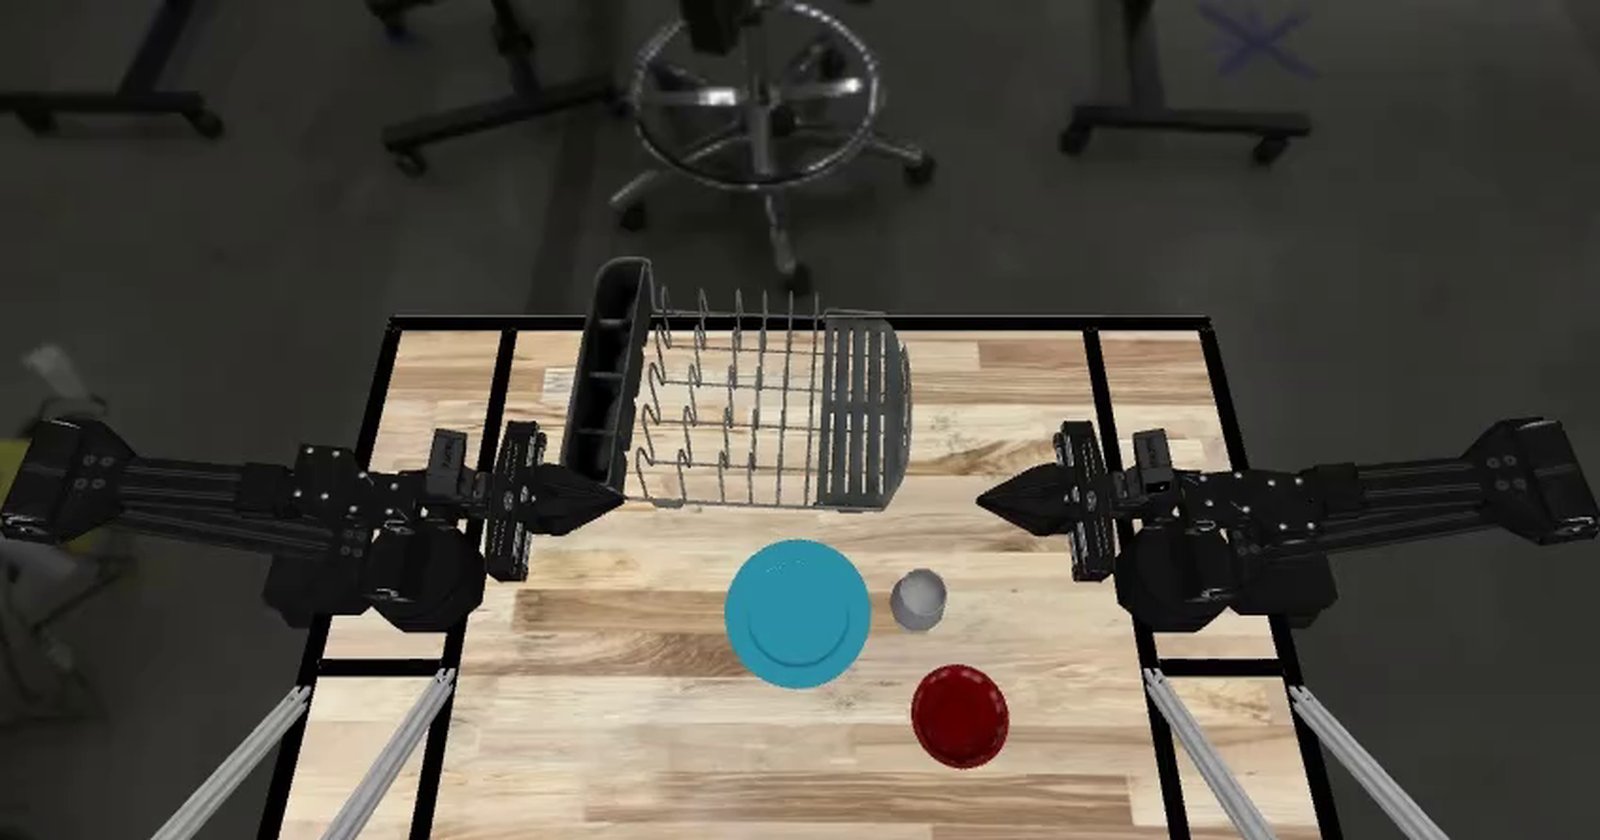
No dia 20 de agosto de 2026, pesquisadores divulgaram no arXiv o artigo "EXIMO: VLM Guided Exploration of VLA Policies" (arXiv:2608.19891v1). O estudo apresenta um algoritmo em três etapas — explore, imitate e optimize — para fazer o finetuning eficiente de políticas VLA (vision-language-action) em novas tarefas de manipulação robótica.
O método funciona da seguinte forma: na fase de exploração, um modelo de linguagem visual (VLM) atua como planejador, quebrando tarefas longas e complexas em subtarefas menores para o VLA executar. O VLM e o VLA juntos coletam um dataset orquestrado. Na fase de imitação, o VLA é treinado com esses dados. Por fim, na fase de otimização, usa-se RL off-policy residual para refinar a política.
Nos experimentos, o EXIMO superou abordagens existentes tanto em eficiência de amostragem quanto em performance final, segundo o artigo.
Contexto
Os modelos VLA de última geração — com bilhões de parâmetros — são treinados por behaviour cloning em datasets massivos de teleoperação. Essa abordagem trouxe avanços significativos para manipulação robótica, mas tem um custo alto: coletar dados de teleoperação exige centenas de horas de trabalho humano dispendioso.
A alternativa mais óbvia seria reinforcement learning (RL), que é historicamente ineficiente em termos de amostras, especialmente em tarefas de longo horizonte. Somado a isso, aplicar RL em VLAs esbarra na arquitetura desses modelos — são grandes demais para o treinamento convencional por RL. Isso deixou o finetuning de VLA em novas tarefas como um problema em aberto na robótica.
Por que importa
O custo de treinar robôs para novas tarefas é um obstáculo real para adoção em escala. Se cada nova tarefa requer centenas de horas de dados coletados por especialistas, a adoção de robôs em ambientes flexíveis (fábricas, logística,agricultura) fica travada. Um método que reduz drasticamente a necessidade de dados humanos pode acelerar a transição de robôs de tarefas fixas para ambientes adaptáveis.
Além disso, o EXIMO mistura abordagens que normalmente são tratadas separadamente — VLM, behaviour cloning e RL — em um pipeline coeso, o que indica uma tendência de convergência de técnicas em IA para robótica.
Impacto
De curto prazo, o EXIMO pode acelerar pesquisas em laboratórios que trabalham com robótica colaborativa e manipulação. De médio prazo, empresas de automação industrial podem usar variações desse método para adaptar robôs a novas tarefas de produção com menos downtime e custo de treinamento.
A pesquisa também sinaliza que o mercado de VLA models — dominado por abordagens de escala — pode começar a priorizar eficiência e adaptabilidade, não apenas tamanho do dataset.
O que muda
O principal ganho é a redução do custo de adaptação: em vez de coletar centenas de horas de teleoperação, o pipeline permite que o próprio sistema gere dados organizados antes do treinamento. Isso pode mudar a forma como empresas e pesquisadores abordam a transferência de políticas robóticas para novas tarefas.
A combinação de planejamento por linguagem com RL residual também abre caminho para sistemas mais híbridos, onde modelos de linguagem não apenas compreendem instruções, mas participam ativamente do ciclo de treinamento.
O que vem agora
O artigo está em fase de divulgação inicial (arXiv preprint). Os próximos passos incluem revisão por pares, testes em ambientes mais diversificados e possíveis implementações open-source. O campo de VLA finetuning continua ativo, com diversas equipes trabalhando em soluções competitivas.