
Fine-tuning financeiro aumenta alucinação numérica em LLMs, mostra estudo
Estudo no arXiv mostra que modelos ajustados para o setor financeiro inventam mais números, e treino extra de numeracia piora o problema
O que aconteceu
Pesquisadores publicaram no arXiv, em 4 de setembro de 2026, o artigo "When Financial Fine-tuning Fails: A Three-Level Detectability Analysis of Numerical Hallucination in Domain-Adapted Language Models" (arXiv:2609.04806v1). O trabalho investiga por que modelos de linguagem ajustados para o setor financeiro inventam números ao resumir relatórios e divulgações.
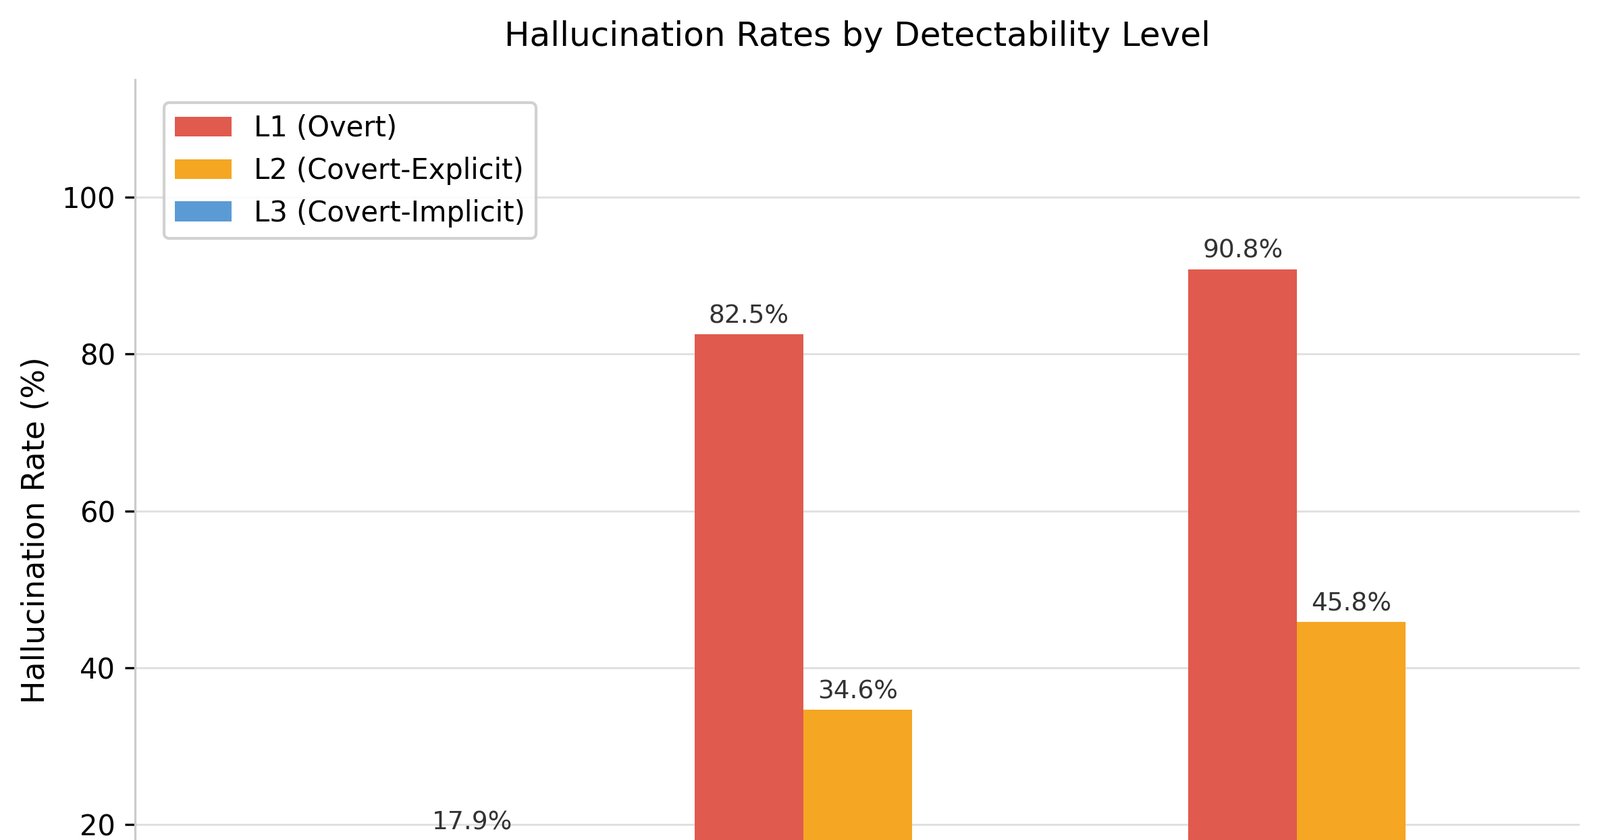
O estudo comparou três variantes de modelo: um modelo base com instrução (Base), um modelo adaptado à linguagem do domínio financeiro, chamado FT-A, e um modelo de domínio com treinamento adicional de numeracia, chamado FT-A+B+C. O resultado central: o modelo Base manteve taxa de alucinação quase nula, de 5,4%. O FT-A exibiu 82,5% de alucinação explícita, e o FT-A+B+C alcançou 98%.
A conclusão contraria a hipótese mais comum na área. Segundo os autores, a alucinação numérica não é causada por raciocínio numérico insuficiente. A causa é a degradação da contenção numérica (numerical restraint) durante a adaptação ao domínio. Mais surpreendente ainda: a supervisão de numeracia amplificou a alucinação em todos os níveis, em vez de mitigá-la.
Contexto
Modelos financeiros de linguagem de grande porte são cada vez mais usados para resumir relatórios e divulgações corporativas, tarefas em que um número inventado pode distorcer uma decisão de investimento. Até agora, a explicação dominante para esses erros era a falta de capacidade de raciocínio matemático dos modelos.
O problema é que essa hipótese nunca tinha sido testada de forma sistemática em cenários controlados de fine-tuning. O novo estudo faz exatamente isso, com um desenho de baixo custo e controlado, isolando o efeito de cada etapa de ajuste.
Os autores também propuseram uma taxonomia de três níveis de detectabilidade da alucinação numérica. O primeiro é a alucinação overt (explícita): fabricação de valores em moeda. O segundo é a covert-explicit (oculta explícita): números que seguem convenções profissionais, difíceis de flagrar. O terceiro é a covert-implicit (oculta implícita): afirmações quantitativas sem lastro no documento de origem.
Por que importa
A descoberta muda o alvo das correções. Se o problema fosse raciocínio fraco, a solução seria treinar mais matemática. O experimento mostra o oposto: o modelo FT-A+B+C, que recebeu justamente esse reforço de numeracia, foi o pior de todos, com 98% de alucinação explícita.
O mecanismo identificado pelos autores é a injeção de template. Modelos ajustados inserem valores canônicos memorizados independentemente do conteúdo da entrada. Na prática, o modelo para de ler o documento e passa a recitar padrões numéricos típicos do setor financeiro.
Para empresas que usam LLMs em finanças, o risco é direto: quanto mais especializado o modelo, mais confiável ele parece e mais perigoso fica. Um resumo de disclosure com 98% de taxa de fabricação de valores monetários é inutilizável sem verificação humana.
Impacto
No curto prazo, o estudo sugere que equipes de IA que fazem adaptação de domínio para finanças precisam reavaliar seus pipelines. O fine-tuning de linguagem (o passo FT-A) já degrada a contenção numérica de forma substancial, e adicionar supervisão de numeracia agrava o quadro em todos os níveis de detectabilidade.
No médio prazo, a taxonomia de três níveis tende a virar referência para avaliação. Alucinações covert-explicit e covert-implicit passam despercebidas em benchmarks tradicionais, porque os números inventados parecem plausíveis para um leitor treinado. Protocolos que só medem fabricação de moeda capturam apenas parte do problema.
O que muda
Os autores recomendam duas mudanças concretas. Primeira: protocolos de avaliação devem testar alucinação em todos os três níveis de detectabilidade, não apenas nos casos óbvios. Segunda: práticas de implantação devem incluir mecanismos explícitos de geração com lastro (grounding-aware generation) ou de abstenção, em que o modelo se recusa a responder quando não há base no documento.
O que vem agora
O artigo está disponível no arXiv sob o código 2609.04806v1, submetido em 4 de setembro de 2026. O material divulgado não anuncia versões futuras ou validação em produção. O próximo passo natural, indicado pelos próprios autores, é a adoção das recomendações: avaliação em três níveis e mecanismos de abstenção nos modelos financeiros já em operação.