
FLoKD corta até 65% da comunicação no treino federado de LLMs
Framework combina LoRA federado e destilação por ativações intermediárias para treinar modelos de linguagem em redes sem fio limitadas
O que aconteceu
Pesquisadores publicaram no arXiv, em 11 de setembro de 2026, o paper "FLoKD: Adaptive Knowledge Distillation for Federated Low-Rank LLM over Wireless Networks" (arXiv:2609.13580v1). O FLoKD é um framework de destilação de conhecimento adaptativo para ajuste fino federado de LLMs com Low-Rank Adaptation (LoRA) em redes sem fio.
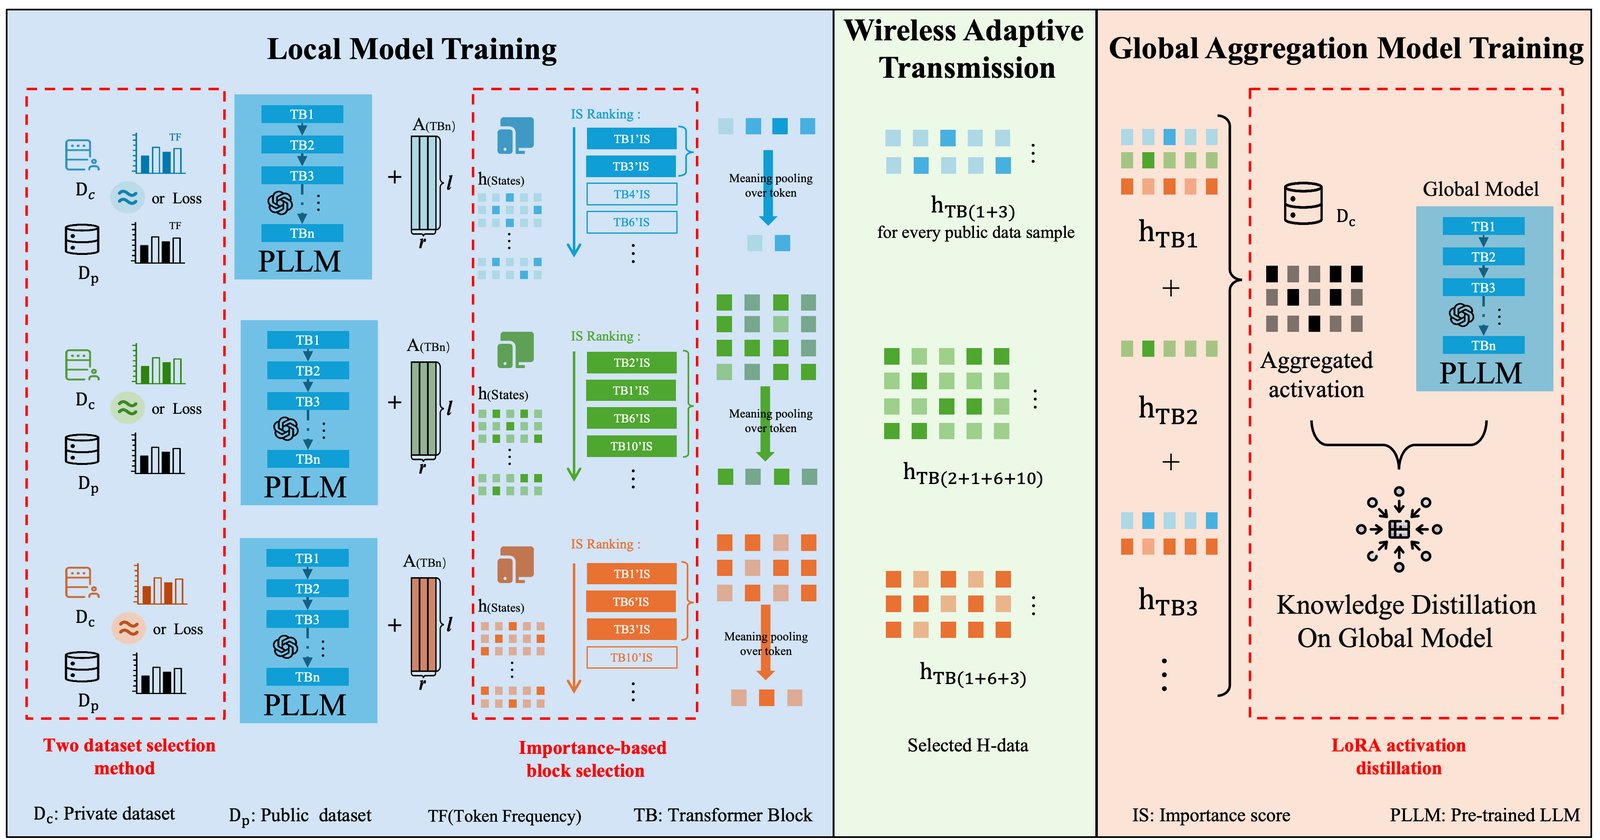
A proposta central do FLoKD é comunicar ativações intermediárias do LoRA como sinal de destilação. O framework evita duas alternativas caras: o envio de parâmetros completos do modelo e o envio de logits em nível de token.
Os autores relatam que o FLoKD reduz o overhead de comunicação entre 50% e 65% em comparação com baselines. O framework também alcança convergência rápida para perplexidade competitiva, segundo os experimentos descritos no resumo do artigo.
Os testes do FLoKD cobriram múltiplos conjuntos de dados de linguagem generativa. Entre eles estão WikiText-103, PTB e Dialog.
Contexto
O ponto de partida do paper é um problema conhecido de quem treina LLMs: o ajuste fino convencional depende de coleta centralizada de dados, o que levanta preocupações de privacidade. O aprendizado federado (federated learning, ou FL) surge como resposta, permitindo o ajuste fino colaborativo de LLMs sem que os dados brutos dos clientes saiam de onde estão.
O obstáculo é de infraestrutura. A implantação de aprendizado federado em redes sem fio com banda restrita esbarra no custo de transmitir parâmetros de modelo pela rede. O LoRA reduz o número de parâmetros treináveis, mas seu custo de comunicação continua crescendo conforme o modelo aumenta.
A destilação de conhecimento aparece como alternativa porque dispensa o compartilhamento de parâmetros, usando logits de saída como sinal. Em LLMs, porém, logits em nível de token saem caros por causa do comprimento da sequência e do tamanho do vocabulário. Cortar logits reduz o custo, mas enfraquece a supervisão e derruba a acurácia. É esse impasse que o FLoKD tenta resolver.
Por que importa
O gargalo de comunicação é o que separa o aprendizado federado de LLMs da operação real em redes sem fio. Cada rodada de treino exige trafegar dados entre clientes e servidor, e a conta cresce com o tamanho do modelo. Um corte de 50% a 65% nesse tráfego muda a viabilidade econômica de projetos que dependem de banda limitada.
O FLoKD ataca o problema em duas frentes além das ativações. A primeira é um framework de pontuação de importância de blocos do transformer, que transmite seletivamente apenas os blocos mais informativos, em vez de enviar todos os blocos ao longo de todo o dataset público. A segunda são duas estratégias de seleção de dados: descartar amostras públicas que se desviam da distribuição de dados local e priorizar as amostras mais informativas para a destilação.
O efeito prático é que o FLoKD reduz o volume de informação trocada sem abrir mão do sinal de supervisão que sustenta a qualidade do modelo ajustado.
Impacto
Para quem opera treino distribuído, o ganho declarado no paper é direto: menos banda por rodada de treino. O FLoKD comunica ativações intermediárias do LoRA, e não logits ou parâmetros completos, o que reduz o volume transmitido em cada interação entre clientes e servidor.
O impacto se amplia em cenários de conectividade restrita, onde o custo de transmissão costuma inviabilizar o ajuste fino federado de modelos grandes. A seleção de blocos e de amostras do FLoKD adiciona outra camada de economia, porque evita enviar dados e blocos com pouca contribuição para a destilação.
O paper posiciona o FLoKD como uma alternativa que combina duas técnicas já conhecidas, LoRA e destilação de conhecimento, em um desenho adaptativo para redes sem fio. A redução de 50% a 65% no overhead de comunicação é a métrica que os autores usam para sustentar a comparação com baselines.
O que muda
O FLoKD muda a unidade de informação trocada entre clientes em um treino federado. No lugar de parâmetros ou logits, trafegam ativações intermediárias do LoRA. A escolha responde ao problema de custo dos logits em LLMs, que cresce com o comprimento da sequência e o tamanho do vocabulário.
A segunda mudança é a seletividade. O framework de pontuação de importância de blocos do transformer define quais blocos merecem ser transmitidos. As duas estratégias de seleção de dataset definem quais amostras públicas entram na destilação.
O resultado relatado é convergência rápida para perplexidade competitiva, medida nos conjuntos WikiText-103, PTB e Dialog. Perplexidade é a métrica usada para avaliar o quão bem um modelo de linguagem prevê texto.
O que vem agora
O paper foi submetido em 11 de setembro de 2026 e está disponível no arXiv sob o identificador 2609.13580v1. O material não informa cronograma de publicação em conferência, liberação de código ou testes fora dos três conjuntos citados.
Os próximos passos naturais dependem de replicação independente do FLoKD e de avaliação em redes reais, não apenas nas condições descritas no artigo. Até lá, os números de redução de comunicação entre 50% e 65% seguem como resultado reportado pelos autores do FLoKD.
Fontes
- arXiv cs.AI: FLoKD: Adaptive Knowledge Distillation for Federated Low-Rank LLM over Wireless Networks (https://arxiv.org/abs/2609.13580)