
GPS-Bench: benchmark para simular impacto de políticas públicas com LLMs
Pesquisadores criam padrão para medir quando agentes de IA preveem quem ganha e perde com uma política. Fine-tuning supera multiagentes.
O que aconteceu
O GPS-Bench (Governance Policy Simulation Benchmark) foi apresentado em um artigo científico postado no repositório arXiv no dia 3 de setembro de 2026, com o identificador 2609.03553v1. A equipe, que tem David Williams-King como autor de correspondência, propõe um padrão ligando políticas públicas a atores, ações e impactos, usando registros legislativos, declarações de lobby, documentos regulatórios, arquivos corporativos e dados econômicos como evidência.
O GPS-Bench, benchmark para automação de análise de políticas, reconstrói atores a partir do histórico datado de evidências, em vez de usar arquétipos genéricos. Cada persona vira um objeto de evidência com procedência verificável. Um conjunto rotulado por humanos forma a avaliação Gold, enquanto casos classificados por outro LLM a partir de evidências recuperadas servem apenas como supervisão Silver, nunca como rótulos de teste.
Contexto
A análise de políticas públicas tradicionalmente se apoia em prever se uma proposta será aprovada. Os autores do GPS-Bench argumentam que isso é insuficiente. Para eles, o processo exige identificar quem será afetado, como esses atores respondem e o que acontece depois. Simulações baseadas em LLMs modelam esses processos em escala, mas a validade delas fica difícil de estabelecer quando o comportamento plausível nunca é comparado com resultados observados.
Antes do GPS-Bench, faltava um terreno comum para testar se a interação multiagente adiciona valor real ou apenas complexidade. O benchmark foi desenhado justamente para transformar essa pergunta em uma comparação controlada. Cada modo de inferência lê o mesmo estado fundamentado e emite o mesmo esquema de saída. A equipe contrastou raciocínio conjunto, agentes independentes e comunicantes, métodos baseados em grafos e fine-tuning em nível de pesos sobre um único estado de política.
Por que importa
Os resultados iniciais contrariam parte do hype em torno de sistemas multiagente. O fine-tuning no registro fundamentado produziu a previsão de impacto mais forte no nível de atores, e a decomposição não superou essa abordagem. O que a decomposição agrega é mecanismo, ou seja, explicação de como e por que um impacto ocorre, não mais precisão preditiva.
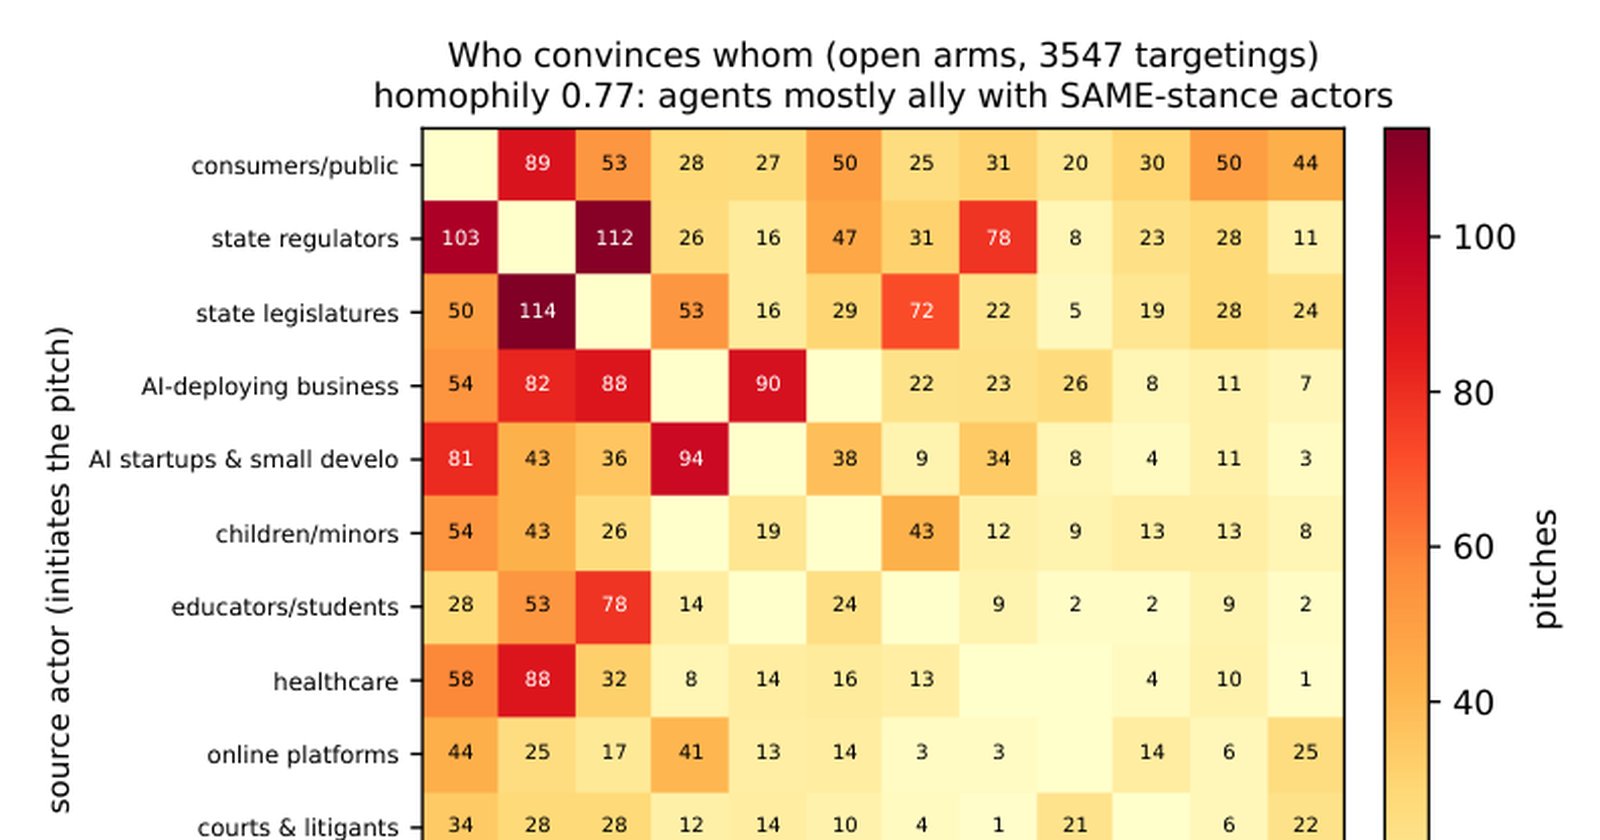
Os agentes do GPS-Bench operam com evidência privada e não idêntica. Cada um vê sua própria cláusula de exposição ao risco. Eles se dirigem a parceiros nomeados com propostas conjuntas concretas, informando o que oferecem, o que precisam em troca e por que agir juntos supera agir sozinho. Isso permite que as coalizões formadas sejam checadas contra os compromissos reais registrados na base de evidências.
Impacto
Para o campo de políticas públicas, o GPS-Bench oferece um ambiente empírico comum para estudar quando evidência, modelagem de atores e interação multiagente melhoram a previsão e a interpretação de resultados políticos. Para a indústria de IA, o benchmark funciona como um teste de estresse: se fine-tuning simples supera arquiteturas multiagente complexas nesse domínio, o mesmo pode ocorrer em outras tarefas de raciocínio sobre documentos.
O desenho do GPS-Bench tem implicações diretas para quem constrói ferramentas de análise legislativa automatizada. A distinção entre ouro e prata na rotulagem evita um viés comum em benchmarks de IA, onde o modelo que gera os rótulos acaba beneficiado na avaliação. Em vez disso, o GPS-Bench separa claramente supervisão automática de validação humana.
O que muda
A mudança mais concreta é metodológica: quem pesquisa simulação de políticas agora tem um padrão com evidência real, e não cenários hipotéticos. Isso aproxima a pesquisa de IA de dados observacionais do mundo real, incluindo registros de lobby e arquivos corporativos, fontes raramente usadas em benchmarks de linguagem natural.
No Brasil, o GPS-Bench pode interessar a quem monitora o Congresso Nacional e a regulação de setores como finanças e tecnologia. A mesma estrutura de relacionar projetos de lei a atores e impactos observados poderia ser adaptada ao processo legislativo brasileiro, onde a divulgação de contribuições de campanha e audiências públicas gera registros datados semelhantes aos usados no benchmark.
O que vem agora
O artigo foi disponibilizado no arXiv em 3 de setembro de 2026 e está na versão inicial, marcada como v1. Os próximos passos esperados incluem a liberação do código e dos conjuntos de dados de avaliação, mencionados nos links do arXiv como Code, Data and Media Associated with this Article. A validação externa dependerá de outros grupos rodando o benchmark e comparando resultados.
Como o GPS-Bench, benchmark para automação de análise de políticas públicas, ainda não passou por revisão por pares formal, a comunidade de pesquisadores em IA e ciência política deve examinar os critérios de rotulagem Gold e a qualidade das fontes de evidência. O teste real será se as previsões do benchmark se sustentam quando aplicadas a políticas ainda não observadas.