
HBF: Memória Flash de Alta Largura de Banda Apresentada no Hot Chips 2026
Técnica usa flash no formato HBM para expandir memória de GPUs, com foco em workloads de machine learning
O Que Aconteceu
Na quarta-feira, 20 de agosto de 2026, durante o dia de tutoriais do Hot Chips 2026, os pesquisadores Anurag Agarwal e Radhakrishna Giduthuri apresentaram a palestra "Applying High Bandwidth Flash (HBF)". O conteúdo da apresentação, compartilhado no portal Chips and Cheese, foca em simulações e projeções, já que nenhum produto de HBF existe no mercado ainda. O objetivo central é mostrar como o software, em workloads de machine learning, poderia se adaptar para aproveitar essa nova tecnologia de memória.
Contexto
O HBF representa uma tentativa de resolver um gargalo fundamental na computação de alta performance para IA: a limitação de capacidade da memória de alta largura de banda (HBM). O HBM, que já empacota memóriaDRAM diretamente no package do chip de computação (GPU), oferece bandwidth altíssima, mas sua capacidade em gigabytes é restrita e seu custo por gigabyte é elevado. O HBF, por outro lado, utiliza a tecnologia de flash NAND, a mesma dos SSDs comuns, mas a implementa em um fator de forma semelhante ao do HBM, posicionando "cubos" de flash ao lado do chip de computação e até mesmo do HBM. A ideia é oferecer uma camada de memória com capacidade muito maior, ideal para guardar dados que não precisam ser acessados a cada ciclo, mantendo uma largura de banda decente.
Por Que Importa
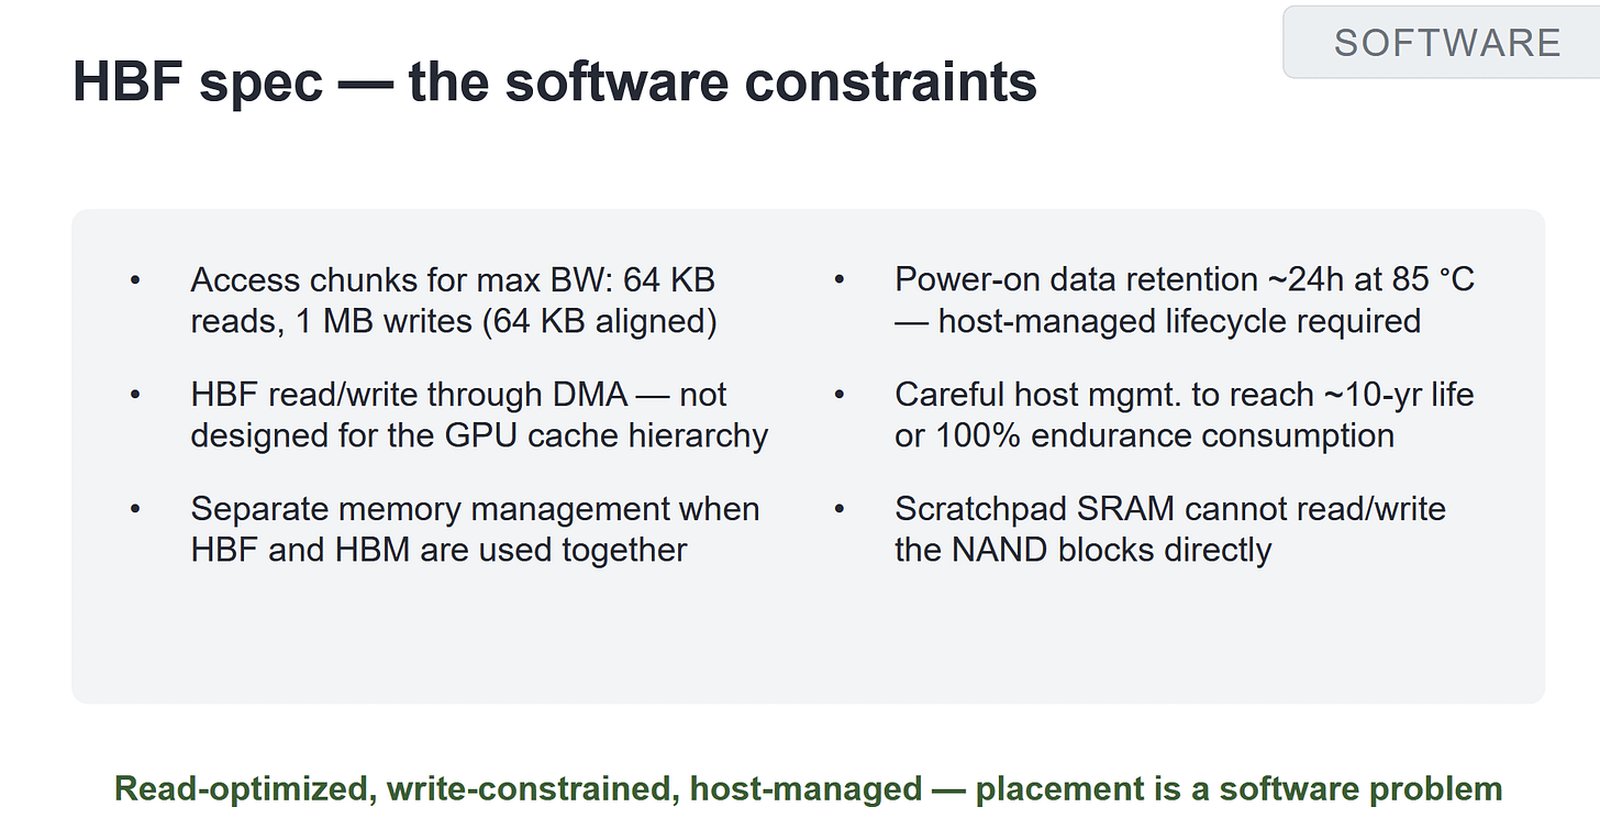
A importância técnica do HBF está em sua arquitetura híbrida. Diferente do agora extinto Optane da Intel, que funcionava como uma extensão da memória do sistema, o HBF opera mais como um SSD integrado ao processador. Isso muda radicalmente o paradigma para o software. Os acessos a HBF precisam ser feitos em blocos grandes e alinhados, usando DMA (Direct Memory Access), exatamente como se faz com uma unidade de armazenamento em massa. O software host também precisa assumir funções de um controlador de SSD, como gerenciar write leveling (escritas niveladas) e garantir a retenção de dados. Conforme explicou Giduthuri na palestra, isso significa que o HBF "não pode ser uma solução plug-and-play". A vantagem vem para quem tiver um runtime especializado, como o exemplo do vLLM, um popular servidor para inferência de modelos de linguagem grandes (LLMs).
Impacto
No exemplo prático apresentado com o vLLM, o impacto potencial é direto no custo e viabilidade de rodar modelos maiores. Uma estratégia viável é armazenar os pesos do modelo no HBF e usar DMA para carregar apenas os expertos ativos (em arquiteturas de MoE) para o HBM quando necessário. Outra aplicação promissora é colocar a cache de chave-valor (KV cache) dos transformadores no HBF. Isso funciona bem em implementações com atenção esparsa, onde apenas um subconjunto dos tokens do topo do KV cache é lido a cada passo. A maior parte da cache pode ficar "fria" no flash, aproveitando a alta capacidade do HBF. Uma vantagem colateral apontada é a possibilidade de reduzir a comunicação entre múltiplas GPUs em modelos shardados, já que partes do modelo que não estão ativas podem residir no HBF local de cada acelerador, diminuindo a necessidade de scatter/gather cross-device.
O Que Muda
A introdução do HBF, se e quando chegar ao mercado, forçará uma reconfiguração profunda dos softwares de infraestrutura para IA. Não será uma atualização transparente para os frameworks existentes. Será necessário implementar uma camada de gerenciamento de memória e armazenamento totalmente nova, otimizada para as características específicas do flash no fator de forma HBM. O trade-off será sempre entre a enorme capacidade (e custo potencialmente menor por GB) e a menor largura de banda em comparação ao HBM. O software precisará ser inteligente o suficiente para manter os dados "quentes" no HBM e mover os "frios" para o HBF de forma eficiente, minimizando latência. Isso abre caminho para novos runtimes e otimizações específicas para arquiteturas de memória heterogêneas.
O Que Vem Agora
No estágio atual, o HBF é um conceito em fase de pesquisa e validação via simulação, conforme demonstrado na palestra do Hot Chips 2026. Não há anúncios de produtos ou prazos de disponibilidade comercial. O próximo passo lógico é a transição do conceito para projetos de silício reais, possivelmente envolvendo parcerias entre fabricantes de GPUs e de memória. Enquanto isso, a comunidade de software para IA,特别是 aqueles que trabalham com otimização de inferência e treinamento de modelos escaláveis, começará a explorar arquiteturas que possam tirar proveito de camadas de memória de alta capacidade, mesmo que ainda não seja o HBF específico. A palestra de Agarwal e Giduthuri serve como um roteiro inicial para essa adaptação necessária.