
HypReflect: personalização contínua de LLMs com auto-distilação guiada por hipóteses
Framework infere hipóteses explícitas e incertas, refina-as com novas evidências e usa auto-distilação para incorporar o modelo de usuário.
O que aconteceu
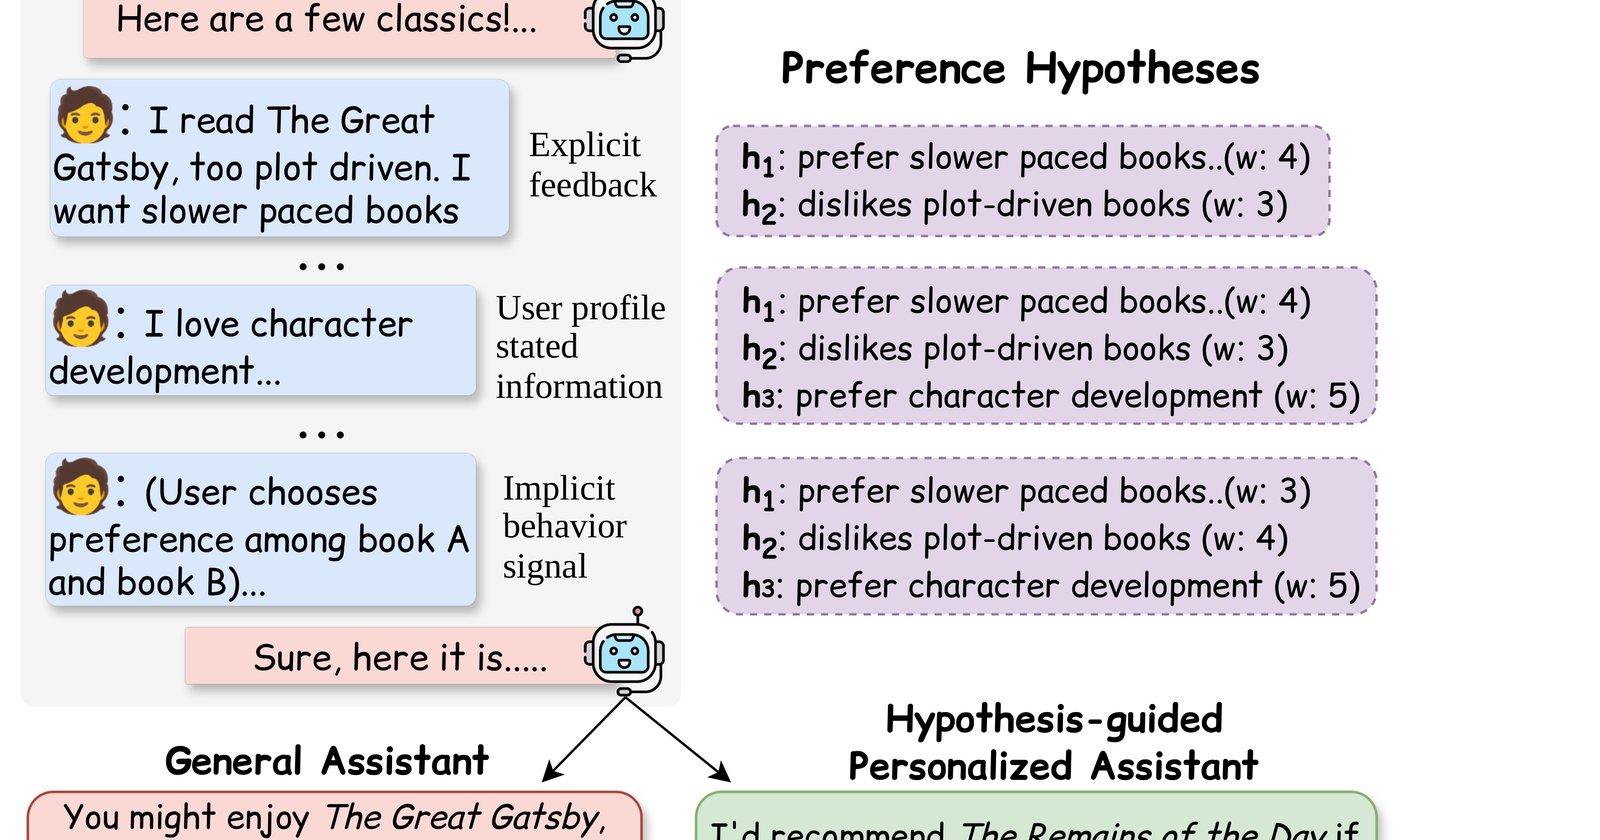
O artigo intitulado 'Hypotheses-Guided Self Distillation for Continual Personalization' foi submetido ao arXiv em 31 de agosto de 2026, com o identificador arXiv:2609.00251v1. O trabalho propõe o HypReflect, um framework que infere hipóteses de preferência do usuário a partir de sinais diversos, como interações online, sessões múltiplas e comportamentos implícitos. Essas hipóteses são explicitamente modeladas com incerteza e refinadas de forma reflexiva conforme novas evidências são acumuladas. O framework incorpora o modelo de usuário resultante ao modelo de linguagem por meio de um processo de auto-distilação guiada por hipóteses. Os experimentos cobrem três cenários: personalização online, interações multi-sessão e sinais comportamentais implícitos. Em todos eles, o HypReflect superou um conjunto de baselines, incluindo métodos de histórico bruto e de atualização incremental. Os autores também demonstraram forte generalização para usuários não vistos e configurações de domínio cruzado, além de estabilidade em diferentes orçamentos de contexto, hipóteses reutilizáveis e personalização mais focada.
Contexto
A personalização contínua é essencial para assistentes baseados em grandes modelos de linguagem (LLMs), já que as pessoas interagem com esses sistemas diariamente e esperam que eles se adaptem às suas preferências ao longo do tempo. No entanto, as preferências raramente são declaradas de forma completa; elas emergem de sinais heterogêneos, latentes e ruidosos. Métodos existentes dependem de históricos brutos de interação ou de otimização baseada em recompensas, que pode ser computacionalmente cara e difícil de escalar. O HypReflect surge como uma alternativa confiável e escalável, ao formular hipóteses explícitas e revisáveis sobre o usuário. Esse modelo de usuário é mantido e atualizado, permitindo que o sistema se adapte sem reprocessar todo o histórico.
Por que importa
O HypReflect demonstra que é possível personalizar modelos de linguagem de forma mais eficiente, sem depender de otimização por recompensas. Isso pode reduzir custos computacionais em aplicações de produção, como assistentes pessoais, atendimento ao cliente e ferramentas de produtividade. Além disso, a capacidade de generalizar para usuários não vistos e domínios cruzados indica que o framework pode ser implantado em larga escala, mesmo quando há poucos dados de interação. A abordagem também favorece a transparência: as hipóteses de preferência são explícitas e revisáveis, o que pode facilitar o controle do usuário sobre suas próprias configurações.
Impacto
No curto prazo, o HypReflect pode ser incorporado a sistemas de IA que precisam aprender preferências continuamente, como chatbots de suporte ou assistentes de voz. A estabilidade em diferentes orçamentos de contexto e a reutilização de hipóteses sugerem economia de recursos, já que o modelo não precisa ser re-treinado do zero. No médio prazo, a abordagem pode inspirar novos métodos de personalização que priorizem explicações e revisão, em vez de caixas-pretas. Isso pode mudar a forma como desenvolvedores projetam interações de longo prazo com LLMs.
O que muda
Em vez de alimentar o modelo com históricos crus de conversas, o HypReflect mantém um modelo de usuário explícito, atualizável e interpretável. Isso representa uma mudança conceitual: o sistema não apenas aprende com dados, mas constrói hipóteses sobre o usuário e as revisa quando necessário. Essa característica pode facilitar a auditoria do comportamento do assistente e dar ao usuário mais controle sobre como suas preferências são inferidas e aplicadas.
O que vem agora
Os autores do artigo ainda não divulgaram planos públicos de implementação, mas os resultados sugerem caminhos para aprofundar a pesquisa. As próximas etapas prováveis incluem testar o HypReflect em cenários mais complexos, como personalização em tempo real em múltiplos dispositivos, e integrá-lo a métodos de aprendizado por reforço. O artigo foi submetido ao arXiv em 31 de agosto de 2026 e ainda não passou por revisão por pares, portanto as conclusões devem ser avaliadas com cautela pela comunidade acadêmica.