
IA que decide quando perguntar contra desinformação de saúde
Pesquisadores propõem sistema que escolhe entre perguntar e corrigir a cada turno
O que aconteceu
O artigo intitulado "Ask or Answer: A Decision Framework for Multi-Turn Health Misinformation Intervention" foi depositado no repositório arXiv em 22 de agosto de 2026, na categoria Computer Science > Artificial Intelligence (cs.AI). O trabalho apresenta o Reward-Optimized Probe-and-Respond (RO-PnR), um framework que orienta modelos de linguagem a decidir, em cada turno de diálogo, se é melhor sondar o usuário com perguntas ou partir diretamente para a correção.
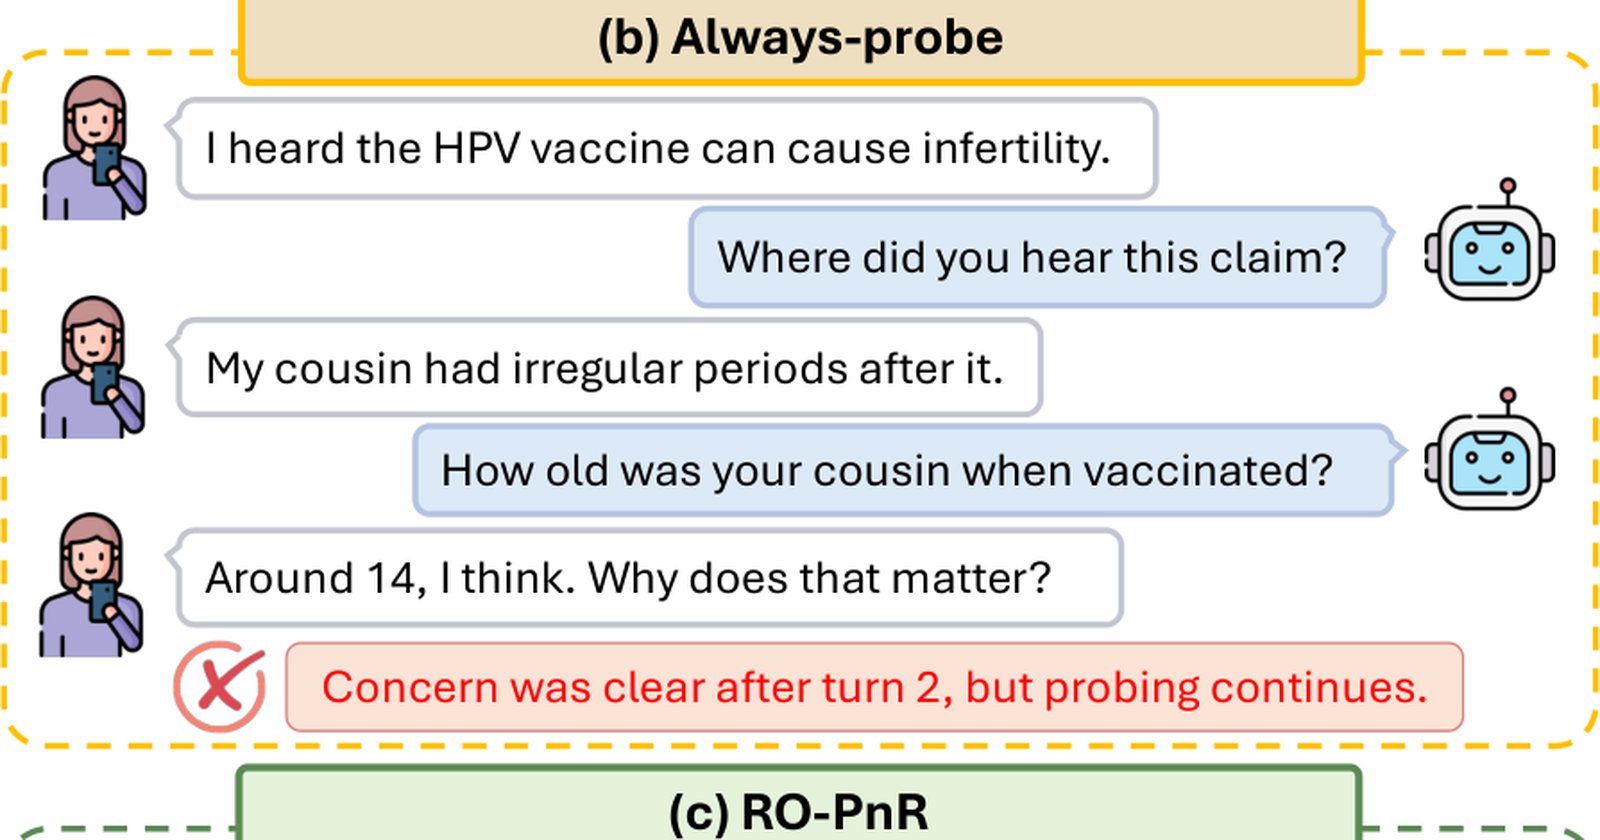
O RO-PnR é guiado por uma recompensa por turno que pondera o ganho esperado de perguntar contra o custo de interação. Conforme o resumo do paper, o framework alcançou a maior utilidade ajustada por custo em três conjuntos de dados de desinformação de saúde e em três modelos base, usando 30% menos turnos que as estratégias always-probe, ou seja, aquelas que sempre fazem perguntas.
No artigo, os pesquisadores descrevem o RO-PnR como uma resposta a dois extremos dos métodos existentes. De um lado, sistemas que respondem imediatamente, ignorando que o usuário pode precisar de esclarecimento. De outro, sistemas que perguntam sem critério, tratando a sondagem como algo sempre benéfico. O framework propõe um meio-termo aprendido, não uma regra fixa.
Contexto
O problema de corrigir desinformação em diálogo é conhecido na área de processamento de linguagem natural. Uma réplica factual nem sempre é suficiente, porque os usuários variam no que sabem, no que acreditam e no que precisam ouvir. Esse ponto aparece logo na abertura do resumo e define o foco da pesquisa.
Métodos anteriores tratavam a clarificação como desnecessária ou sempre útil. Isso gerava respostas apressadas ou sequências de perguntas que alongavam a conversa sem valor claro. O RO-PnR aborda essa lacuna modelando cada usuário simulado com um estado latente em dois eixos: letramento em saúde e compromisso com a crença. O primeiro indica o quanto a pessoa entende de termos médicos; o segundo, o quão fixa ela está na ideia errada.
Essa modelagem permite ao sistema estimar, antes de cada pergunta, qual seria o ganho esperado da sondagem. Se o usuário é pouco letrado, uma pergunta mal direcionada pode confundir ainda mais. Se a crença é forte, o custo de interação pode não valer a pena. A decisão, portanto, é contextual e apreendida a partir de recompensas.
Por que importa
Para empresas que desenvolvem assistentes virtuais de saúde, o ganho é direto. Menos turnos significam menos custo de processamento e uma experiência mais ágil para o usuário. Para o paciente ou consumidor, uma conversa menos travada aumenta a chance de ele absorver a correção e sair da interação com a informação certa.
Outro ponto relevante é a personalização implícita. O RO-PnR adapta o comportamento sem exigir que o sistema declare explicitamente o perfil do usuário, o que reduz riscos de privacidade. Isso é especialmente sensível no setor de saúde, onde dados pessoais são protegidos por legislações como a LGPD, no Brasil.
O framework também dialoga com o uso crescente de chatbots em telemedicina e em canais de atendimento de operadoras de saúde. Nesse cenário, errar na dosagem das perguntas pode afastar o usuário ou até consolidar a desinformação, em vez de corrigi-la.
Impacto
No curto prazo, a proposta deve influenciar outros grupos de pesquisa em IA aplicada à saúde. A técnica de recompensa por turno já é usada em domínios como diálogo orientado a tarefas, mas aplicá-la a desinformação em múltiplos turnos é uma fronteira nova.
No médio prazo, o framework pode ser adaptado para plataformas de saúde digital e para sistemas de checagem de fatos. O trade-off entre perguntar e responder, medido por custo de interação, é um conceito que pode se espalhar para outros tipos de desinformação, como financeira ou política. A abordagem não fica restrita a textos: o mesmo princípio pode valer para voz.
A redução de 30% no número de turnos, quando aplicada em escala, representa economia de computação e de tempo de usuário em produtos comerciais. Mas o resultado precisa ser validado com usuários reais, algo que o paper ainda não relatou.
O que muda
A principal mudança de mentalidade é abandonar a dicotomia entre "sempre perguntar" e "nunca perguntar". O RO-PnR estabelece uma política intermediária, em que a decisão é condicionada ao contexto do usuário. Isso alinha o comportamento do sistema com o que um profissional de saúde faz: avalia antes de corrigir.
Para desenvolvedores, o framework oferece uma arquitetura clara: uma recompensa por turno, uma modelagem latente de usuário e um mecanismo de decisão entre sonda e corrige. Isso facilita a reprodução e a adaptação em outros modelos de linguagem.
Para pesquisadores, o artigo abre perguntas sobre como definir o custo de interação em diferentes culturas e idiomas. Um turno a mais pode ser aceitável em um contexto, mas irritante em outro. O RO-PnR parte de uma função de custo fixa, o que pode ser uma limitação.
O framework RO-PnR, descrito no resumo, também sugere que a personalização pode ser aprendida sem dados biométricos ou históricos clínicos. Isso reduz barreiras regulatórias e facilita a adoção em mercados como o Brasil, onde a coleta de dados de saúde é altamente restritiva.
O que vem agora
O artigo está em fase inicial de divulgação. Não há código público, demos ou dados de validação com usuários reais anunciados no material. Os próximos passos naturais incluem reprodução independente dos resultados, extensão para outros idiomas e domínios de desinformação, e testes em ambientes controlados com participantes humanos.
O paper pode ser consultado na íntegra no repositório arXiv, sob o código 2608.21721. A comunidade de IA em saúde deve acompanhar se os autores vão liberar implementações e se outros grupos conseguirão replicar o ganho de 30% em turnos.
Enquanto isso, o trabalho serve como um lembrete de que a qualidade de um sistema de diálogo não está só na precisão da resposta, mas também em saber quando abrir espaço para uma pergunta.