
IBM Spyre leva RAG seguro a LinuxONE com latência de 2s
Arquitetura de seis subsistemas mantém dados sensíveis dentro do hardware em ambientes regulados.
O que aconteceu
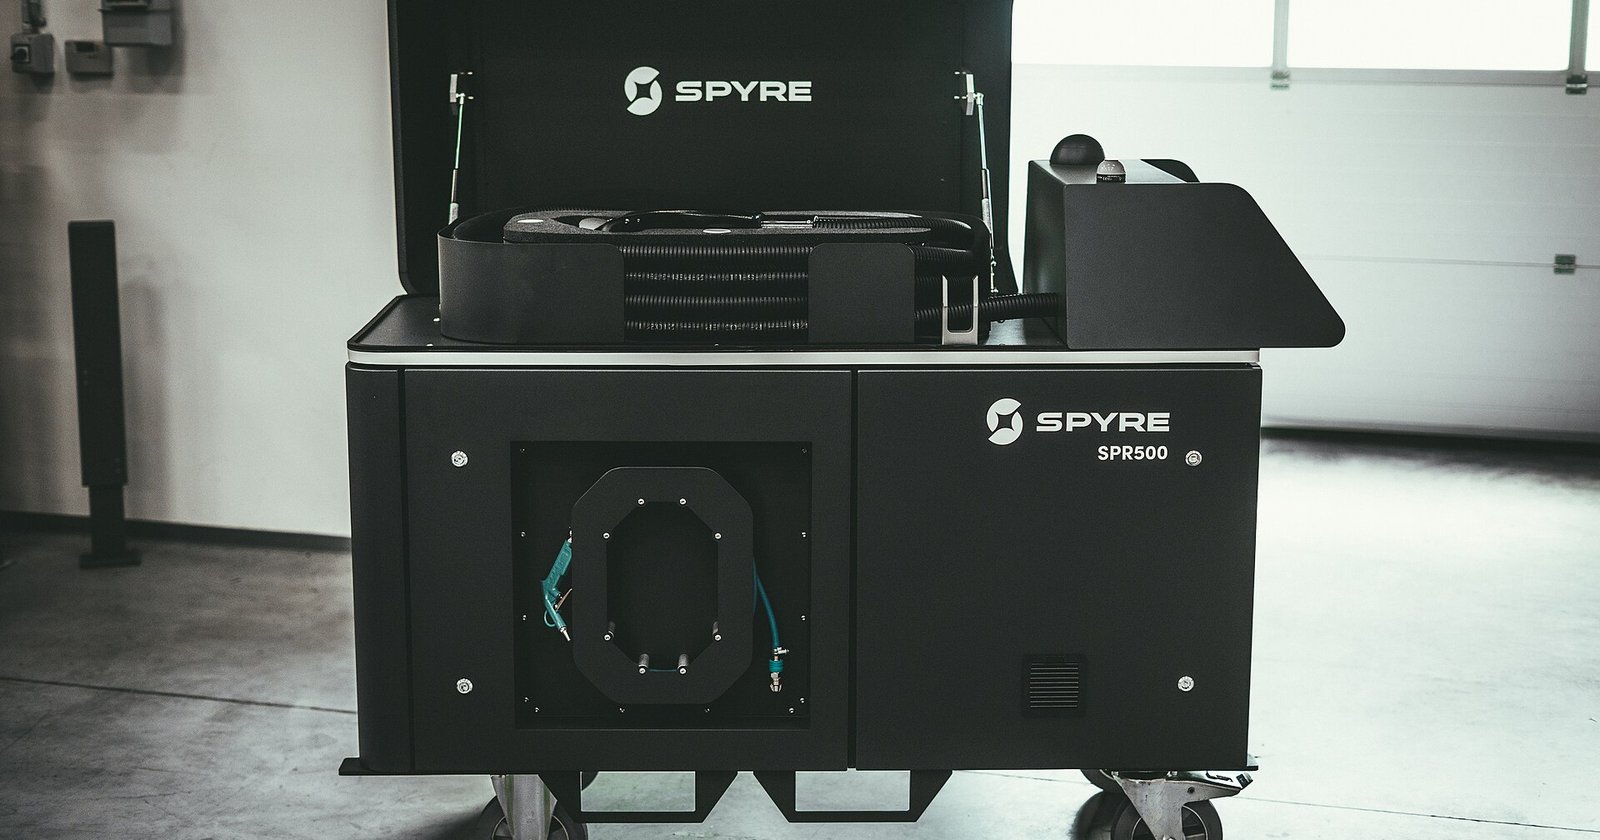
O artigo técnico intitulado "Spyre-Accelerated Retrieval-Augmented Generation on IBM LinuxONE" apresenta uma solução de seis subsistemas para executar LLMs em produção. A IBM desenvolveu o acelerador Spyre como uma placa PCIe de inferência para a família LinuxONE e IBM Z. No pipeline, o Spyre cuida da geração de tokens, o acelerador on-chip Telum II processa tarefas leves de classificação e o Red Hat OpenShift orquestra os contêineres. Todos os estágios, da entrada da consulta ao vetor de recuperação, passando pela montagem do prompt, inferência, filtragem de compliance e entrega da resposta, permanecem dentro do mesmo sistema LinuxONE. O estudo foi submetido ao arXiv em 2 de agosto de 2026 e divulgado publicamente na plataforma em 25 de agosto do mesmo ano, com código de acesso 2608.21393.
Contexto
Rodar LLMs em ambientes corporativos sempre esbarrou em um dilema: os dados residem em um datacenter, enquanto a capacidade de processamento costuma estar em outro ambiente, geralmente na nuvem. Esse deslocamento constante gera latência, aumenta a superfície de ataque e complica a conformidade com regulamentações de proteção de dados. A IBM vem posicionando o LinuxONE como uma plataforma de missão crítica para bancos e seguradoras, justamente por sua robustez em segurança e disponibilidade. Com o Spyre, a empresa quer levar a inferência de IA generativa para esse mesmo hardware, eliminando a necessidade de mover informações sensíveis. A tecnologia Secure Execution, já presente no LinuxONE, é estendida para proteger os workloads de IA, garantindo que os dados permaneçam criptografados até durante o processamento.
Por que importa
Para setores altamente regulados, como bancos, saúde e administração pública, a possibilidade de executar uma solução completa de RAG sem que os dados saiam do servidor muda o jogo. Em vez de depender de GPUs na nuvem, que exigem deslocamento de dados, a empresa pode manter tudo on-premises com performance comparável. Os números iniciais mostram latência de menos de 2 segundos para uma consulta RAG completa, e até 20 vezes menos tempo de inferência se comparado a rodar o mesmo modelo fora da plataforma. Isso significa que aplicações como busca semântica em bases jurídicas, atendimento ao cliente com IA e sistemas antifraude podem responder em tempo quase real, sem expor dados a terceiros.
Impacto
A arquitetura apresentada no artigo tem implicações práticas imediatas. Primeiro, o custo de infraestrutura pode cair: empresas que hoje alugam GPUs em nuvem para inferência podem passar a usar o LinuxONE já existente. Segundo, a latência reduzida viabiliza casos de uso que antes eram inviáveis, como triagem de documentos em tempo real ou assistentes que consultam bases de conhecimento atualizadas. Terceiro, a conformidade com leis como a LGPD e a GDPR fica mais simples, já que a auditoria é feita sobre um único hardware, sem fluxos de dados externos. O uso do OpenShift também facilita a adoção por devops, que já conhecem Kubernetes.
O que muda
A separação entre onde os dados vivem e onde a IA computa deixa de ser um obstáculo técnico. Com o Spyre embutido no LinuxONE, a inferência acontece no mesmo servidor que armazena as informações. Isso reduz a superfície de ataque, elimina gargalos de rede e simplifica a arquitetura. A filtragem de compliance, que é uma das etapas do pipeline, garante que respostas geradas pelo modelo não vazem informações confidenciais antes de chegar ao usuário. A integração com o Telum II, que já é usado para outras cargas no processador, otimiza o uso dos recursos.
O que vem agora
Os autores do estudo indicam que as análises são preliminares e que ainda serão feitos benchmarks mais detalhados, comparando o Spyre com alternativas baseadas em GPU na nuvem e on-premises. No curto prazo, a IBM deve começar a disponibilizar o Spyre comercialmente para clientes do LinuxONE e da família IBM Z, provavelmente como uma placa opcional nas próximas configurações. Não há data pública de lançamento, mas a publicação no arXiv sugere que a empresa já está validando a solução em ambientes reais. Para empresas que avaliam IA generativa sob forte controle regulatório, esse é um movimento a acompanhar de perto.