
ICL multimodal: framework usa contraste para alinhar raciocínio
Preprint propõe pares de respostas contrastivas e um controlador de alinhamento para tirar modelos multimodais da imitação superficial
O que aconteceu
O arXiv publicou em 11 de setembro de 2026, na lista de novidades da categoria cs.AI, o preprint arXiv:2609.10177v1. O trabalho foi submetido dois dias antes, em 9 de setembro. O título é "Beyond Surface Imitation: Contrastive Modeling for Reasoning Path Alignment in Multimodal In-Context Learning" e o objeto é o in-context learning (ICL) em modelos multimodais grandes, os MLLMs.
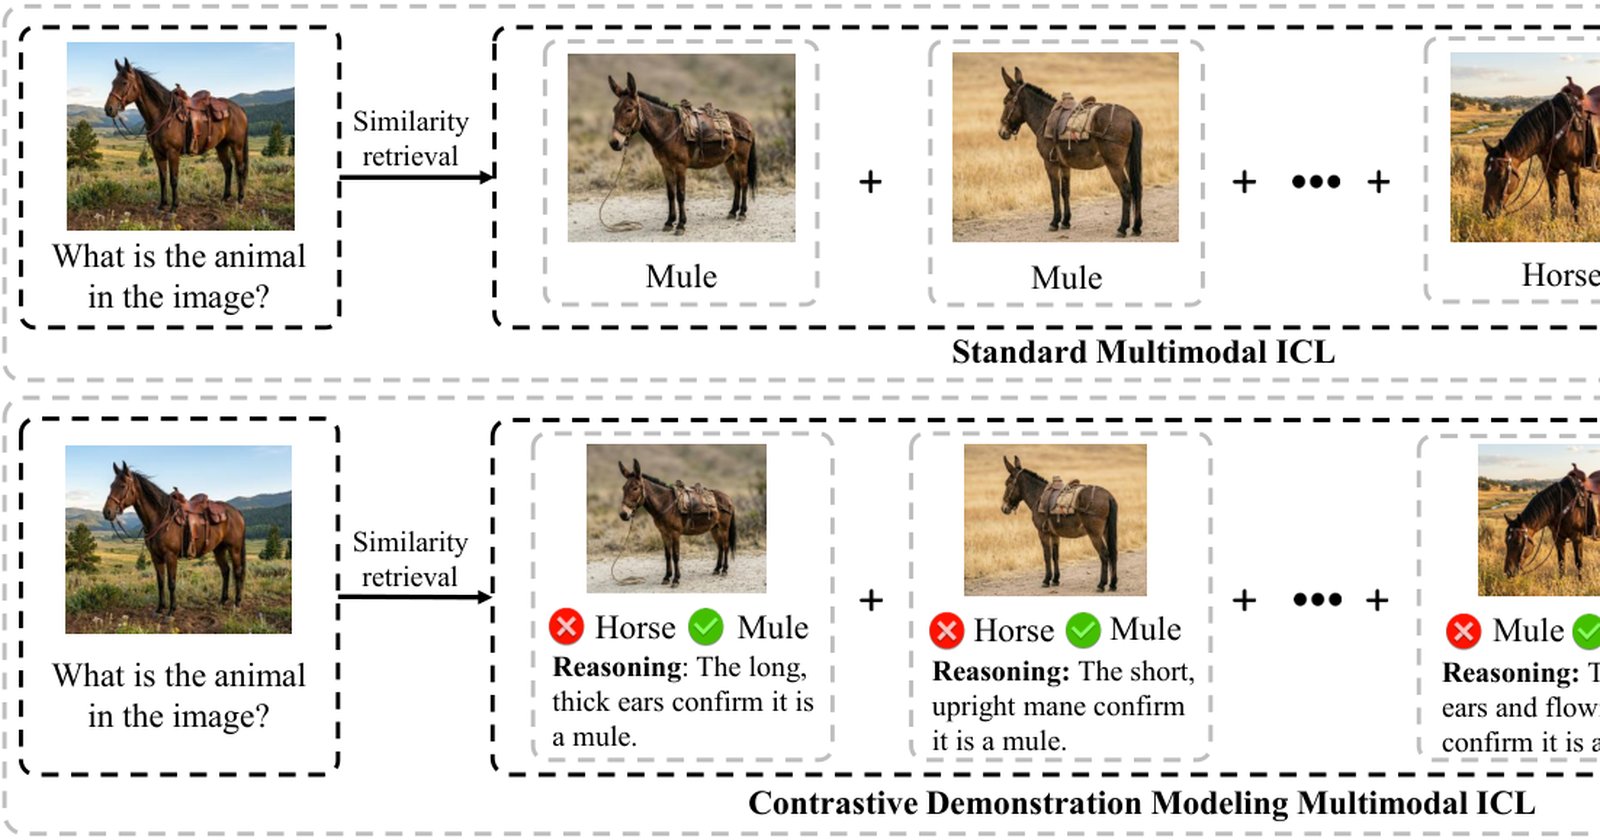
O framework descrito pelos autores ataca um problema específico. Modelos multimodais grandes tendem a imitar a superfície das demonstrações que recebem no contexto, em vez de seguir o caminho de raciocínio que a entrada multimodal exige. A proposta, batizada pelos autores no próprio resumo, tem três componentes.
O primeiro é a reformulação contrastiva de cada demonstração. Em vez de mostrar apenas um exemplo bem-sucedido, o framework contrasta explicitamente uma resposta subótima com uma resposta melhor para o mesmo input, e acrescenta o caminho de raciocínio que mostra como sair de uma e chegar à outra. O segundo é um mecanismo de retrieval condicionado pela resposta. Como o refinamento depende da resposta que o modelo está produzindo naquele instante, o sistema seleciona demonstrações cujos caminhos de raciocínio sejam mais relevantes para essa resposta atual. O terceiro é um controlador de alinhamento leve, que prevê a qualidade da resposta e decide se ela precisa de mais uma rodada de refinamento.
Os experimentos foram feitos em três tipos de tarefas multimodais. Segundo o resumo, o framework melhora o desempenho dos MLLMs de forma consistente, com ganhos especialmente notáveis em visual question answering (VQA).
Contexto
O ICL é uma técnica consolidada em MLLMs e entrega bom desempenho em uma ampla variedade de tarefas multimodais. O mecanismo é conhecido: o modelo recebe no prompt alguns exemplos resolvidos e generaliza o padrão para a nova entrada, sem passar por treinamento adicional.
O que o preprint aponta é o limite desse arranjo. Os métodos de ICL multimodal existentes dependem de imitação em nível de superfície das demonstrações. O modelo copia o formato e o estilo da resposta exibida, mas não necessariamente percorre o raciocínio que aquele tipo de pergunta exige. Em tarefas simples, a diferença passa despercebida. Em tarefas complexas, ela se amplifica e restringe os ganhos de desempenho dos MLLMs.
A formulação contrastiva é a resposta dos autores para esse gargalo. Ao colocar lado a lado uma resposta pior e uma resposta melhor sob o mesmo input, o caminho de raciocínio que leva à resposta desejada fica explícito no contexto. É esse caminho explícito que guia o MLLM além da imitação superficial.
Por que importa
Quem constrói produtos sobre MLLMs trabalha hoje com dois custos que o preprint endereça diretamente. O primeiro é o custo de contexto: demonstrações úteis ocupam espaço no prompt e, se servem apenas para imitação de superfície, entregam pouco retorno por token. O segundo é o custo de refino: sem um critério de qualidade, pipelines repetem rodadas de correção que podem não melhorar nada.
O controlador de alinhamento leve, componente do framework, existe justamente para prever a qualidade da resposta e decidir se mais refinamento é necessário. É um gate de custo computacional, não só de qualidade.
Vale registrar o que o material não traz. O resumo do arXiv:2609.10177v1 não informa números absolutos de benchmark, nem nomes de modelos testados, nem tamanho dos ganhos. Para quem compara métodos, esse dado é o que falta no preprint.
Impacto
No curto prazo, o impacto maior é sobre a comunidade de pesquisa em MLLMs. O framework contrastivo desloca a unidade de trabalho do ICL multimodal. O insumo deixa de ser um exemplo resolvido e passa a ser um par contrastivo acompanhado de um caminho de raciocínio. Isso muda a forma de montar conjuntos de demonstrações e de avaliar se elas estão ajudando.
No médio prazo, a mudança tende a aparecer na engenharia de pipelines. O retrieval condicionado pela resposta altera o critério de busca. A seleção deixa de olhar apenas a similaridade entre pergunta e demonstração e passa a considerar a resposta que o modelo já está produzindo. Sistemas de VQA, área em que os ganhos relatados são mais visíveis, são o primeiro lugar onde essa lógica deve ser testada.
O que muda
O framework contrastivo, apresentado no arXiv:2609.10177v1, troca três peças do fluxo padrão de ICL multimodal. A demonstração vira contraste explícito entre resposta subótima e resposta melhor. O retrieval vira seleção condicionada pela resposta corrente. O controle de qualidade vira um classificador leve que decide se vale refinar de novo.
Para times que hoje escrevem prompts com exemplos fixos, a conta muda de lugar. Ganha-se em alinhamento de raciocínio, mas paga-se na construção de demonstrações contrastivas, que exige curadoria de respostas ruins e boas para o mesmo input.
O que vem agora
O trabalho é um preprint, submetido em 9 de setembro de 2026 e anunciado no arXiv em 11 de setembro de 2026. Não passou por revisão por pares. O material não anuncia código, dataset ou página de projeto, o que limita a replicação imediata dos experimentos em três tipos de tarefas multimodais.
Os próximos passos esperados são a avaliação por pares e a reprodução independente dos ganhos em VQA. Até que isso aconteça, o framework contrastivo de alinhamento de raciocínio deve ser lido como proposta metodológica, com resultados relatados pelos próprios autores.
Fontes
- arXiv cs.AI: Beyond Surface Imitation: Contrastive Modeling for Reasoning Path Alignment in Multimodal In-Context Learning (https://arxiv.org/abs/2609.10177)