
Interpretabilidade de IA falha em critério do EU AI Act, mostra estudo
Nova pesquisa mostra que explicações de nível de circuito não sobrevivem a variações legítimas de análise
O que aconteceu
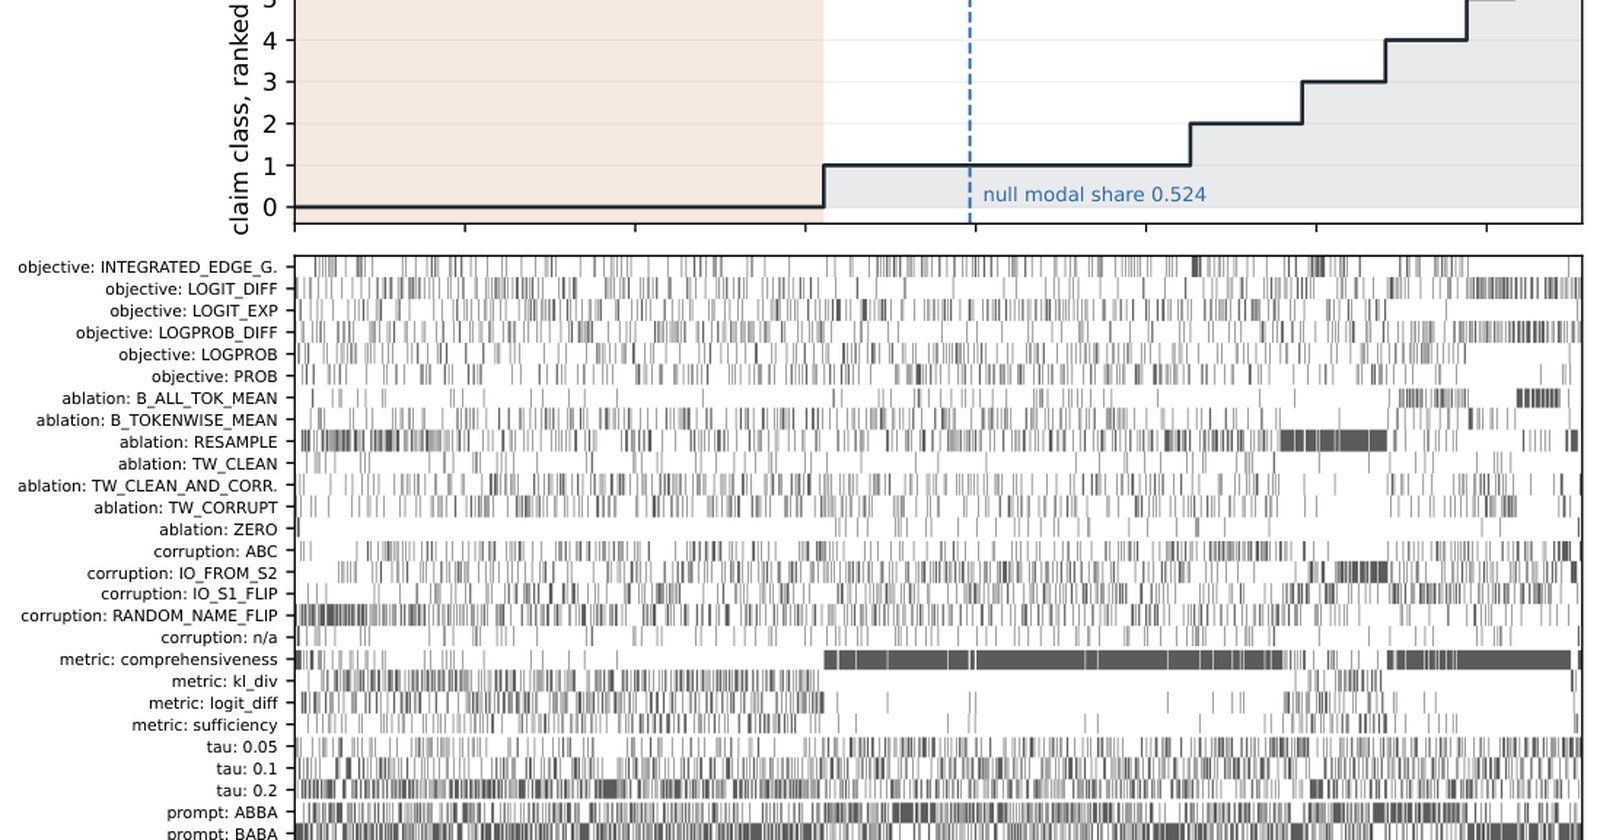
Pesquisadores liderados por Ajay Pravin Mahale testaram se a interpretabilidade de circuit-level pode fornecer evidências estáveis e confiáveis sobre decisões de sistemas de IA de alto risco, como exige o EU AI Act. O estudo utilizou o GPT-2 small na tarefa de identificação de objeto indireto, rodando 15.840 especificações pré-registradas em uma grade cruzada de sete eixos analíticos — todos extraídos de implementações publicadas na literatura.
Dos 15.840 cenários, 7.561 geraram alguma afirmação sobre o comportamento do modelo. O resultado foi direto: 73,2% dos pares de especificações produzem conclusões opostas sobre o mesmo sistema (intervalo de confiança de 95%: 0,725 a 0,738). A afirmação mais frequente — o chamado claim modal — responde por apenas 41,1% do espaço analítico total.
Mesmo após padronizar a escolha com maior influência (a métrica de avaliação), a taxa de inversão ficou em 59,4%. Ao remover o tamanho do circuito da afirmação e fixá-lo, o índice caiu para 27,1%, mas ainda assim ficou acima do limiar pré-registrado pelos autores. A pesquisa foi publicada no arXiv em 13 de agosto de 2026.
Contexto
O EU AI Act, regulamentação europeia de inteligência artificial, exige que provedores de sistemas de alto risco apresentem documentação técnica detalhando como o sistema alcança suas decisões. A interpretabilidade mecânica — especificamente a descoberta de circuitos — emergiu como a candidata natural para fornecer essa evidência. Circuitos são conjuntos de neurônios e conexões dentro de redes neurais associados a comportamentos específicos.
A pressão por soluções de compliance é enorme. Empresas europeias e globais precisarão demonstrar transparência em seus sistemas de IA classificados como alto risco, e a documentação técnica é obrigatória. A interpretabilidade de circuito prometia ser a ponte entre a caixa-preta dos modelos e as exigências regulatórias.
O problema, segundo o estudo, é que a descoberta de circuitos depende de escolhas analíticas que dois profissionais competentes podem fazer de forma diferente — e todas essas variações são defensáveis do ponto de vista metodológico.
Por que importa
O resultado mais significativo do estudo é que as inconsistências não são meramente semânticas. Os circuitos subjacentes às diferentes conclusões são estruturalmente quase disjuntos — o overlap mediano de Jaccard entre pares ficou em apenas 4%. Do ponto de vista funcional, a correlação é nula, com kappa de Cohen em 0,015. Ou seja: não se trata da mesma explicação descrita em palavras diferentes. São mecanismos distintos sendo identificados como relevantes, dependendo das configurações escolhidas.
O estudo também revelou que um dos sete objetivos de descoberta documentados na própria biblioteca analítica não executa na tarefa canônica da ferramenta — uma falha que levanta questões sobre maturidade técnica do ecossistema.
Para empresas brasileiras que operam ou exportam para o mercado europeu, o achado é relevante. Empresas que desenvolvem ou comercializam sistemas de IA classificados como alto risco pelo EU AI Act precisarão se preparar para exigências de documentação técnica. Se a ferramenta mais promissora para gerar essa documentação produz resultados instáveis, o caminho do compliance fica mais incerto.
Impacto
No curto prazo, o estudo pode atrasar a adoção da interpretabilidade mecânlica como padrão de mercado para compliance. Conformity assessment bodies — organismos responsáveis por verificar a conformidade dos sistemas — precisarão definir tolerâncias específicas, mas o estudo argumenta que nenhuma tolerância razoável seria suficiente para validar as evidências atuais.
No médio prazo, o resultado pode acelerar o desenvolvimento de abordagens complementares de documentação técnica. A dependência exclusiva de circuit discovery como fonte de evidência para o Annex IV do EU AI Act pode ser revista. O estudo propõe um protocolo independente — o filability criterion — como critério de referência para avaliar a estabilidade de explicabilidade.
O que muda
A pesquisa introduz o conceito de filability criterion como protocolo standalone: um conjunto de testes para verificar se evidências de explicabilidade sobrevivem a variações analíticas defensáveis. A proposta pode se tornar referência para a construção de benchmarks de explicabilidade no contexto regulatório.
O estudo também amplia o debate sobre quais ferramentas de explicabilidade são verdadeiramente prontas para uso regulatório. A interpretabilidade de circuitos continua sendo uma área promissora de pesquisa, mas a distância entre validade científica e adequação regulatória ficou mais evidente.
O que vem agora
Os próprios autores reconhecem limitações: o estudo cobriu um único modelo (GPT-2 small) e uma única tarefa (identificação de objeto indireto). Se as conclusões se sustentam em escala — modelos maiores, mais tarefas, mais arquiteturas — ainda é uma questão aberta.
O prazo de conformidade do EU AI Act se aproxima, e a Comissão Europeia ainda não se pronunciou oficialmente sobre qual nível de explicabilidade será considerado suficiente para documentação técnica. O estudo pode alimentar essa conversa e pressionar por critérios mais rigorosos — ou, alternativamente, revelar que a regulamentação avançou mais rápido do que a tecnologia de explicabilidade.
Fontes
- arXiv cs.AI — Explanation Multiplicity: Circuit-Level Interpretability Evidence Does Not Survive Defensible Analytic Variation (https://arxiv.org/abs/2608.13754)