
JPPO: ataque multimodal eleva latência de VLMs em até 36,6x
Estudo no arXiv descreve o JPPO, primeiro framework adversarial a otimizar imagem e prompt ao mesmo tempo
O que aconteceu
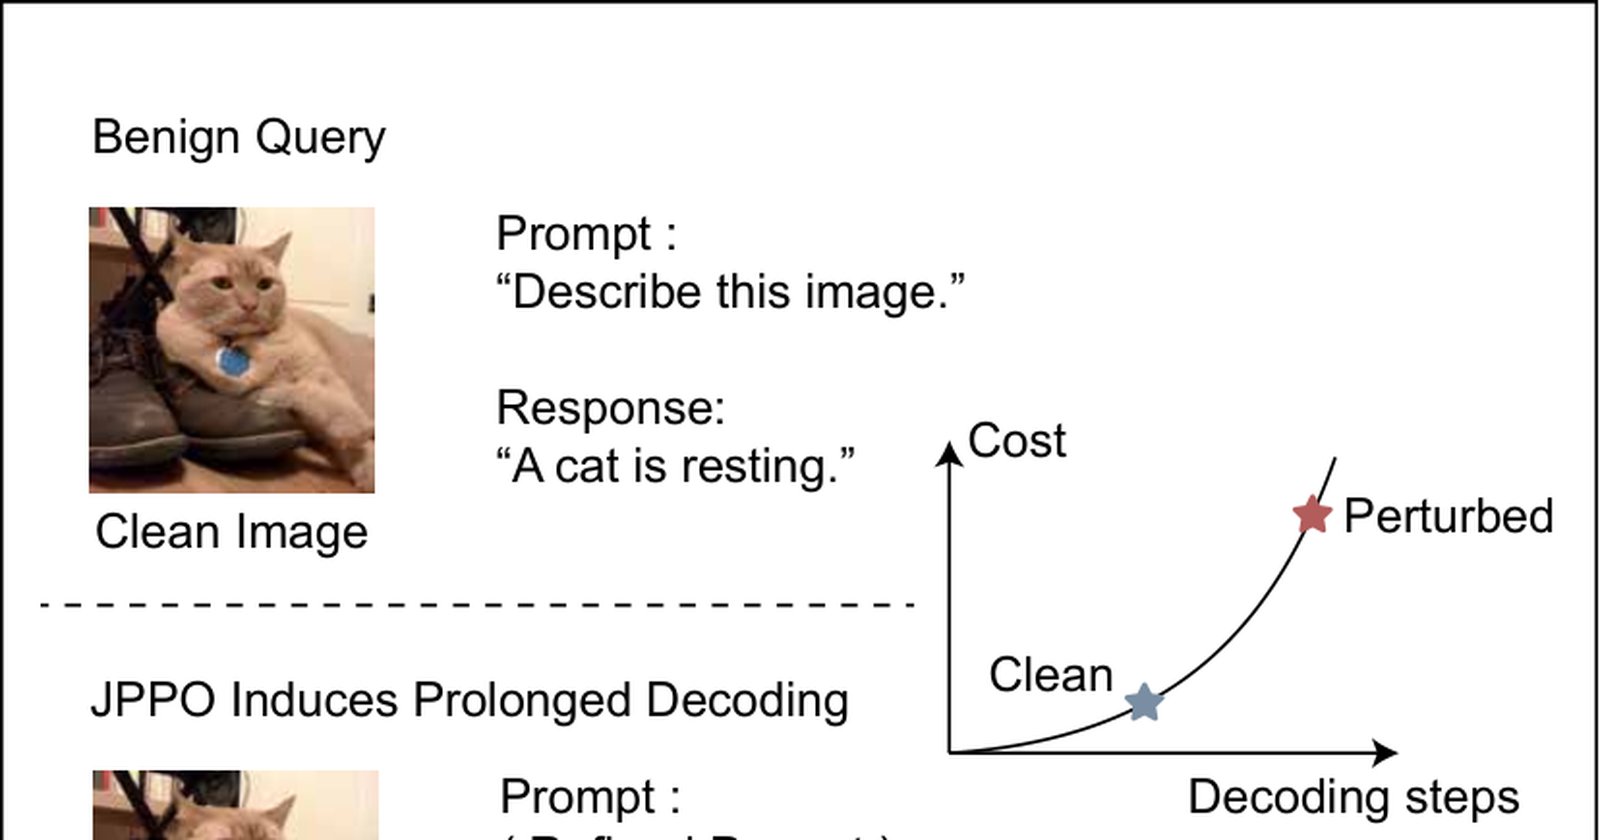
O artigo "Multimodal Resource-Exhaustion Attacks on Vision-Language Models via Joint Pixel-Prompt Optimization" foi submetido ao arXiv em 5 de setembro de 2026 e aparece no repositório sob o identificador arXiv:2609.05889v1, na categoria Computer Science > Artificial Intelligence. O trabalho propõe o JPPO, sigla de Joint Pixel-Prompt Optimization. O JPPO é descrito como o primeiro framework adversarial composto a tratar o prompt visível como variável adversarial de primeira classe, no mesmo patamar das perturbações aplicadas aos pixels da imagem.
A proposta, batizada de Joint Pixel-Prompt Optimization, opera sob um modelo de ameaça de entrada conjunta restrita e faz otimização acoplada e por estágios sobre as duas superfícies controláveis: pixels e prompt. Segundo o resumo, o resultado é uma amplificação de custo sinérgica, mecanicamente distinta de falhas dependentes de loop, com incidência de loop praticamente nula nos experimentos.
Os testes usaram cinco famílias de VLMs de código aberto, avaliadas nos conjuntos MS COCO e ImageNet, sob um orçamento de 8/255 na norma infinito. No Qwen2.5-VL-7B, o JPPO atingiu mais de 4,6 vezes de latência e 5,3 vezes de amplificação de energia. No BLIP-2, o mesmo método chegou a mais de 36,6 vezes de latência e 32,7 vezes de energia. O desempenho do JPPO ficou como a maior amplificação de custo entre as baselines comparadas diretamente, e com número substancialmente menor de iterações de otimização.
Contexto
Ataques de exaustão de recursos contra modelos de visão e linguagem autorregressivos costumam assumir modelos de ameaça unimodais. Nessa formulação, o ramo de imagem é a superfície primária de otimização, enquanto os prompts visíveis ao usuário permanecem fixos. Variantes recentes centradas em loop continuam presas a esse paradigma de canal único.
O artigo argumenta que esse recorte deixa em aberto a exploração da disponibilidade como um problema de otimização cross-modal sobre superfícies de entrada controláveis em conjunto. É nessa lacuna que o JPPO se posiciona. Em vez de otimizar só a imagem ou só o prompt, o framework descrito no arXiv:2609.05889v1 otimiza os dois de forma acoplada.
Por que importa
Os resultados apontam pontos cegos estruturais nas defesas atuais de serving de VLMs. Serviços que inspecionam apenas a imagem, ou que tratam o texto do usuário como entrada benigna e imutável, não cobrem a combinação descrita no estudo. As ablações do artigo indicam que a amplificação vem da coordenação multimodal, e não do comprimento do prompt nem de modalidades isoladas. Limitar o tamanho do prompt ou filtrar só a imagem não resolve o problema relatado pelos autores.
Impacto
Na prática, o custo de servir um modelo multimodal deixa de ser previsível a partir do tamanho da requisição. Uma entrada que parece pequena pode multiplicar tempo de resposta e consumo de energia. No BLIP-2, a latência medida passou de 36 vezes o valor normal, e a energia, de 32 vezes. No Qwen2.5-VL-7B, os fatores foram 4,6 vezes de latência e 5,3 vezes de energia. Para quem opera APIs de visão e linguagem, isso afeta capacidade de atendimento simultâneo, custo de nuvem e disponibilidade do serviço.
O que muda
O artigo defende que a avaliação de robustez ciente de custo passe a ser um requisito de segurança de primeira classe em implantações multimodais. Na prática, isso empurra a discussão de segurança de VLMs para além da acurácia e da recusa de conteúdo nocivo, entrando em consumo de recursos computacionais como métrica de risco.
O que vem agora
O texto foi submetido ao arXiv em 5 de setembro de 2026 e está disponível com PDF e versão HTML experimental. O material não informa prazos, correções ou revisões futuras. Os autores concluem que os achados motivam tratar custo como requisito de segurança, o que deve pautar avaliações de robustez de sistemas multimodais nos próximos ciclos de pesquisa.
Fontes
- arXiv: Multimodal Resource-Exhaustion Attacks on Vision-Language Models via Joint Pixel-Prompt Optimization (arXiv:2609.05889v1) https://arxiv.org/abs/2609.05889