
KnowSim: framework avalia como IAs calibram informações para usuários
Novo simulador com estados de conhecimento explícitos mede ganho, calibração e sobrecarga cognitiva.
O que aconteceu
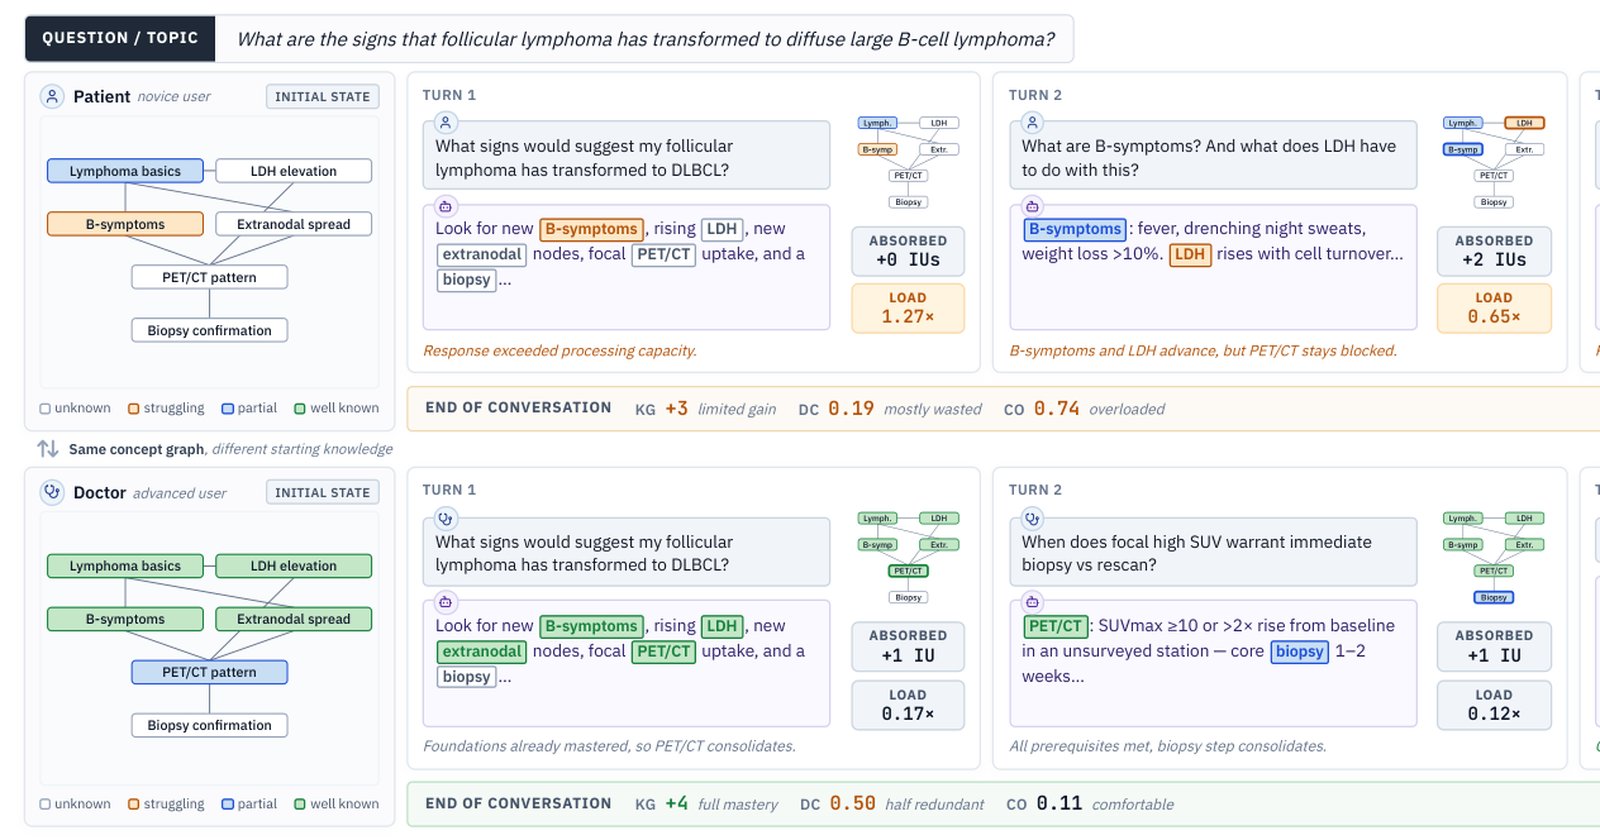
Pesquisadores introduziram o KnowSim, um framework de avaliação para LLMs focado em "calibração de informação": a capacidade da IA de ajustar o conteúdo que fornece ao conhecimento e à capacidade cognitiva do usuário. O sistema é baseado em um simulador de usuário que mantém estados de conhecimento explícitos, representados como um grafo de unidades de informação com relações de pré-requisito. Esses estados evoluem sob regras baseadas em teoria da aprendizagem.
O framework computa três métricas diretamente da trajetória do estado de conhecimento: Ganho de Conhecimento, Calibração de Entrega e Sobrecarga Cognitiva. Na validação, o KnowSim foi comparado com 705 sessões humanas em dois domínios, estratificadas por nível de conhecimento. Seus rankings alinharam significativamente com julgamentos humanos (73-74% de concordância de sinal), superando três simuladores baseline. Quando aplicado a nove LLMs, o framework revelou que o melhor modelo muda conforme o nível de conhecimento do usuário, evidenciando interações aptidão-tratamento invisíveis em avaliações padrão. A pesquisa foi submetida ao arXiv em 17 de agosto de 2026.
Contexto
Simuladores de usuário comuns para treinar e avaliar LLMs não modelam explicitamente o conhecimento. Por isso, não geram interações realistas entre diferentes níveis de conhecimento nem refletem como as interações evoluem à medida que esse conhecimento muda. Essa lacuna dificulta a criação de assistentes que colaborem de forma eficaz em tarefas baseadas em conhecimento, como educação ou suporte técnico, onde adaptar a explicação ao ouvinte é crucial.
Por que importa
A pesquisa aponta uma limitação fundamental em como avaliamos as IAs atuais. Se o melhor modelo para um iniciante não é o mesmo para um especialista, as empresas e desenvolvedores precisam de formas de teste que considerem o perfil do usuário final. Isso impacta diretamente o desenvolvimento de produtos de IA, sugerindo que uma abordagem "tamanho único" para avaliação é insuficiente. A calibração eficaz é um mecanismo central para a utilidade prática das LLMs em contextos reais.
Impacto
No curto prazo, o estudo fornece uma nova métrica objetiva para pesquisadores e engenheiros que desenvolvem assistentes conversacionais. No médio prazo, pode influenciar o direcionamento da pesquisa em IA, incentivando o foco em modelos que se adaptam dinamicamente ao perfil cognitivo do usuário, em vez de apenas maximizar acurácia em benchmarks gerais. Empresas que oferecem chatbots para atendimento ou educação terão um instrumento mais robusto para validar a eficácia de seus sistemas em diferentes públicos.
O que muda
A principal mudança é a introdução de um paradigma avaliativo centrado no estado do usuário e não apenas na resposta da IA. O KnowSim torna mensurável um aspecto da interação humano-IA que antes dependia de testes subjetivos com humanos. A revelação de que o ranking dos modelos varia por conhecimento do usuário força uma reavaliação de como os modelos são comparados e escolhidos para aplicações específicas.
O que vem agora
O próximo passo lógico é a adoção e iteração sobre o framework por outras equipes de pesquisa. Pode-se esperar a expansão para mais domínios de conhecimento e a integração de métricas do KnowSim em conjuntos de dados de avaliação públicos. A pesquisa também abre caminho para o desenvolvimento de LLMs treinados explicitamente para otimizar essas três métricas de calibração.