
KV cache em GPU, CPU ou SSD: estudo aponta limites do tiering
Simulador compara recency, reuse frequency, predicted reuse e EWMA em cargas de chat, agentes e perguntas sobre documentos
O que aconteceu
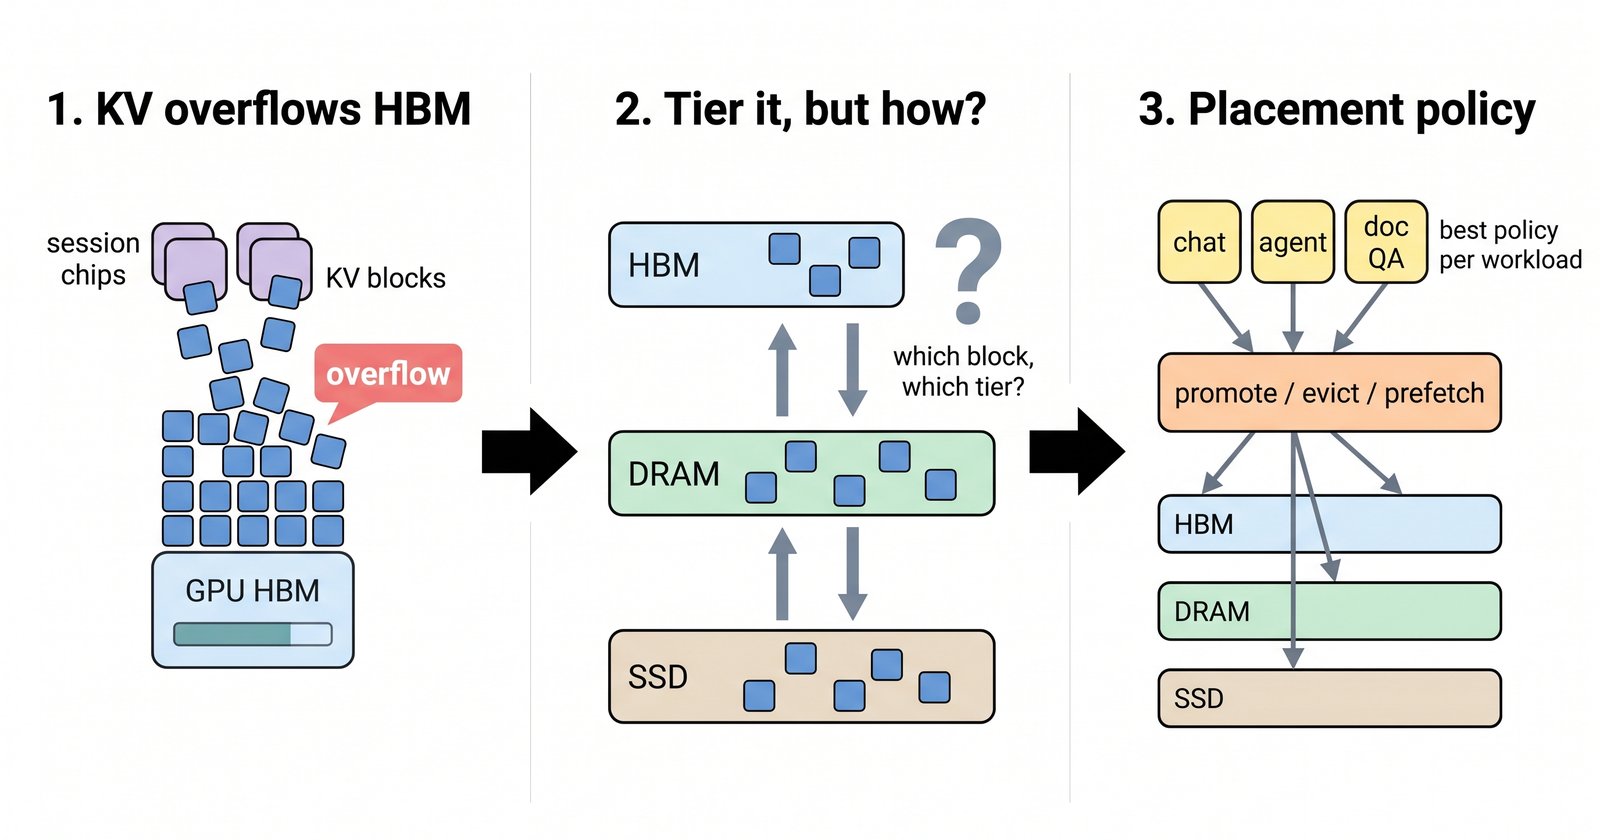
O artigo "Where Should the KV Cache Live? Placement Policies Across GPU, CPU, and SSD for Long-Lived Sessions", submetido ao arXiv em 14 de setembro de 2026 por Srikanta Datta Tumkur, investiga uma pergunta prática para quem serve modelos de linguagem em produção: quais blocos de KV cache devem ficar na memória HBM da GPU, quais vão para a DRAM da CPU e quais terminam no SSD.
O estudo usa um simulador de eventos discretos que cobre as três camadas, calibrado contra um preditor de tempo de execução baseado em random forest. Nele, os autores comparam quatro políticas de posicionamento (recency, reuse frequency, predicted reuse e um preditor EWMA com lookahead de prefetch) em três tipos de carga: chat, loops de agentes e perguntas e respostas sobre documentos.
O número que resume o resultado: o tiering suporta 73,02 vezes mais sessões concorrentes por GPU e derruba o custo por sessão em 62,04 vezes. Esses ganhos vêm das capacidades de camada de 1 mais 8 mais 64, e não da política de posicionamento. Ou seja, o benefício de separar o cache em GPU, CPU e SSD está na configuração do hardware, não no algoritmo que escolhe onde cada bloco mora.
O texto também derruba uma intuição comum. Com batch size 1, o decode é limitado por computação no ambiente estudado, então a colocação dos blocos quase não altera o throughput. O que a política muda de fato é o tráfego de migração pela PCIe e o tempo até o primeiro token.
Contexto
O problema que o artigo ataca é conhecido de quem opera inferência de LLM. A memória HBM da GPU é escassa e cara, e o KV cache consome boa parte dela conforme conversas, loops de agentes e sessões de perguntas sobre documentos acumulam estado. Sistemas como Mooncake, LMCache, FlexGen, InfiniGen e AttentionStore já estendem a memória da GPU com DRAM de CPU e SSD. O que esses sistemas não resolvem de forma definitiva é a parte mais difícil: decidir quais blocos pertencem a cada camada, quando movê-los ou descartá-los e se vale a pena fazer prefetch.
O novo estudo é justamente uma tentativa de responder a essas três perguntas com medição, em vez de heurística.
Por que importa
Para quem paga a conta de servir modelos, a diferença entre 1 e 73,02 sessões concorrentes por GPU é a diferença entre um serviço que escala e um que trava no custo. A queda de 62,04 vezes no custo por sessão tem efeito direto no preço de produtos de chat, de agentes autônomos e de busca sobre documentos internos.
A segunda conclusão é igualmente relevante para engenheiros: otimizar a política de posicionamento rende pouco em throughput quando o decode é limitado por computação. O esforço deve ir para o tráfego de PCIe e para o tempo até o primeiro token, os dois pontos que a política realmente afeta.
Impacto
Os resultados específicos por carga são úteis na prática. Em chat, a política de recency produz 2,30 vezes menos tráfego de migração do que reuse frequency. Em agentes e em perguntas sobre documentos, reuse frequency é a que se sai melhor. A política de predicted reuse, já existente, é byte idêntica a recency, o que significa que sua recomendação para o cenário de agentes é, na prática, a própria recency.
O preditor EWMA genuíno muda o comportamento do sistema, mas ainda fica atrás de reuse frequency exatamente nas cargas em que a predição deveria ajudar. E o prefetch não paga seu custo de banda: em toda a grade de políticas e tamanhos de cache, nem um oráculo com conhecimento das requisições futuras supera a opção sem prefetch em tráfego de migração.
O que muda
A conclusão central desloca o foco de quem projeta infraestrutura de inferência. Posicionamento específico por carga reduz movimentação de dados, o que é útil, mas as recomendações de predicted reuse e de prefetch não se sustentam como implementadas. O estudo sugere que vale mais investir no dimensionamento das camadas 1 mais 8 mais 64 do que em algoritmos sofisticados de predição de reuso.
O que vem agora
Não há, no material analisado, cronograma de implementação ou adoção por parte dos sistemas citados. O paper foi submetido em 14 de setembro de 2026 e está disponível publicamente no arXiv sob o identificador 2609.16215v1, no qual os autores detalham a metodologia do simulador de eventos discretos e a calibração do preditor de tempo de execução por random forest. O passo natural é que as equipes que mantêm Mooncake, LMCache, FlexGen, InfiniGen e AttentionStore testem essas conclusões em produção.
Fontes
- arXiv cs.AI: "Where Should the KV Cache Live? Placement Policies Across GPU, CPU, and SSD for Long-Lived Sessions" (arXiv:2609.16215v1), submetido em 14 de setembro de 2026. https://arxiv.org/abs/2609.16215