
KV compression é 1,2x a 2x mais barata que GPUs extras para LLM serving, mostra estudo arXiv
Estudo arXiv:2608.23962v1 compara cache reduzido versus mais GPUs e encontra vantagem da compressão em custo por milhão de tokens.
O que aconteceu
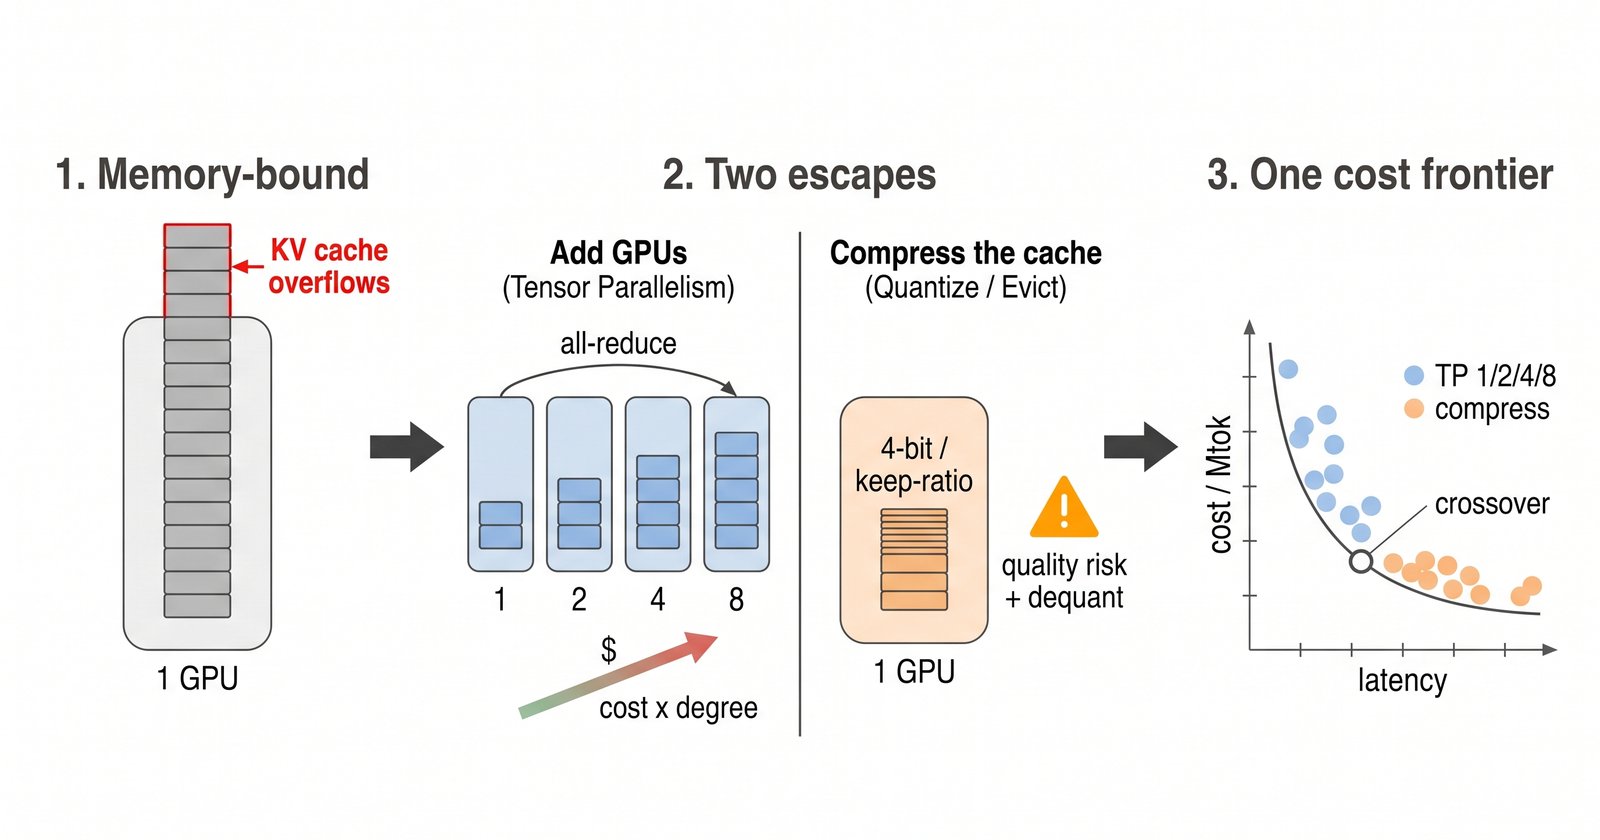
O artigo "More GPUs or a Smaller Cache? Tensor Parallelism versus KV Compression for Memory-Bound LLM Serving", submetido ao arXiv em 25 de agosto de 2026, coloca lado a lado duas soluções para o colapso de memória em servidores de LLM. A primeira, tensor parallelism, espalha pesos e cache KV por dois, quatro ou oito dispositivos, gastando hardware extra e pagando um all-reduce em cada camada. A segunda, KV compression, mantém tudo em uma única GPU usando quantização (16/8/4-bit) e eviction, com keep-ratios descendo a 0,25. Usando um simulador calibrado em A100, A40 e H100, os autores normalizam tudo no eixo custo por milhão de tokens contra latência e não encontram crossover de equivalência. A compressão sai mais barata em 1,20x a 2,00x em todas as configurações testadas.
Contexto
Quando uma implantação de serving de LLM esgota o espaço do cache KV, a comunidade de algoritmos costuma publicar taxas de compressão de memória, enquanto a comunidade de paralelismo publica curvas de throughput. Quase ninguém junta as duas em um mesmo eixo de custo. O estudo preenche essa lacuna ao mapear configurações de tensor parallelism (grau 1 a 8) e configurações de KV compression (16/8/4-bit, keep-ratios até 0,25) em um eixo normalizado de custo por milhão de tokens. A análise abrange dois modelos — Llama-2-7B e Llama-2-70B — e três GPUs: A100, A40 e H100.
Por que importa
A decisão entre comprar mais GPUs ou comprimir o cache afeta diretamente o CAPEX de qualquer operação de serving de LLM. O estudo mostra que, abaixo de um limite de 36 bilhões de parâmetros para uma GPU de 80 GB, a compressão domina e GPUs extras são gasto parcialmente desperdiçado. Acima desse limite, o tensor parallelism deixa de ser uma escolha e vira ingresso obrigatório: Llama-2-70B é inviável em uma única A100 em qualquer configuração de KV, porque o recurso limitante são os pesos, que a compressão de KV não toca. Em termos práticos, quem opera modelos grandes precisa de mais GPUs para caber os pesos, enquanto quem opera modelos menores deve preferir compressão.
Impacto
A compressão não apenas é mais barata — ela multiplica capacidade por dólar em 16,5x, contra 1,21x para um gasto oito vezes maior em GPUs. Mas a compressão tem um custo latente: a latência por token piora entre 8% e 93% por causa de contenção em batching. O tensor parallelism, por outro lado, é o único alavanca que reduz latência. Ou seja, a compressão vence em custo e capacidade, mas perde em velocidade; o tensor parallelism vence em velocidade, mas perde em custo.
O que muda
A conclusão central redefine o ponto de decisão. A fronteira entre as estratégias deixa de ser teórica e passa a ser prática: tamanho do modelo em relação à memória do dispositivo. Um modelo de 7B em uma GPU de 80 GB nem pode esgotar seu próprio orçamento de KV dentro da janela de contexto. Acima de 36B, o tensor parallelism vira requisito, não opção.
O que vem agora
O estudo foi submetido em 25 de agosto de 2026 e ainda não foi revisado por pares. Não há indicação de quando uma versão revisada será publicada. O código e os dados associados ao artigo estão disponíveis no arXiv, permitindo que equipes de serving repliquem a análise em suas próprias GPUs. O próximo passo esperado é validação empírica em clusters reais, especialmente com H100, onde a curva de preço por token pode mudar o balanço entre compressão e paralelismo.