
LACL-GUI: novo framework de aprendizado contrastivo para agentes de GUI
Framework proposto em artigo arXiv melhora estabilidade do treinamento de agentes de interface gráfica com sinais de qualidade de trajetória.
O que aconteceu
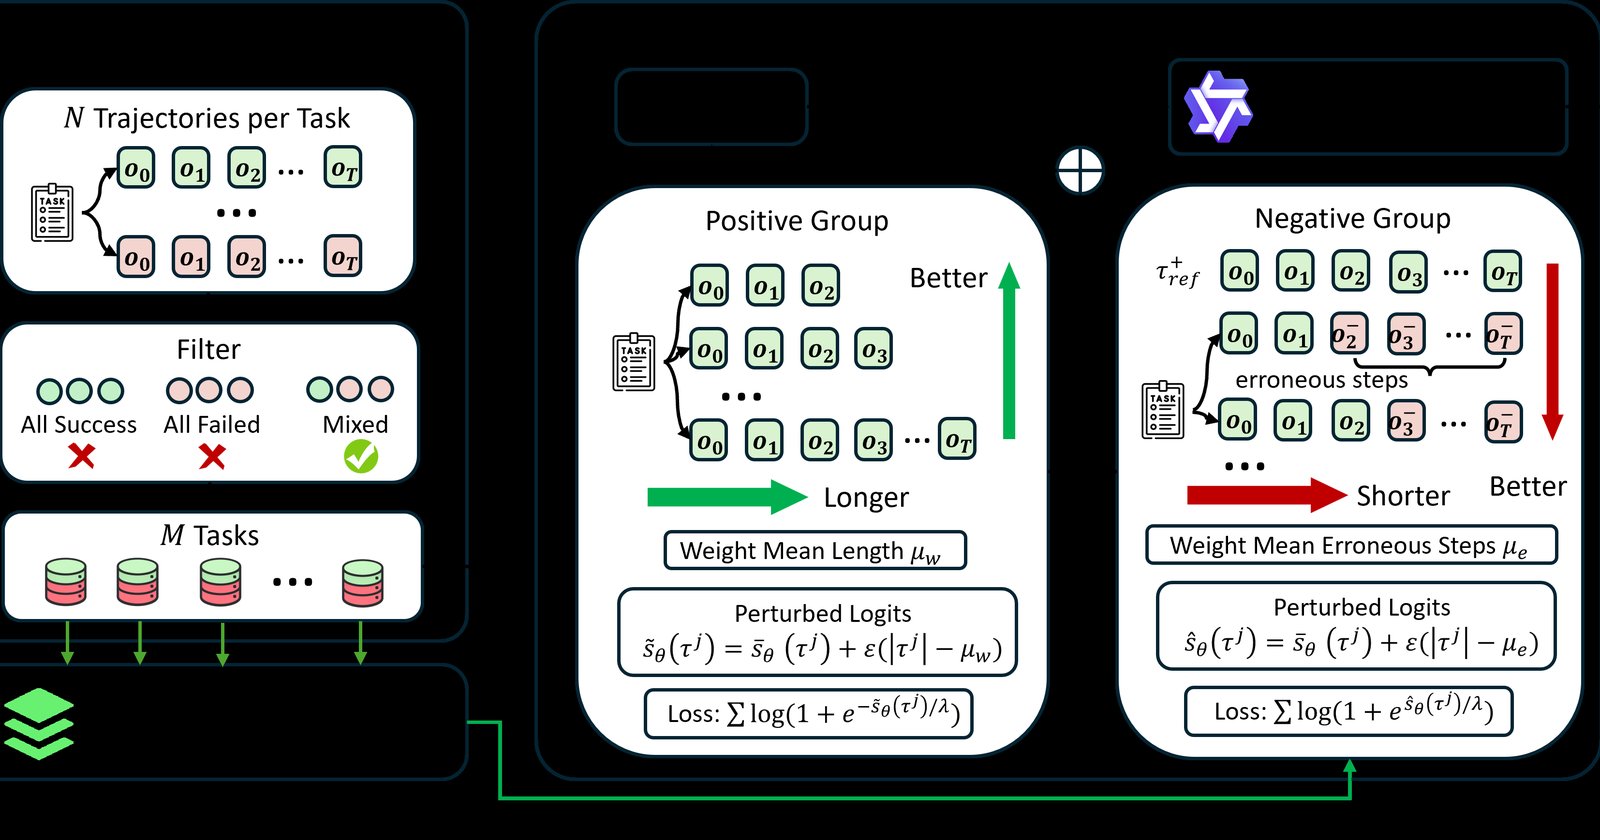
O artigo "Beyond Success and Failure: Length-Aware Contrastive Learning for GUI Agents" (arXiv:2608.21830) foi submetido em 22 de agosto de 2026 na categoria Computer Science > Artificial Intelligence. O trabalho apresenta o LACL-GUI (Length-Aware Contrastive Learning for GUI Agents), um framework de aprendizado por reforço com recompensas verificáveis (RLVR) que usa aprendizado contrastivo para treinar agentes de interface gráfica (GUI). O LACL-GUI foi proposto por pesquisadores que identificaram limitações em métodos como Group Relative Policy Optimization (GRPO), que sofrem de desalinhamento do gradiente de recompensa. Diferente das abordagens contrastivas anteriores, que dependem apenas do resultado final, o LACL-GUI incorpora sinais de qualidade de trajetória, distinguindo entre execuções bem-sucedidas e fracassadas com base no comprimento e na divergência em relação às trajetórias bem-sucedidas.
Nos experimentos, realizados em benchmarks de agentes GUI, o LACL-GUI forneceu sinais de aprendizado mais eficazes e melhorou consistentemente a performance em relação a métodos anteriores, segundo o resumo do artigo. O estudo destaca o valor da supervisão no nível de trajetória no contexto do aprendizado contrastivo RLVR.
O LACL-GUI, framework proposto no artigo arXiv:2608.21830, foi apresentado em agosto de 2026. O artigo arXiv:2608.21830 propõe o LACL-GUI, um framework de aprendizado contrastivo para agentes de GUI.
Contexto
Agentes de interface gráfica (GUI) alimentados por Modelos de Linguagem de Grande Escala Multimodais (MLLMs) têm mostrado potencial para automatizar tarefas em ambientes digitais. O aprendizado por reforço (RL) tornou-se o paradigma dominante para treinar esses agentes. No entanto, métodos amplamente usados como o Group Relative Policy Optimization (GRPO) sofrem de recompensa-gradiente desalinhada, o que leva a uma otimização ineficiente e instável. Para contornar isso, trabalhos recentes reformularam o RL com recompensas verificáveis (RLVR) como objetivos contrastivos ou baseados em classificação, eliminando comportamentos problemáticos de gradiente. Apesar desses avanços, os métodos contrastivos existentes dependem principalmente de supervisão no nível de resultado, sem capturar diferenças finas na qualidade da trajetória dentro da mesma categoria de resultado. O LACL-GUI ataca exatamente essa lacuna.
Por que importa
Para desenvolvedores de automação e agentes inteligentes, o LACL-GUI oferece uma forma mais estável e eficiente de treinar modelos que executam tarefas em interfaces gráficas. A capacidade de distinguir entre trajetórias bem-sucedidas concisas e executar ações mais longas pode reduzir o custo computacional e melhorar a precisão em tarefas complexas. Para o mercado de IA, isso representa um avanço na otimização de políticas de aprendizado por reforço, um gargalo conhecido na área. O artigo sugere que a supervisão no nível de trajetória é um ingrediente valioso para o aprendizado contrastivo RLVR, o que pode influenciar futuras pesquisas em treinamento de agentes.
Impacto
No curto prazo, o framework pode ser aplicado a benchmarks de GUI existentes, melhorando a performance de agentes em tarefas como navegação em interfaces e execução de comandos. No médio prazo, pode influenciar o desenvolvimento de técnicas de RLVR mais refinadas, que considerem não apenas o resultado final, mas também a qualidade do processo. Isso é particularmente relevante para setores que dependem de automação de processos, como testes de software, assistentes virtuais e robótica. Além disso, o foco em concisão pode reduzir o número de etapas necessárias para concluir tarefas, economizando recursos computacionais.
O que muda
A abordagem do LACL-GUI muda o tratamento binário de sucesso e fracasso no aprendizado por reforço. Em vez de apenas classificar trajetórias como bem-sucedidas ou fracassadas, o framework introduz preferências estruturadas dentro das trajetórias bem-sucedidas, incentivando execuções concisas, e diferencia a qualidade do fracasso com base na divergência em relação às trajetórias de sucesso. Isso preserva a estabilidade da otimização enquanto fornece sinais mais granulares para o treinamento. Na prática, o modelo aprende não apenas o que resultou em sucesso, mas também quais passos são desnecessários ou divergentes.
O que vem agora
Os autores não divulgaram detalhes sobre a liberação do código ou próximas etapas. O artigo está disponível no arXiv (https://arxiv.org/abs/2608.21830), e espera-se que a comunidade explore o framework em uma gama maior de benchmarks e o combine com outras técnicas de otimização. Versões futuras do trabalho podem incluir análises mais aprofundadas de eficiência computacional e comparações com métodos mais recentes de RLVR.