
LexAgentHallu: benchmark mede alucinações de agentes jurídicos de IA
Novo benchmark da arXiv mapeia como erros de ferramenta e raciocínio viram precedentes fabricados em agentes jurídicos
O que aconteceu
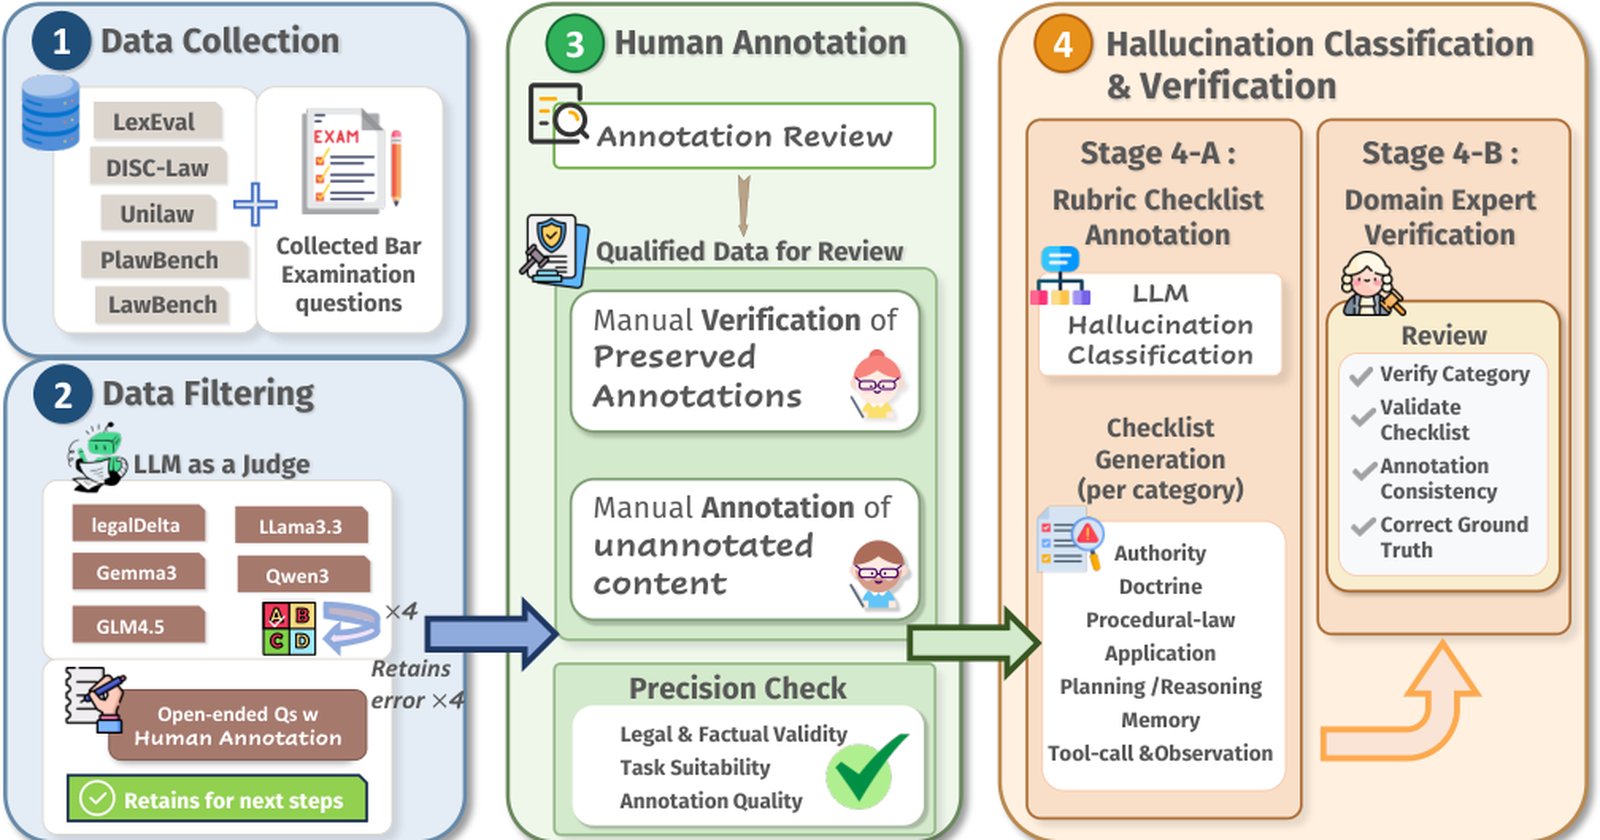
O LexAgentHallu foi submetido ao arXiv em 9 de setembro de 2026 e está identificado como arXiv:2609.09754v1, na área de Inteligência Artificial. O benchmark, chamado LexAgentHallu, foi construído para avaliar em que extensão e de que maneira agentes jurídicos falham ao longo de trajetórias de múltiplos passos, e não apenas no resultado final de uma resposta.
O conjunto reúne 3.414 instâncias distribuídas em 17 categorias jurídicas e 6 tipos de tarefa. A construção passou por um pipeline de quatro estágios com especialistas no circuito, o chamado expert-in-the-loop. Cada instância recebeu anotação sob uma taxonomia de alucinação em duas camadas: 7 categorias de alto nível e 27 subclasses detalhadas.
A taxonomia cobre dois tipos de falha. De um lado, erros substantivos, ligados ao conteúdo jurídico produzido. De outro, falhas de procedimento do próprio agente, ou seja, problemas no modo como ele executa a tarefa.
Os autores também desenharam métricas detalhadas que quantificam a extensão de cada falha e localizam onde ela ocorre no caminho de execução do agente. A avaliação do LexAgentHallu cobriu 18 agentes, somando modelos proprietários e de código aberto.
Contexto
O ponto de partida do estudo é um problema específico da IA aplicada ao Direito. Modelos de linguagem de grande porte têm sido cada vez mais usados como agentes jurídicos aumentados por ferramentas, capazes de consultar bases, chamar APIs e encadear etapas de raciocínio. Esse formato introduz o que o artigo chama de alucinação agêntica: erros de chamada de ferramenta e de raciocínio que se propagam em cascata e terminam em precedentes fabricados e autoridade jurídica citada de forma errada.
Os benchmarks jurídicos que já existiam avaliam apenas perguntas e respostas de turno único, com métricas de resultado. Já os benchmarks de alucinação agêntica não têm capacidade diagnóstica específica para o Direito. Segundo o artigo, nenhum dos dois responde em que medida e como um agente jurídico alucina ao longo de sua trajetória. É essa lacuna que o LexAgentHallu pretende fechar.
Por que importa
A avaliação dos 18 agentes revelou um efeito que os autores batizaram de Right-Answer-Wrong-Reason, algo como resposta certa por raciocínio errado. O agente chega à conclusão correta, mas o caminho percorrido até ela contém erros. Para uma métrica de resultado, esse agente passa. Para quem depende da fundamentação jurídica, ele não serve.
O segundo achado é que as subclasses de alucinação se agrupam em vez de se espalharem de forma aleatória. Elas formam perfis distintos conforme o framework agêntico, o tipo de tarefa jurídica e a categoria do caso. Isso significa que determinados arranjos de agentes falham de maneiras previsíveis, e não de forma caótica.
Na prática, quem ganha com esse tipo de diagnóstico são escritórios de advocacia, departamentos jurídicos, tribunais e fornecedores de software legal que precisam decidir se podem confiar em um agente. Quem perde é a lógica de avaliar modelos jurídicos apenas pelo acerto final, que o artigo mostra ser insuficiente.
Impacto
O impacto mais direto está na forma de medir. As métricas do LexAgentHallu localizam onde, no caminho de execução, cada falha acontece. Isso permite separar um erro de chamada de ferramenta de um erro de raciocínio jurídico, algo que a avaliação por resultado não distingue.
Os perfis por framework, tarefa e categoria também abrem espaço para comparações mais justas entre agentes. Em vez de perguntar apenas qual modelo acerta mais, passa a ser possível perguntar qual modelo erra menos em cada tipo de tarefa jurídica e de que maneira esses erros aparecem.
Os autores afirmam que os achados são invisíveis para a avaliação por resultado e que isso valida o poder diagnóstico do LexAgentHallu na avaliação de alucinação agêntica no Direito.
O que muda
A mudança central é de unidade de análise. Sai o resultado final isolado e entra a trajetória completa do agente, com suas chamadas de ferramenta, etapas de raciocínio e pontos de quebra. A taxonomia de 7 categorias e 27 subclasses dá vocabulário comum para nomear essas falhas, e as 3.414 instâncias em 17 categorias jurídicas e 6 tipos de tarefa oferecem base para testes repetíveis.
O que vem agora
O material disponível não indica prazos nem planos de expansão do LexAgentHallu. O que está publicado é o benchmark, sua taxonomia de duas camadas e as métricas de diagnóstico, com os resultados obtidos nos 18 agentes proprietários e de código aberto avaliados. O artigo está no arXiv sob o identificador 2609.09754v1.
Fontes
- arXiv cs.AI: LexAgentHallu: A Hierarchical Benchmark for Profiling Hallucinations in Legal Agents (https://arxiv.org/abs/2609.09754)