
Limpeza de Dados com IA: Estudo Revela Trade-offs entre Capacidades
Mais capacidades para agentes não garantem melhor desempenho, aponta paper do arXiv.
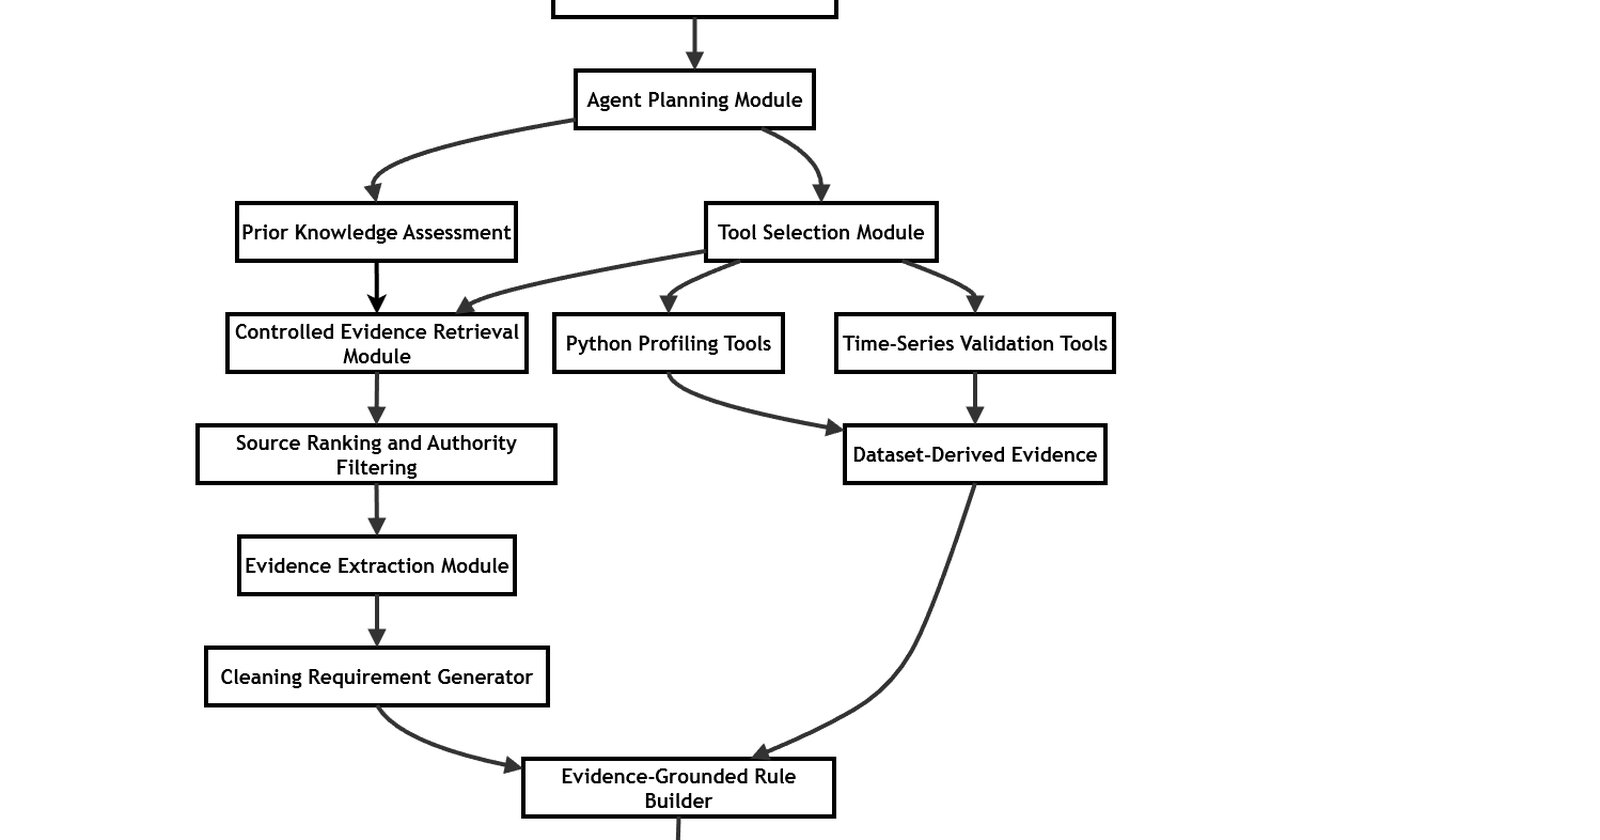
O que aconteceu
O paper "Agentic Data Cleaning Without a Clean Reference: An Experimental Study of Capabilities and Trade-offs" (arXiv:2608.14765v1) apresenta um estudo experimental. O objetivo era entender como diferentes configurações de agentes de IA lidam com a limpeza de dados quando não existe um "gabarito" confiável para comparação. Foram avaliadas sete configurações em 126 execuções, usando conjuntos de dados financeiros, clínicos e de monitoramento ambiental.
O resultado central é que nenhuma configuração se destacou em todos os critérios. A configuração com perfilamento determinístico, uma linha de base sem LLM, alcançou o maior F1-score de detecção (0.561). Entre as que usam LLM, a "configuração conservadora completa" atingiu o melhor F1-score (0.421), mas não fez reparos diretos. O estudo observou compromissos entre detecção, reparo, custo operacional e reprodutibilidade.
Contexto
Limpar dados sem uma versão "limpa" de referência é um problema comum em ciência de dados. Valores incomuns podem ser erros ou observações válidas. Tradição em limpeza de dados recai sobre regras determinísticas ou revisão manual. Este estudo explora uma abordagem "agentic": usar agentes de IA, como LLMs, combinados com ferramentas executáveis, para tomar decisões mais complexas.
A proposta do paper é um framework que inclui raciocínio de LLM, recuperação de evidências controlada, alinhamento com citações e reparo conservador. A pesquisa busca mapear o que funciona e onde estão os limites práticos dessas abordagens mais sofisticadas.
Por que importa
A descoberta tem implicações práticas para qualquer organização que depende de dados confiáveis. O estudo mostra que simplesmente "ligar mais funcionalidades" em um agente de IA não é a solução. Existe um custo operacional e uma complexidade que precisam ser gerenciados.
Para times de dados e engenheiros de machine learning, a mensagem é clara: a escolha da configuração do agente deve ser guiada pelo critério de negócio (prioridade é detecção? segurança? custo?), e não por supor que "mais inteligente" é sempre melhor. A pesquisa oferece um método empírico para avaliar esses trade-offs antes de implementação em escala.
Impacto
A curto prazo, o estudo desacelera a corrida por agentes de IA cada vez mais complexos para tarefas operacionais como limpeza de dados. Ele empodera equipes a fazerem perguntas mais diretas sobre custo-benefício.
No médio prazo, pode influenciar o desenvolvimento de ferramentas de dados. Em vez de focar apenas na capacidade de raciocínio dos LLMs, desenvolvedores podem priorizar a integração equilibrada de ferramentas de perfilamento e verificações executáveis, que mostraram ser eficazes por si só. A ênfase em "reparo conservador" e "scripts reversíveis" também reforça a necessidade de segurança e auditoria em pipelines de dados, especialmente em setores regulados como o financeiro e o de saúde.
O que vem agora
O framework e a metodologia empírica propostos no paper ficam disponíveis. Isso permite que outras equipes de pesquisa e empresas apliquem a mesma bateria de testes (126 runs com dados sintéticos e reais) para avaliar seus próprios sistemas de limpeza de dados.
A pesquisa abre caminho para estudos futuros sobre como equilibrar os trade-offs de forma mais dinâmica, talvez com agentes que ajustem sua própria complexidade com base no custo ou no nível de confiança exigido. A área de "data cleaning" com IA segue em evolução, mas agora com um mapa mais claro dos limites e das compensações.