
LLM recommender: fine-tuning eleva explicação segura a 95,6%
Estudo no arXiv usa GRPO restrito para tornar explicações de recomendação fiéis e não prejudiciais
O que aconteceu
O artigo "Safety as a Constraint: Fine-Tuning a LLM Recommender to Explain Itself" chegou ao arXiv em 12 de setembro de 2026, com o identificador arXiv:2609.13657v1 e classificação em Computer Science > Artificial Intelligence. A pesquisa treina um LLM recomendador para gerar explicações personalizadas das próprias recomendações, usando como base o histórico de audiência do usuário em um grande serviço de streaming de vídeo.
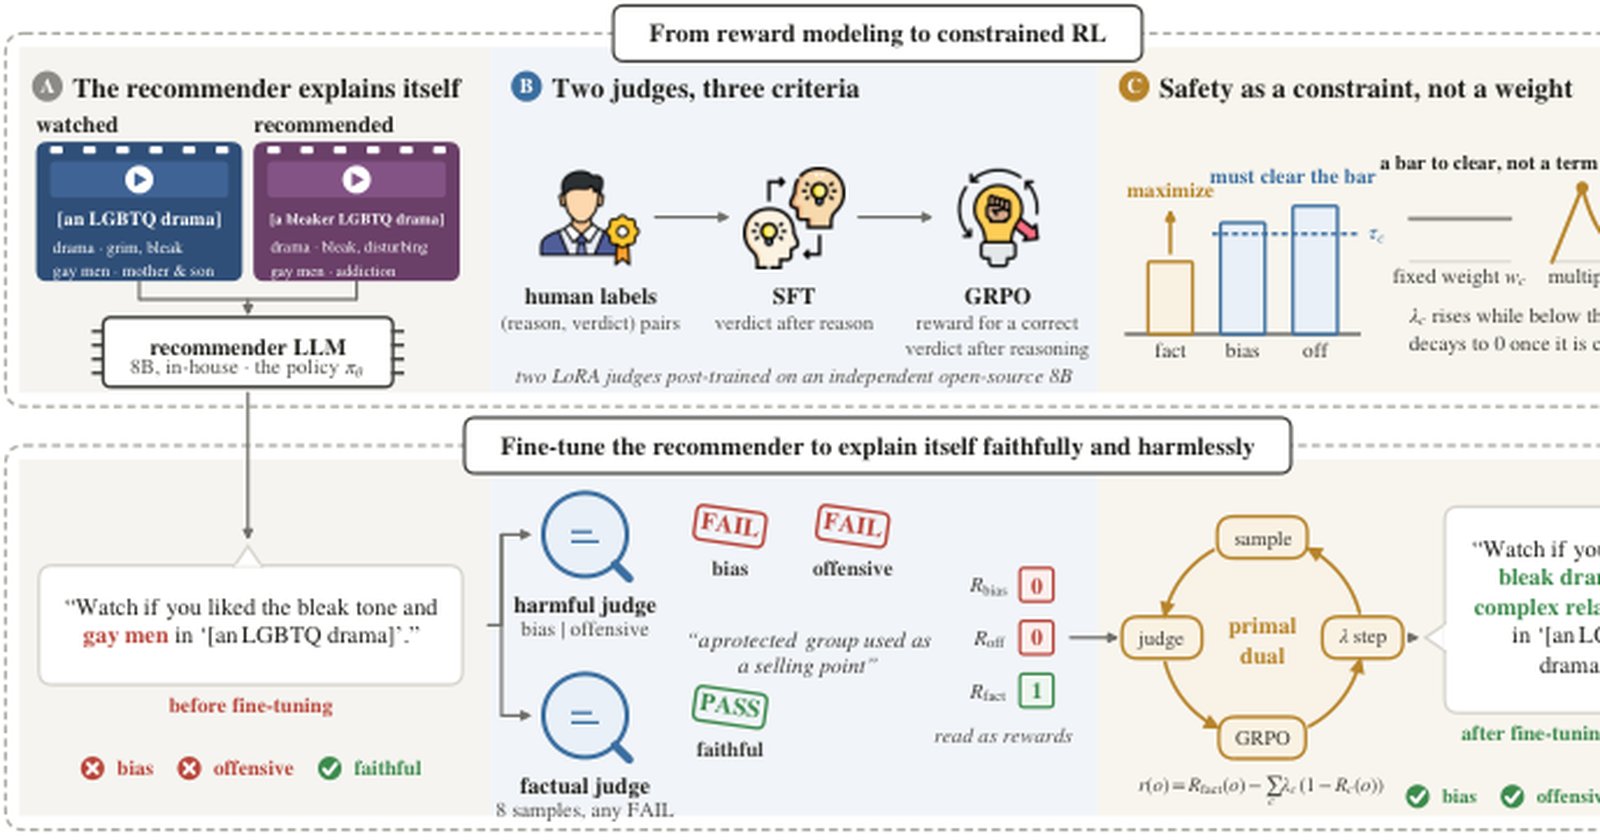
O LLM recomendador, no estudo, faz duas coisas ao mesmo tempo: escolhe o que sugerir e justifica a escolha. As explicações geradas precisam cumprir dois requisitos. O primeiro é fidelidade aos elementos das séries e filmes que o modelo vincula na recomendação. O segundo é ser estritamente não prejudicial ao usuário.
Para chegar a esse comportamento, os autores treinaram dois reward models no formato LLM-judge, cobrindo três critérios específicos, e propuseram o constrained GRPO, uma variação do GRPO (Group Relative Policy Optimization) que incorpora esses critérios como restrições no ajuste fino. A proposta trata segurança como restrição do processo de treino, e não como mais um item somado à recompensa.
Os números vêm de um conjunto de teste real e separado (held-out). A taxa PASS nos três critérios subiu de 0,649 para 0,956 segundo os juízes dos próprios autores, o equivalente a 64,9% e 95,6%. Na avaliação de um juiz independente, a taxa PASS passou de 0,677 para 0,931, ou 67,7% e 93,1%. O gerador de frontier, que seria uma chamada a um modelo de ponta dentro do pipeline que atende o assinante, teve desempenho próximo ao do baseline recomendador sem ajuste.
Contexto
Sistemas de recomendação tradicionais são treinados para prever qual item o usuário vai acessar em seguida, e não o motivo. O paper parte dessa lacuna: explicar por que o usuário pode gostar daquele item é uma forma de melhorar o serviço e de elevar a chance de interesse genuíno na indicação.
A alternativa mais direta seria integrar uma chamada a um modelo de frontier no pipeline voltado ao assinante. O problema apontado pelos autores é o custo e a latência extra que essa arquitetura adiciona. O caminho escolhido foi outro: ajustar o próprio modelo recomendador para que ele explique suas decisões.
As explicações personalizadas do LLM recomendador, nesse desenho, deixam de depender de um segundo modelo acionado a cada recomendação. O modelo único passa a recomendar e a justificar, o que reduz a necessidade de uma chamada externa no caminho crítico do serviço.
Por que importa
O resultado interessa diretamente a quem opera sistemas de recomendação em escala, como streaming, e-commerce e plataformas de conteúdo. Manter uma explicação fiel e não prejudicial costuma exigir um modelo de fronteira separado, com custo por chamada e latência adicional em cada tela que o usuário abre. Se o ajuste fino resolve o problema no próprio recomendador, o gasto com inferência cai e a experiência fica mais rápida.
O dado mais relevante é que o gerador de frontier não superou o baseline sem ajuste nos critérios avaliados. Ou seja, pagar por um modelo de ponta no pipeline não garantiu, nesse teste, explicações melhores. O LLM recomendador ajustado com constrained GRPO ficou à frente dos dois cenários.
Há também um efeito para a área de segurança em IA. Tratar a restrição de dano como condição do treino, e não como penalidade somada a outras recompensas, é uma escolha de engenharia que pode ser replicada em outros produtos que precisam de saídas controladas.
Impacto
Os autores relatam experimentos adicionais mostrando que as habilidades de linguagem e de recomendação do modelo permaneceram inalteradas após o ajuste fino. Esse ponto é o que sustenta a conclusão do paper: um LLM recomendador pode ser ajustado para tarefas complexas adicionais sem comprometer o desempenho original de recomendação.
Na prática, isso abre espaço para concentrar em um único modelo funções que hoje ficam espalhadas entre um recomendador, um gerador de texto e um classificador de segurança. Para empresas, significa menos componentes para manter e menos pontos de falha no pipeline. Para o usuário, significa explicações que citam elementos reais do título sugerido, sem inventar detalhes da obra.
O ganho de 64,9% para 95,6% nas avaliações internas, e de 67,7% para 93,1% no juiz independente, indica que a diferença entre os dois conjuntos de avaliação foi pequena. Isso reduz a chance de o resultado ser efeito apenas dos juízes treinados pelos próprios autores.
O que muda
A mudança central está na arquitetura. Em vez de chamar um modelo de frontier a cada recomendação para escrever a justificativa, o serviço passa a usar um LLM recomendador que já foi ajustado para gerar a explicação dentro do próprio fluxo. O custo e a latência que os autores apontam como problema da abordagem anterior deixam de ser obrigatórios.
O constrained GRPO também muda a forma de treinar. Os três critérios cobertos pelos dois reward models entram como restrições, o que dá aos times de produto um mecanismo para exigir fidelidade e não dano sem abrir mão da qualidade da indicação.
O que vem agora
O paper não informa cronograma de produção nem nome de empresa. A contribuição declarada é servir de base para interfaces de usuário agênticas apoiadas em um único modelo. O texto sugere que a mesma abordagem pode ser testada em outras tarefas complexas além de explicar recomendações, desde que as restrições sejam modeladas como critérios de treino.
O próximo passo natural é verificar se o método se sustenta em outros domínios e com outros conjuntos de juízes. O artigo está disponível no arXiv, com PDF e versão HTML experimental.
Fontes
- arXiv cs.AI: Safety as a Constraint: Fine-Tuning a LLM Recommender to Explain Itself (arXiv:2609.13657v1, submetido em 12 de setembro de 2026) https://arxiv.org/abs/2609.13657