
LLMs: estudo propõe estimar incerteza por ambiguidade sem gerar respostas
Paper no arXiv mostra que interpretar a pergunta basta para detectar ambiguidade, com custo até 26 vezes menor
O que aconteceu
O paper "From Answers to Interpretations: Rethinking Ambiguity-Induced Aleatoric Uncertainty Estimation in LLMs", registrado no arXiv sob o número 2609.04543v1 e submetido em 3 de setembro de 2026, ataca um problema central na implantação confiável de grandes modelos de linguagem (LLMs): distinguir quando a incerteza do modelo reflete uma variabilidade irreduzível da tarefa, e não uma lacuna de conhecimento.
Os autores identificam a ambiguidade ou subespecificação da entrada como a principal fonte dessa incerteza aleatórica (aleatoric uncertainty) em tarefas de linguagem. É o caso clássico de uma pergunta que admite múltiplas interpretações plausíveis.
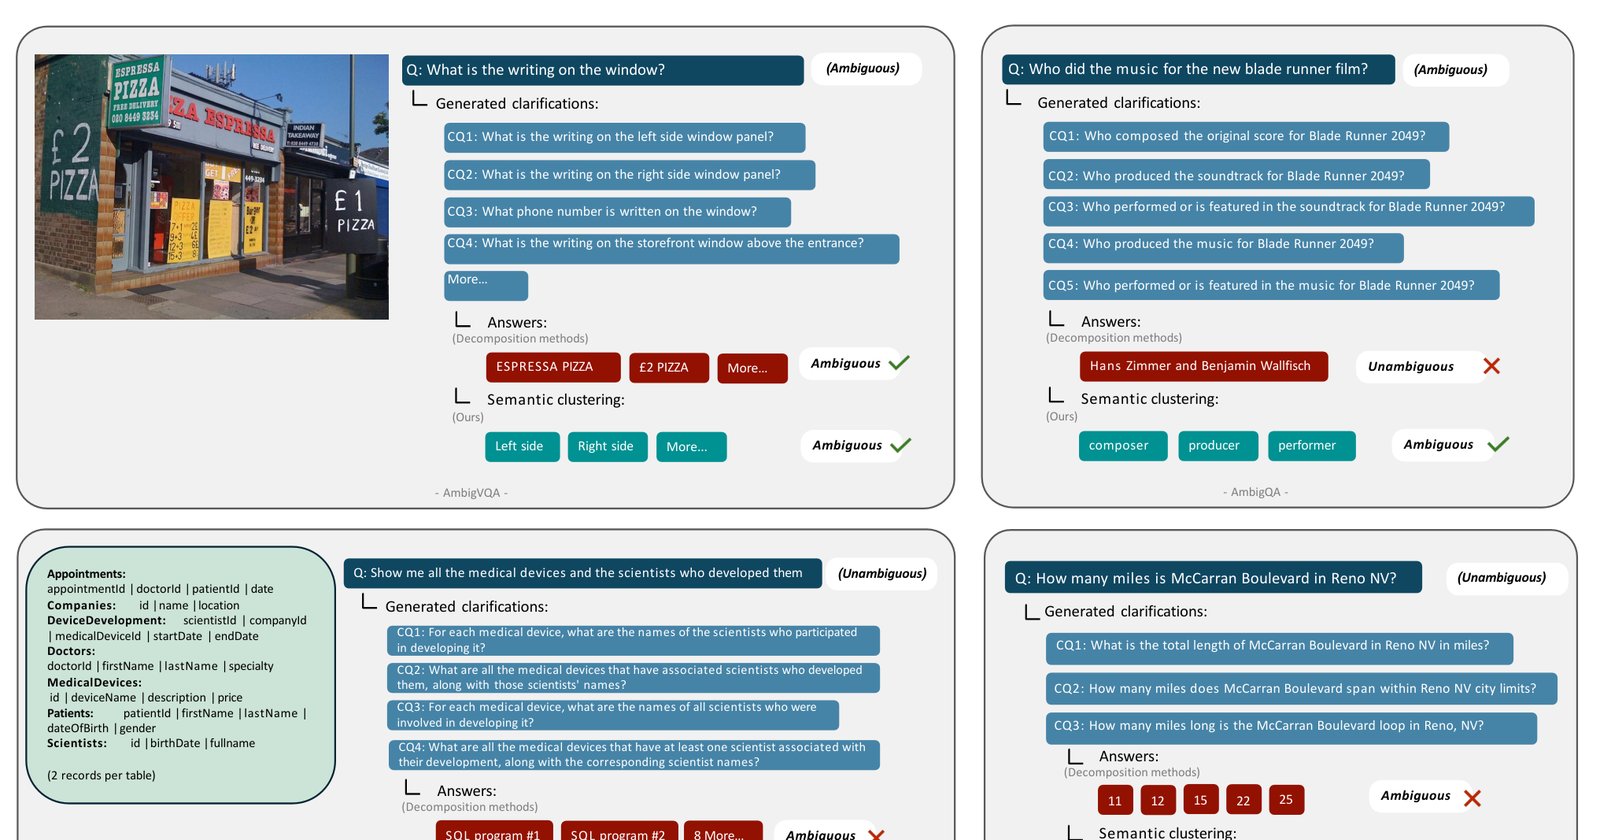
O método dominante até aqui funciona em três etapas: gerar várias clarificações da entrada ambígua, consultar o modelo para obter uma resposta sob cada clarificação e comparar as respostas resultantes. O paper argumenta que as respostas são desnecessárias. Segundo os autores, elas são frequentemente redundantes, adicionam custo evitável e podem induzir a erro por meio do que chamam de epistemic leakage, o vazamento de incerteza epistêmica (ligada às limitações do modelo) para dentro da medida que deveria capturar apenas a ambiguidade da tarefa.
Contexto
A distinção entre incerteza aleatórica e incerteza epistêmica é um tema consolidado na área de confiabilidade de IA. A aleatórica vem da variabilidade inerente ao problema. A epistêmica vem do que o modelo não sabe. Confundir as duas é caro: um sistema pode acreditar que a pergunta do usuário é ambígua quando, na verdade, o modelo é que carece de conhecimento, ou o contrário.
A abordagem de decomposição existente, baseada em respostas, exigia que o sistema gerasse clarificações e depois respondesse a cada uma delas. Isso multiplica chamadas de API e tokens de saída. O novo trabalho sustenta a tese contrária teoricamente e propõe uma abordagem somente por clarificação (clarification-only), que estima o componente de ambiguidade diretamente do espaço de interpretações plausíveis, sem gerar respostas para as entradas clarificadas.
Por que importa
Os números da avaliação operacional, feita por meio de detecção de ambiguidade em três benchmarks, mostram ganho em duas frentes ao mesmo tempo. O AUROC, métrica que mede a capacidade de discriminar casos ambíguos de não ambíguos, subiu de 60,85 no método tradicional para 63,34 na abordagem direta. Ou seja, o método mais barato também é mais preciso.
O custo caiu de 4 a 26 vezes em tokens de saída e de 2,2 a 3,5 vezes em chamadas de API. Para empresas que rodam pipelines de verificação de incerteza em produção, cada chamada evitada representa latência menor e fatura menor junto ao provedor do modelo.
Há ainda um ganho de qualidade estatística: as estimativas produzidas pelo novo método apresentam correlação substancialmente menor com a incerteza epistêmica. Isso significa menos contaminação entre os dois tipos de incerteza, exatamente o que a decomposição pretende evitar.
Impacto
No curto prazo, a conclusão do paper muda a arquitetura esperada de sistemas de detecção de ambiguidade. Em vez de um loop de clarificação e resposta, basta mapear o conjunto de interpretações plausíveis da entrada. O resultado sugere que a incerteza aleatória induzida por ambiguidade é melhor estimada a partir do espaço de interpretações do que do espaço de respostas, como concluem os próprios autores.
Para desenvolvedores brasileiros e times de dados que constroem assistentes e chatbots sobre APIs de LLMs, a redução de 2,2 a 3,5 vezes em chamadas de API é o dado mais acionável. Sistemas que hoje perguntam ao modelo "o usuário quis dizer X ou Y?" e depois respondem cada versão podem cortar essa segunda etapa inteira.
O que muda
A mudança conceitual é a mais duradoura. O paper estabelece que respostas não são necessárias para identificar ambiguidade, e oferece suporte teórico para essa afirmação, além dos resultados empíricos. Isso abre caminho para que trabalhos futuros tratem o espaço de interpretações como objeto de estudo próprio, e não como mero insumo para gerar respostas comparáveis.
O que vem agora
O trabalho está disponível no arXiv na versão 2609.04543v1, com PDF e HTML abertos, e passa pelo processo normal de visibilidade e citação da plataforma, com ferramentas como Connected Papers e scite já indexando o material. A submissão é de 3 de setembro de 2026. A validação em três benchmarks serve como avaliação operacional inicial; a adoção prática dependerá de réplicas independentes e de integração em frameworks de avaliação de LLMs, etapas naturais após a publicação de um preprint nesta área.