
LLMs julgam hipóteses científicas? Novo método supera LLM-as-judge
Pesquisa do arXiv mostra que confiança intrínseca do modelo é mais eficaz que comparação direta
O que aconteceu
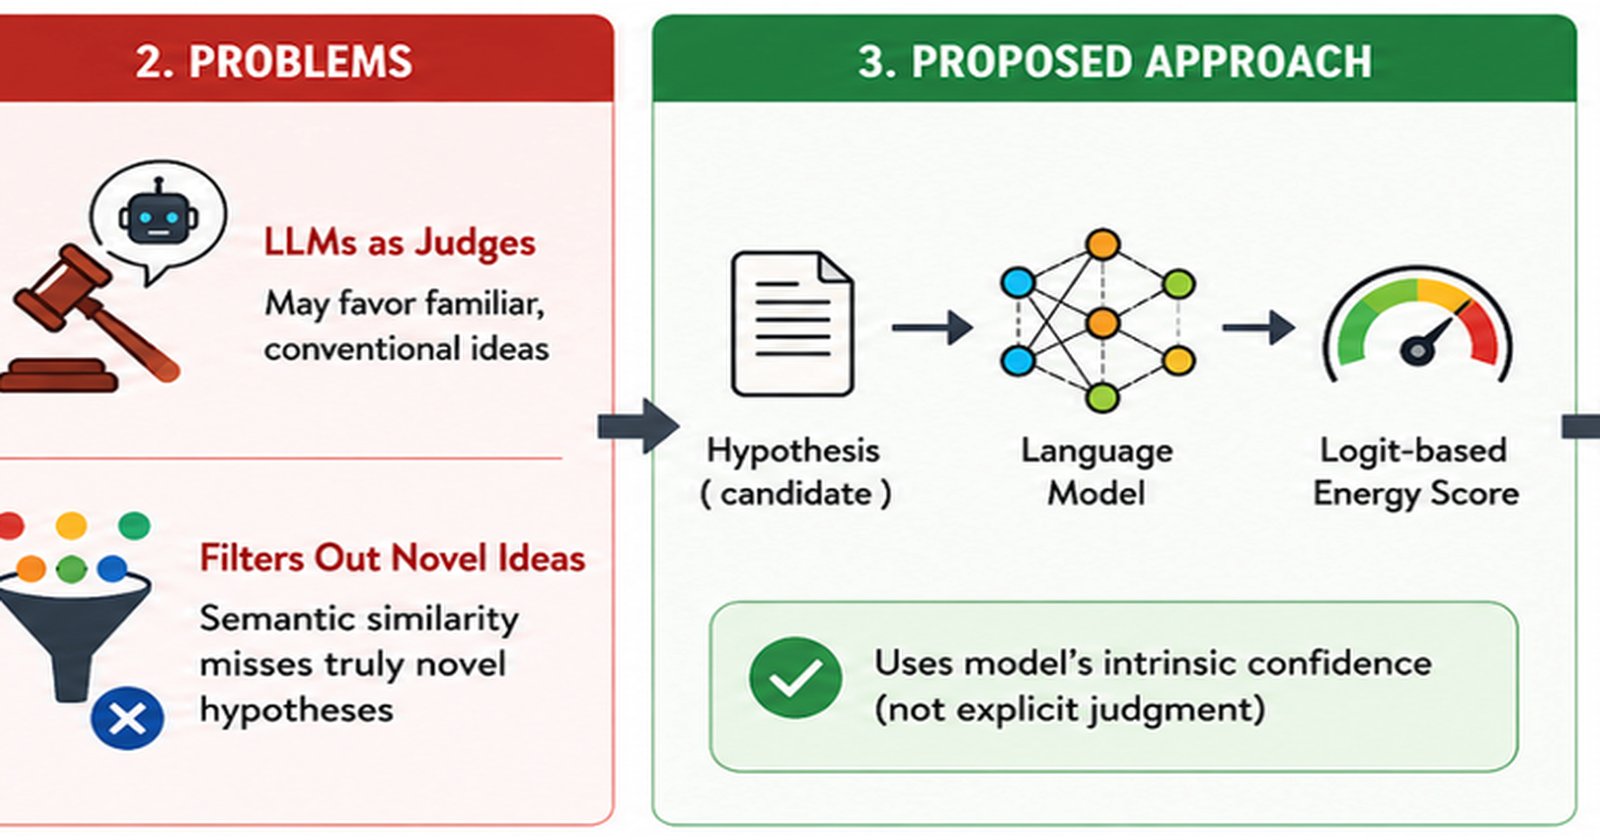
Pesquisadores submeteram ao arXiv (ID 2608.17270) um estudo que compara duas formas de avaliar hipóteses científicas geradas por grandes modelos de linguagem (LLMs). A abordagem proposta, chamada de logit-based energy scoring, usa a confiança interna do modelo — medida pelos logits da saída — em vez de pedir que o modelo compare hipóteses diretamente (LLM-as-judge). O benchmark envolveu sete modelos de linguagem, 1.323 artigos científicos de 12 disciplinas, cada um com sua hipótese real e 15 alternativas incorretas. O método intrínseco alcançou 33,0% de acerto no topo (Hit@1) quando os resultados foram agrupados, contra 16,6% da abordagem com prompt de ranking listwise. A melhor combinação — um modelo de 1 bilhão de parâmetros com o scoring por logits — chegou a 53,1%, embora esse número tenha sido o máximo entre 14 combinações modelo-avaliador selecionadas posteriormente (arXiv, 2026).
Contexto
LLMs são cada vez mais usados para gerar hipóteses científicas, mas avaliar a qualidade dessas hipóteses é um gargalo para fluxos de trabalho confiáveis. Métodos atuais dependem de LLMs como juízes ou de similaridade semântica, que tendem a favorecer ideias familiares em vez de inovadoras. O novo estudo propõe uma alternativa que não exige comparação explícita, apenas a probabilidade que o próprio modelo atribui à hipótese.
Por que importa
Para pesquisadores e empresas que usam IA para descoberta científica, a avaliação automática de hipóteses é crítica. O método logit-based pode reduzir o viés de familiaridade e oferecer uma métrica mais objetiva, sem depender de prompts complexos ou de modelos gigantes. A melhora de 16,6% para 33,0% no Hit@1 indica um avanço prático significativo.
Impacto
No curto prazo, laboratórios que usam LLMs para gerar hipóteses podem adotar o scoring por logits como uma camada de triagem antes da revisão humana. No médio prazo, a abordagem pode inspirar novos estudos sobre métodos baseados em confiança para IA científica confiável. A pesquisa também sinaliza que modelos menores (1B) podem competir com modelos maiores quando usados de forma mais inteligente.
O que muda
A principal mudança é a possibilidade de avaliar hipóteses sem depender de um "juiz" externo. Em vez de perguntar ao modelo qual hipótese é melhor, mede-se a energia intrínseca da resposta. Isso pode ser mais barato, mais rápido e menos sujeito a vieses de prompt.
O que vem agora
Os autores afirmam que o estudo motiva pesquisas futuras sobre métodos baseados em confiança para descoberta científica assistida por IA. Não há detalhes sobre a disponibilização de código ou datasets, mas a comunidade acadêmica deve explorar variações do método e testá-lo em mais disciplinas e modelos.