
LLMs mostram sensibilidade metacognitiva em raciocínio médico
Estudo com gpt-4.1-nano revela que a confiança do modelo acompanha a qualidade da evidência, mas falha em casos moderados de Alzheimer.
O que aconteceu
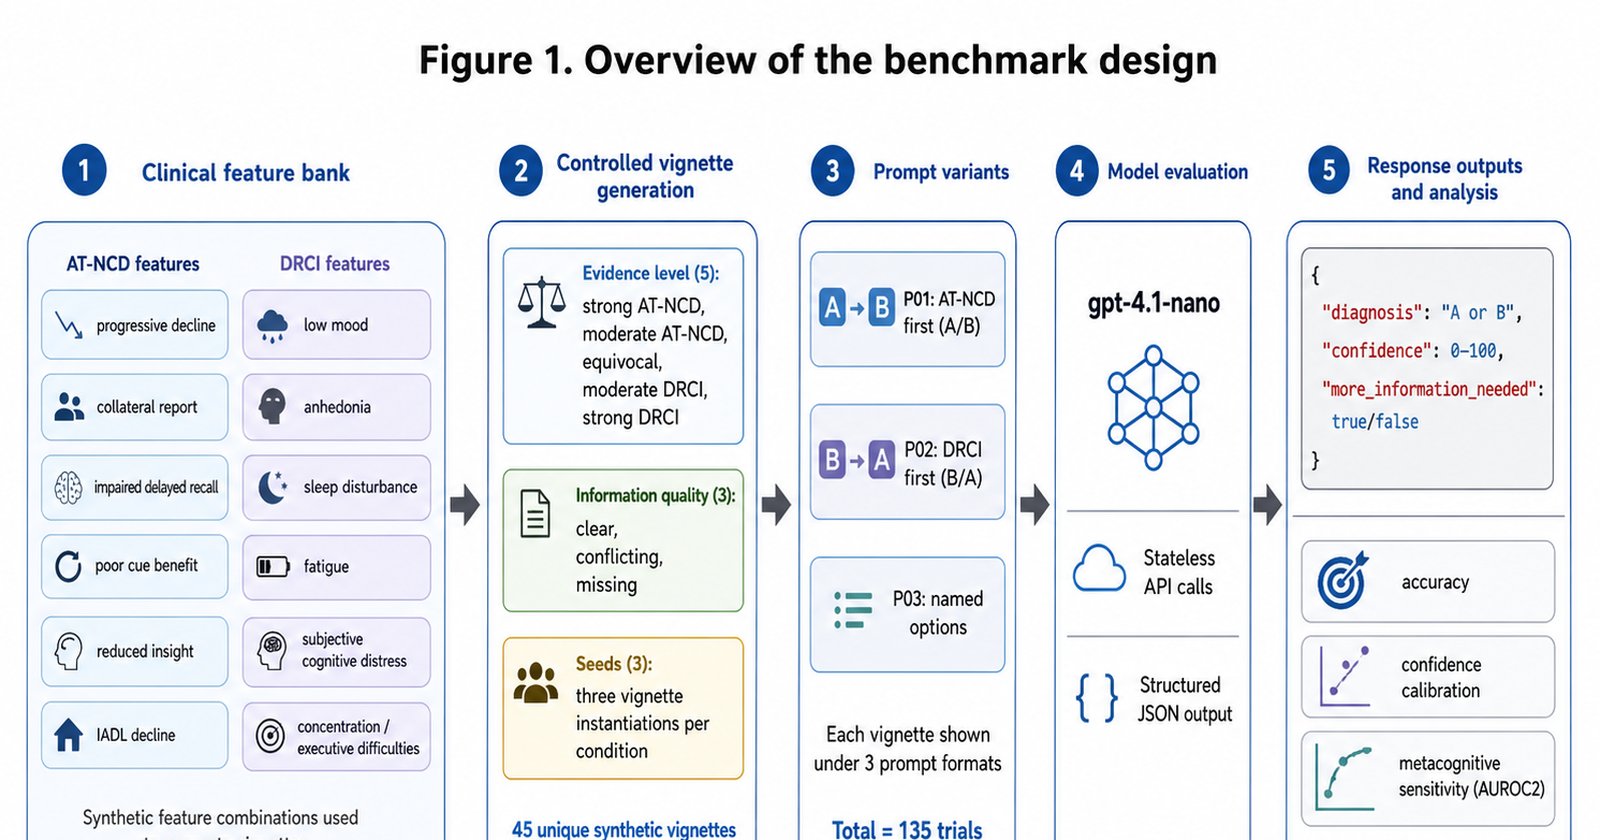
Um estudo submetido ao arXiv em 4 de maio de 2026 (arXiv:2608.14552) avaliou se um modelo de linguagem de grande porte (LLM) consegue ajustar sua confiança à qualidade das evidências em raciocínio clínico. Os pesquisadores criaram um benchmark inspirado em psicofísica, com 45 vinhetas clínicas sintéticas que variavam força de evidência, conflito e informações ausentes. Cada vinheta foi apresentada em três variações de prompt, totalizando 135 tentativas. No teste piloto com o gpt-4.1-nano, todas as saídas foram válidas. A acurácia diagnóstica foi de 93,5%, a confiança média de 78,4% e o AUROC2 de 0,876 (arXiv).
Contexto
LLMs estão sendo cada vez mais usados na medicina, mas a utilidade clínica depende não só da precisão das respostas, mas também de a confiança do modelo refletir a incerteza real. Estudos anteriores mostravam que modelos frequentemente exibem confiança superestimada. Este trabalho propõe uma estrutura controlada para medir diretamente a sensibilidade metacognitiva — ou seja, se a confiança acompanha a qualidade da evidência — em vez de inferi-la a partir da acurácia geral.
Por que importa
Para médicos e pacientes, um sistema que erra com alta confiança é mais perigoso do que um que erra com hesitação. O estudo mostra que o gpt-4.1-nano tem sensibilidade metacognitiva parcial: a confiança aumenta quando a evidência é mais forte, diminui quando há informação faltando e é maior em acertos do que em erros, mesmo após ajustes. Mas há um ponto crítico: em casos moderados de Alzheimer com evidências conflitantes, o modelo tende a diagnosticar depressão (DRCI) e mantém confiança maior do que a acurácia empírica justificaria.
Impacto
No curto prazo, o benchmark oferece um método reprodutível para avaliar calibração de confiança em LLMs médicos. No médio prazo, pode orientar o desenvolvimento de sistemas que sinalizem incerteza em cenários de alto risco. A falha localizada em casos de Alzheimer moderado sugere que a confiança não deve ser usada como proxy de qualidade diagnóstica em todas as situações — especialmente quando há comorbidades psiquiátricas.
O que muda
Ferramentas de apoio à decisão clínica que usam LLMs precisarão incorporar métricas de calibração de confiança, não apenas acurácia. O estudo também indica que a qualidade da confiança deve ser medida diretamente, e não inferida do desempenho geral do modelo. Para o mercado de healthtech, isso significa que a validação de modelos médicos precisa incluir testes de metacognição.
O que vem agora
Os pesquisadores planejam expandir o benchmark para outros modelos e cenários clínicos. A comparação entre modelos sugeriu que a qualidade da confiança varia independentemente da capacidade geral, o que pode levar a novos critérios de seleção de LLMs para uso médico. O framework está disponível para reprodução, permitindo que outros grupos validem seus próprios modelos.