
MaSCoD: framework multiagente guia descoberta causal com LLMs
Pesquisa propõe organizar contexto estrutural antes de julgar arestas causais diretas
O que aconteceu
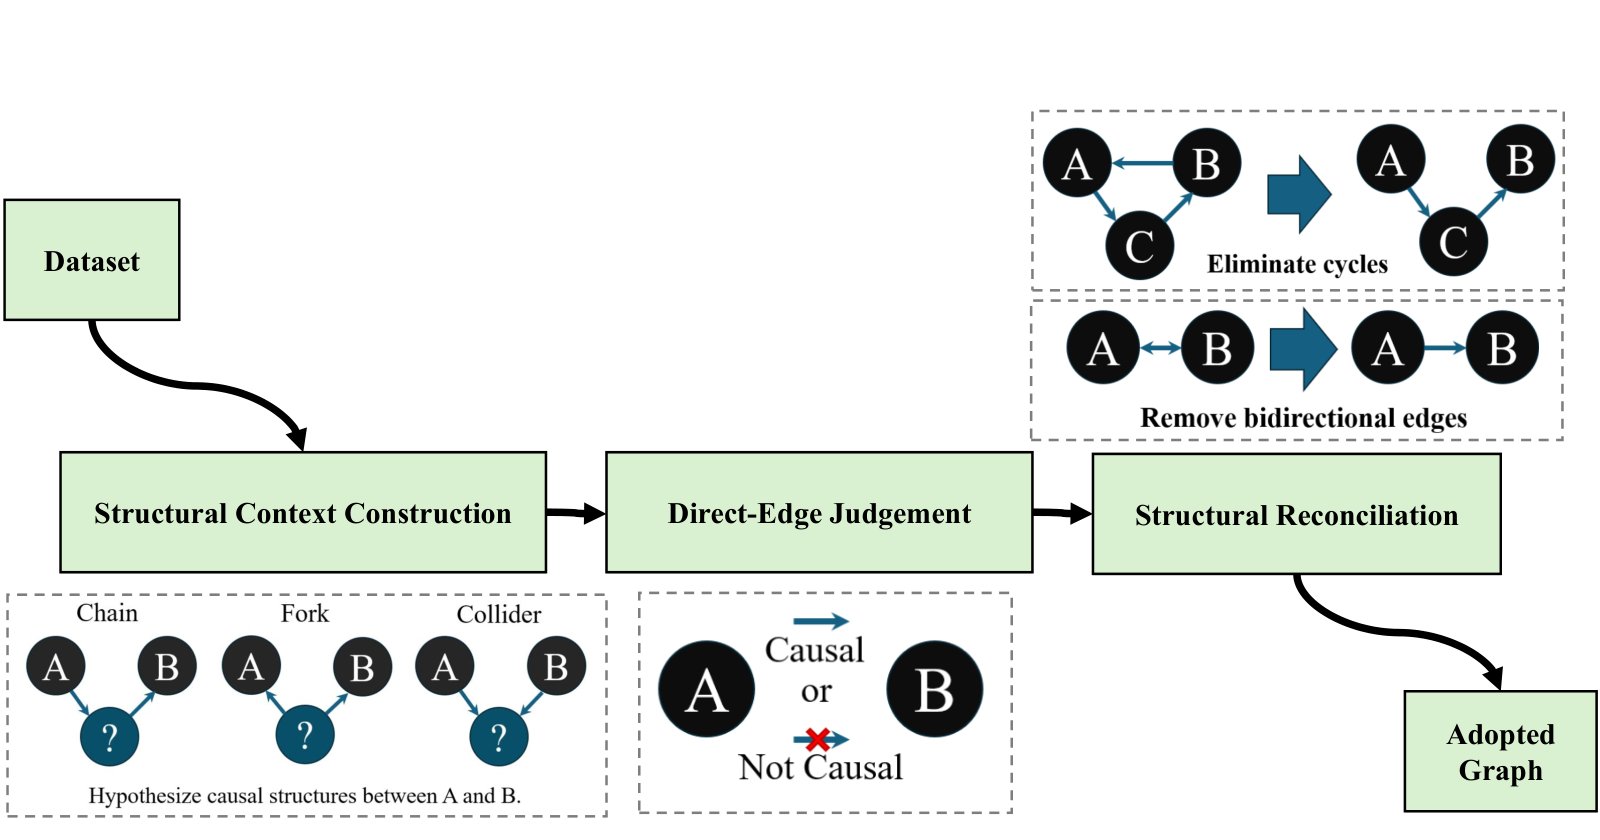
O arXiv publicou em 17 de setembro de 2026 o artigo MaSCoD: A Multi-Agent Framework for Structural-Context-Guided Candidate Causal Graph Generation, registrado como arXiv:2609.19944v1 na categoria cs.AI (arXiv). O MaSCoD é um framework multiagente que organiza variáveis terceiras candidatas e padrões estruturais locais antes de julgar arestas causais diretas.
O problema que o trabalho ataca é específico. Segundo os autores, modelos de linguagem de grande porte já vêm sendo aplicados à descoberta causal, mas a etapa de geração de grafo candidato raramente trata a omissão prematura de relações causais potencialmente relevantes como um objetivo explícito de design. A geração de grafo candidato é a fase em que o sistema levanta quais relações entre variáveis merecem ser consideradas, antes de qualquer veredito final sobre existir ou não uma aresta causal.
A avaliação usou três conjuntos de dados, Auto-MPG, DWD e Sachs, e dois backbones. O GPT-5.4, modelo da OpenAI, foi o backbone principal, e o GPT-4o, também da OpenAI, serviu para replicação. Isso resultou em seis configurações de dataset mais backbone.
O achado central é comparativo. Denominada Full, a variante que fornece hipóteses estruturais antes do julgamento de aresta direta alcançou Recall médio e F1 maiores do que a variante No Phase 1, que constrói essas hipóteses dentro do próprio procedimento de julgamento, em todas as seis configurações avaliadas. A variante Full, porém, também elevou as taxas de falso positivo. O MaSCoD, segundo o artigo, apresenta um perfil de retenção e seletividade que depende do dataset e do backbone, e não uma superioridade uniforme.
Contexto
A descoberta causal com LLMs avançou nos últimos anos, mas a maior parte da atenção foi para o julgamento de arestas, ou seja, a decisão final sobre cada relação. A etapa anterior, de montar o conjunto de hipóteses que serão julgadas, recebeu menos escrutínio. É aí que mora o risco: se uma relação verdadeira é descartada cedo, nenhuma etapa posterior consegue recuperá-la, porque ela simplesmente não está mais na lista.
O MaSCoD propõe inverter a ordem. Em vez de deixar o modelo decidir aresta por aresta e só então organizar o contexto, o framework faz a pré-organização estrutural primeiro. Duas variantes foram comparadas. Na Full, as hipóteses estruturais chegam antes do julgamento. Na No Phase 1, elas são construídas durante o julgamento. O artigo chama esse eixo de controle de omissão.
Os resultados adicionais são mais matizados do que um título de vitória sugere. A retenção extra de arestas de referência em relação a todas as baselines avaliadas apareceu em DWD com GPT-5.4 e em Sachs com GPT-4o, não em todos os cenários. Ablações parciais mostraram que fornecer os dois componentes de informação não superou sempre fornecer apenas um deles.
Por que importa
Para GPT-5.4, a análise por estágio mostrou que a diferença de retenção entre Full e No Phase 1 já estava presente logo após o julgamento de aresta direta. Além disso, a etapa de reconciliação introduziu perda adicional de arestas de referência para a variante Full no dataset Sachs. Ou seja, o ganho não se distribui de forma uniforme ao longo do pipeline, e uma etapa posterior pode desfazer parte do que a pré-organização preservou.
O ponto prático é o trade-off. Recuperar mais relações reais custa mais falsos positivos. Em aplicações em que perder uma causa verdadeira é pior do que carregar uma suspeita falsa, como triagem de hipóteses em pesquisa, esse perfil pode ser aceitável. Em aplicações que exigem precisão, o ganho de recall vem com um preço que precisa ser podado depois.
Impacto
O MaSCoD entrega menos um produto e mais um alvo de design e avaliação. A conclusão do artigo é que a pré-organização estrutural deve ser tratada como objetivo explícito de design e de medição para controlar omissão, e que a construção de contexto precisa ser avaliada em conjunto com a forma como esse contexto é usado no julgamento. Equipes que usam LLMs para mapear relações causais passam a ter uma métrica a mais: o que se perde antes do julgamento.
A dependência de backbone é outro recado. O GPT-5.4 e o GPT-4o produziram comportamentos distintos de retenção nos mesmos datasets, o que indica que a escolha do modelo pesa tanto quanto a arquitetura do framework. O GPT-4o, da OpenAI, replicou o experimento, mas não reproduziu os mesmos ganhos em todos os cenários.
O que muda
A comparação entre Full e No Phase 1 se estabelece como uma forma de medir controle de omissão. Em vez de olhar só a precisão final do grafo, a análise por estágio permite localizar onde as arestas de referência se perdem: na geração de hipóteses, no julgamento ou na reconciliação. Em Sachs, com GPT-5.4, a reconciliação foi justamente o ponto de perda.
A ablação parcial acrescenta um alerta contraintuitivo. Mais informação nem sempre é melhor. Fornecer os dois componentes de contexto não superou sempre fornecer apenas um, o que sugere que a forma de organizar o contexto importa mais do que o volume de contexto entregue ao modelo.
O que vem agora
O material disponível não informa publicação em conferência, disponibilização de código, dados ou nomes dos autores. O artigo está no arXiv como preprint submetido em 17 de setembro de 2026. O caminho natural é a revisão por pares e a replicação em outros backbones e outros conjuntos de dados, já que o próprio estudo mostra que o desempenho varia com o modelo e com o dataset.
Fontes
- arXiv cs.AI: MaSCoD: A Multi-Agent Framework for Structural-Context-Guided Candidate Causal Graph Generation (https://arxiv.org/abs/2609.19944)